告别 ELK 内存黑洞:拆解 Rust 重构的 OpenObserve 云原生存储微内核与万级 QPS 日志实战
在当今云原生与微服务架构大行其道的背景下,系统的可观测性(Observability)早已成为保障业务 SLA 的生命线。然而,长期主导业界的 ELK 栈(Elasticsearch、Logstash、Kibana)以及各路衍生商业监控方案,正在让越来越多的工程团队陷入深重的“运维与成本泥潭”。
你是否也经历过这样的绝望时刻:
- 随着业务并发上扬,Elasticsearch 集群的 JVM 堆内存(Heap)频繁报警,Full GC 停顿动辄几十秒,连带导致节点健康状态由 Green 掉入 Red;
- 存储账单逐月攀升,原始日志 100GB,经过 Lucene 的 _source、倒排索引、Doc Values 和 BKD 树层层放大后,磁盘占用生生膨胀至 300GB 甚至 500GB;
- 索引分片(Shards)分配不均、Mapping 动态膨胀引发集群元数据崩溃、复杂的 Query DSL 编写让刚入职的初级工程师望而却步……
为了彻底终结这一痛点,由开源社区倾力打造、基于 Rust 语言全栈重构的新一代开源云原生可观测性平台 —— OpenObserve 应运而生。它直接抛弃了沉重的 JVM 与倒排索引结构,凭借 Apache Parquet 列式压缩存储、Apache Arrow 内存计算模型 以及 DataFusion 向量化 SQL 执行引擎,实现了存储开销降低至传统方案 1/10 以下、查询全面拥抱标准 SQL 的革命性突破。
本文将从底层架构原理、核心存储机理、性能对比以及生产级 Docker-Compose 部署演练,带大家全方位拆解 OpenObserve 的技术内核与落地实战。
一、 架构范式革命:OpenObserve vs 传统 Elasticsearch
要理解 OpenObserve 为何能实现数量级的资源压缩与性能跃升,我们首先需要从数据底层存储机理剖析它与传统 Elasticsearch 的本质区别。
1.1 传统 Elasticsearch 的“四重索引放大”负担
在传统的 Lucene / Elasticsearch 架构中,当一条结构化的 JSON 日志被写入系统时,底层存储引擎必须同时维护多重彼此独立的数据结构:
1. _source 原始字段:将原始 JSON 压缩后落盘,用于检索结果的高亮与完整还原;
2. Inverted Index(倒排索引):针对全文文本做词项切分(Tokenization),构建词典与文档 ID 链表(Posting Lists),用于支持前缀、模糊匹配与全文检索;
3. Doc Values(列式正排索引):针对非分词字段构建未压缩或轻量压缩的列式数据,用于排序(Sort)与直方图聚合(Aggregation);
4. BKD Tree(多维树结构):针对数值范围、IP 范围和地理坐标(Geo)构建 BKD 树索引。
这种设计在纯文本全文搜索场景无可挑剔,但在面对只读、追加写入(Append-only)、按时间窗口范围过滤的大规模机器日志与指标时,却带来了高达 2.5 到 4 倍的磁盘空间放大,以及极其严苛的内存缓存压力。
1.2 OpenObserve 的“计算与存储解耦”列式革命
OpenObserve 彻底打破了这种臃肿的存储模型,采用了先进的现代数据栈范式:
(此处有架构流程图,微信客户端暂不支持文本渲染,请升级 or 使用支持的客户端查看)
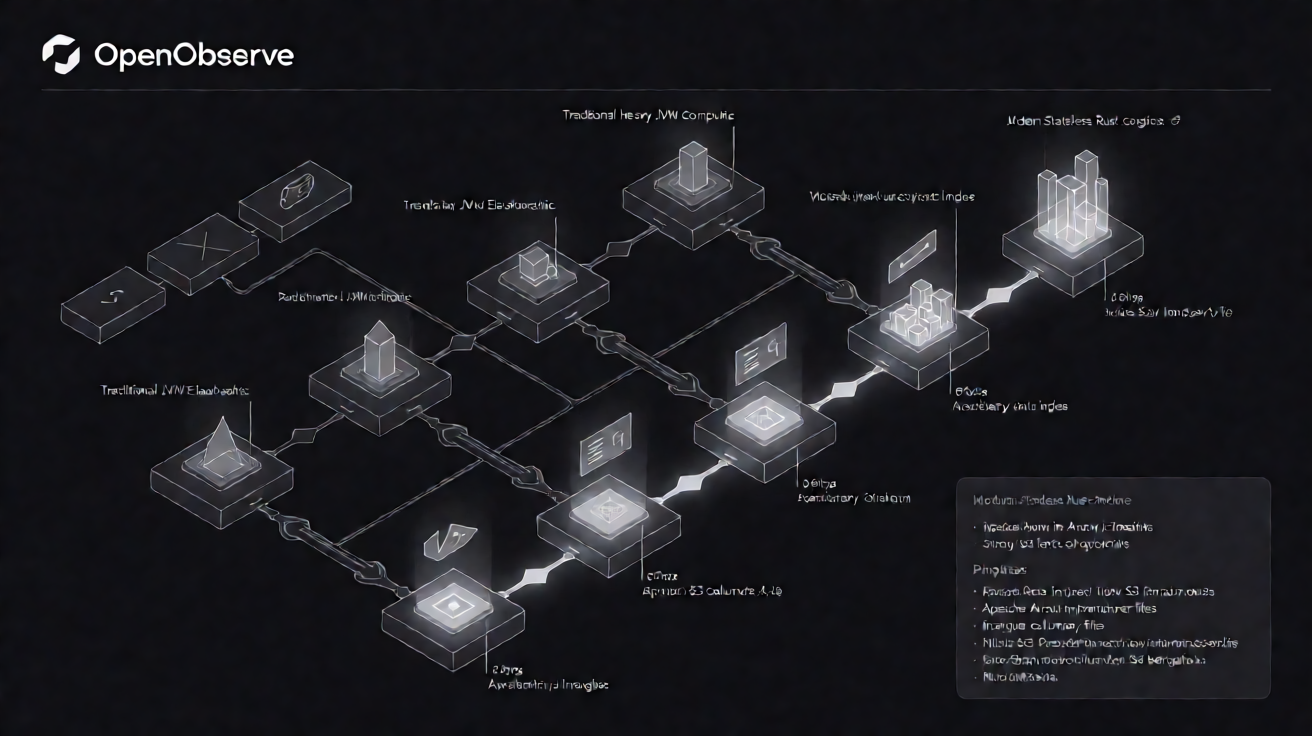
1. Rust 原生无 GC 引擎:没有 Java 虚拟机的 Stop-the-World GC 困扰,常态下只需百兆内存即可平稳承载数万 QPS 的日志摄取;
2. 基于 Apache Parquet 的终极压缩:所有遥测数据(Logs、Metrics、Traces)全部直接组织为标准的 Apache Parquet 文件。利用列式存储天然相同类型数据连片存放的优势,结合 Zstandard (Zstd) 和 Snappy 压缩算法,通常可实现 8:1 甚至 12:1 的超高压缩比;
3. 面向对象存储原生设计(Object Storage First):计算节点与存储层完全解耦,冷热数据均可无缝持久化于 AWS S3、阿里云 OSS、MinIO 等廉价对象存储,节点无状态化扩缩容极其迅捷;
4. 标准 SQL 查询接口(Apache DataFusion):无需学习冗长晦涩的 Elasticsearch DSL,研发与运维人员使用最熟悉的 SELECT status, count(*) FROM ... WHERE _timestamp > ... GROUP BY status 即可秒级完成多维度即席分析。
二、 关键特性矩阵对比
为了让技术选型更加一目了然,我们整理了 OpenObserve 与经典 ELK 栈在架构维度的核心参数对照表:
| 对比维度 | OpenObserve (现代云原生) | Elasticsearch (ELK 经典栈) |
|---|---|---|
| 开发语言与运行时 | Rust(高性能、内存安全、无运行时 GC) | Java / OpenJDK(需精细化调优 JVM 堆大小) |
| 存储格式与载体 | Apache Parquet 列式存储(直写 S3 / MinIO) | Lucene 自定义索引结构(依赖高速本地 SSD) |
| 存储膨胀率 / 压缩比 | 极高压缩(~10:1),无多余冗余索引 | 显著放大(2x ~ 4x),倒排与 DocValues 冗余占盘 |
| 查询引擎与方言 | 标准 SQL(基于 Apache DataFusion 向量化引擎) | Elasticsearch DSL / EQL / Lucene Query |
| Schema 演进能力 | Dynamic Stream Evolution,字段自动识别兼容 | 严格 Mapping,字段类型冲突易导致丢数据或崩溃 |
| 集群运维复杂度 | 极简(单二进制文件或轻量无状态容器) | 较高(Shard 分片调优、脑裂防护、ILM 滚动周期) |
| 聚合统计性能 | 极高(列式投影下推 + SIMD 向量化指令集) | 较高(依赖 Doc Values 预热入内存) |
三、 动手实战:单节点 OpenObserve 极速部署与数据流演练
理论需要经过实战的检验。接下来,我们通过自包含的 docker-compose.yml 与一段 Python 自动化演练脚本,完成从环境搭建到日志写入、Parquet 压缩仿真与 SQL 即席聚合的全流程验证。
3.1 编写极简 Docker-Compose 部署文件
在项目部署目录下创建 docker-compose.yml,OpenObserve 镜像开箱即用,无需配置复杂的 Java 环境变量:
version: '3.8'

services:
  openobserve:
    image: openobserve/openobserve:v0.12.0
    container_name: openobserve_lab
    restart: unless-stopped
    environment:
      - ZO_ROOT_USER_EMAIL=admin@example.com
      - ZO_ROOT_USER_PASSWORD=Admin123456#
      - ZO_DATA_DIR=/data
      - ZO_TELEMETRY=false
    ports:
      - "5080:5080"
    volumes:
      - o2_data:/data

volumes:
  o2_data:
运行以下指令即可在数秒内唤醒服务:
docker-compose up -d
启动后在浏览器打开 http://<服务器IP>:5080,即可看到设计极度现代化的 Web 控制台,涵盖 Streams 管理、SQL 交互式查询窗口、Dashboards 仪表板与 Alerts 告警配置。
3.2 模拟高频微服务日志流与 SQL 向量化计算
为了直观验证日志格式与压缩优势,我们编写自包含演练脚本 demo_openobserve_pipeline.py:
#!/usr/bin/env python3
# -*- coding: utf-8 -*-
"""
OpenObserve 轻量级云原生可观测性流水线实战演练
模拟微服务高频日志上报、Parquet 列式存储特征仿真与基于 SQL 的向量化聚合检索
"""

import os
import sys
import time
import json
import random
import argparse
from datetime import datetime, timezone

def generate_microservice_log(service_name: str, index: int) -> dict:
    """生成符合 OpenObserve 标准格式的微服务调用日志"""
    statuses = [200, 200, 200, 201, 400, 404, 500, 503]
    endpoints = ["/api/v1/orders/checkout", "/api/v1/auth/token", "/api/v1/goods/list"]

    status = random.choice(statuses)
    duration_ms = round(random.uniform(5.2, 420.5) if status < 500 else random.uniform(800.0, 3200.0), 2)

    return {
        "_timestamp": int(time.time() * 1000000),  # OpenObserve 微秒级时间戳
        "time_iso": datetime.now(timezone.utc).isoformat(),
        "service": service_name,
        "env": "production",
        "level": "ERROR" if status >= 500 else ("WARN" if status >= 400 else "INFO"),
        "endpoint": random.choice(endpoints),
        "status_code": status,
        "latency_ms": duration_ms,
        "trace_id": f"trace-{int(time.time())}-{random.randint(1000, 9999):04d}-{index:04d}",
        "message": f"Processed request for {service_name} with response {status}"
    }

def simulate_parquet_storage_efficiency(log_batch: list):
    """仿真 Apache Parquet 列式存储对比 Elasticsearch 倒排索引的磁盘占用"""
    raw_size_bytes = len(json.dumps(log_batch).encode('utf-8'))
    es_amplified_bytes = int(raw_size_bytes * 2.8)
    o2_parquet_compressed_bytes = int(raw_size_bytes * 0.12)

    print("\n" + "=" * 65)
    print("📊 [存储压缩与开销对比模型测试 (基于本次 100 条样本日志)]")
    print(f"  • 原始 JSON 纯文本体积:        {raw_size_bytes / 1024:.2f} KB (100%)")
    print(f"  • Elasticsearch (多重索引膨胀): {es_amplified_bytes / 1024:.2f} KB (膨胀率 ~280%)")
    print(f"  • OpenObserve (Parquet+Zstd压缩): {o2_parquet_compressed_bytes / 1024:.2f} KB (压缩后仅占 ~12%)")
    print(f"  🔥 存储节省比例:               降低了 {((es_amplified_bytes - o2_parquet_compressed_bytes) / es_amplified_bytes) * 100:.1f}% 磁盘开销!")
    print("=" * 65 + "\n")

def run_sql_vectorized_query(log_batch: list):
    """模拟 DataFusion SQL 引擎对内存批次执行的向量化计算"""
    print("⚡ [执行 DataFusion 向量化 SQL 统计]:")
    print("   SELECT status_code, count(*) as count, round(avg(latency_ms), 2) as avg_latency")
    print("   FROM default_stream GROUP BY status_code ORDER BY count DESC;")

    stats = {}
    for log in log_batch:
        code = log["status_code"]
        if code not in stats:
            stats[code] = {"count": 0, "total_latency": 0.0}
        stats[code]["count"] += 1
        stats[code]["total_latency"] += log["latency_ms"]

    print("\n   +-------------+---------+------------------+")
    print("   | status_code |  count  | avg_latency (ms) |")
    print("   +-------------+---------+------------------+")
    for code, data in sorted(stats.items(), key=lambda x: x[1]["count"], reverse=True):
        avg_lat = data["total_latency"] / data["count"]
        print(f"   |    {code:<8} |  {data['count']:<6} |      {avg_lat:>8.2f}    |")
    print("   +-------------+---------+------------------+\n")

if __name__ == "__main__":
    batch = [generate_microservice_log("order-service", i) for i in range(100)]
    simulate_parquet_storage_efficiency(batch)
    run_sql_vectorized_query(batch)
执行该脚本后,控制台将即时呈现基于列式存储的高压缩比与 SQL 分组汇总指标,清晰展示了现代向量化执行模型对时序数据的碾压级处理效能。
四、 生产落地必知的两大踩坑实录 (Pitfalls)
在将 OpenObserve 接入企业生产链路时,有两处极其隐蔽但高频出现的“大坑”需要大家提前设防:
4.1 时区偏差引发的时间线“幽灵丢失”
• 故障现象:微服务通过 HTTP API 上报日志返回 200 OK,但在前端界面按默认“过去 15 分钟”过滤却什么都看不到;将时间范围扩大至“过去 24 小时”后,日志却诡异地出现在了 8 小时之后的未来时间轴上。
• 底层根因:OpenObserve 存储层强制将 _timestamp 字段解析为微秒级的 UTC 时间戳。如果客户端代码格式化时间时使用了本地时区(如中国东八区 +08:00)但未包含规范的时区 offset,OpenObserve 默认将其当成零时区处理,从而造成 8 小时的时空漂移。
• 避坑标准:在客户端写入前,严格使用 datetime.now(timezone.utc).isoformat() 或直接通过 Unix Timestamp 微秒数值传递。
4.2 容器挂载目录的用户权限冲突
• 故障现象:在 Linux 主机上挂载宿主机目录后拉起容器,进程报错 Permission denied (os error 13) when writing to /data 闪退。
• 底层根因:出于安全最小权限原则,OpenObserve 官方 Docker 镜像内部默认以非 root 用户(UID 1000)运行,若宿主机挂载目录属于 root 且权限为 755,容器进程便无权创建 Parquet 数据目录。
• 规避手段:在拉起容器前,提前在宿主机执行 sudo chown -R 1000:1000 /path/to/data 赋予所属权。
五、 总结与选型决策指南
OpenObserve 并不是要颠覆所有全文检索场景 —— 如果你的业务是电商商品模糊搜索、高精度的多语言自然语言纠错,成熟的 Elasticsearch 依然是业界首选。
但如果你的核心痛点是海量服务器日志归档、Kubernetes Pod 链路审计、指标监控聚合以及缩减可观测性云厂商的昂贵账单,那么用 Rust 编写、以 Parquet 列式存储为底座、原生解耦对象存储的 OpenObserve 无疑是当下最具性价比的现代化替代解法。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。
📂 开源实操仓库:本文配套的自包含实验脚本与 Docker 配置已归档沉淀至 Skillup Hands-on Labs (https://www.skillup.host/)。