把整本技术书炼成 AI 的随身军师!开源 book-to-skill 知识编译实战:零幻觉、秒检索与 50 倍 Token 降本
作为开发者,我们手头往往积累了大量的技术硬核书籍(如《Design Data-Intensive Applications》、《Operating Systems: Three Easy Pieces》或《Rust 权威指南》)。
当我们在写代码遇到难题想请教 AI 时,传统的做法无非两种:
1. 硬吞大文件:把整本 20 万 Token 的 PDF / EPUB 强行拖进 AI 聊天框。不仅产生天价 Token 账单,大模型在漫长文本中还极易“胡言乱语”、产生严重幻觉。
2. 零散搜索 (RAG):切成几百字的小片段。检索出来的结果断章取义,完全丢掉了整本书的系统化逻辑。
有没有一种方案,能将整本大部头书籍“编译”为 AI 随时调用的模块化 Agent Skill?
开源项目 book-to-skill 彻底攻克了这一难题!它通过“知识编译 (Knowledge Compilation)”范式,把任何书籍无缝转化为适配 Claude Code、Cursor 与 OpenClaw 的 Agent Skill。
1. 核心架构:知识编译 (Knowledge Compilation) 结构
与简单拼接或文本切块不同,book-to-skill 将书籍重构为一个具备“渐进式披露”特性的模块化目录树。
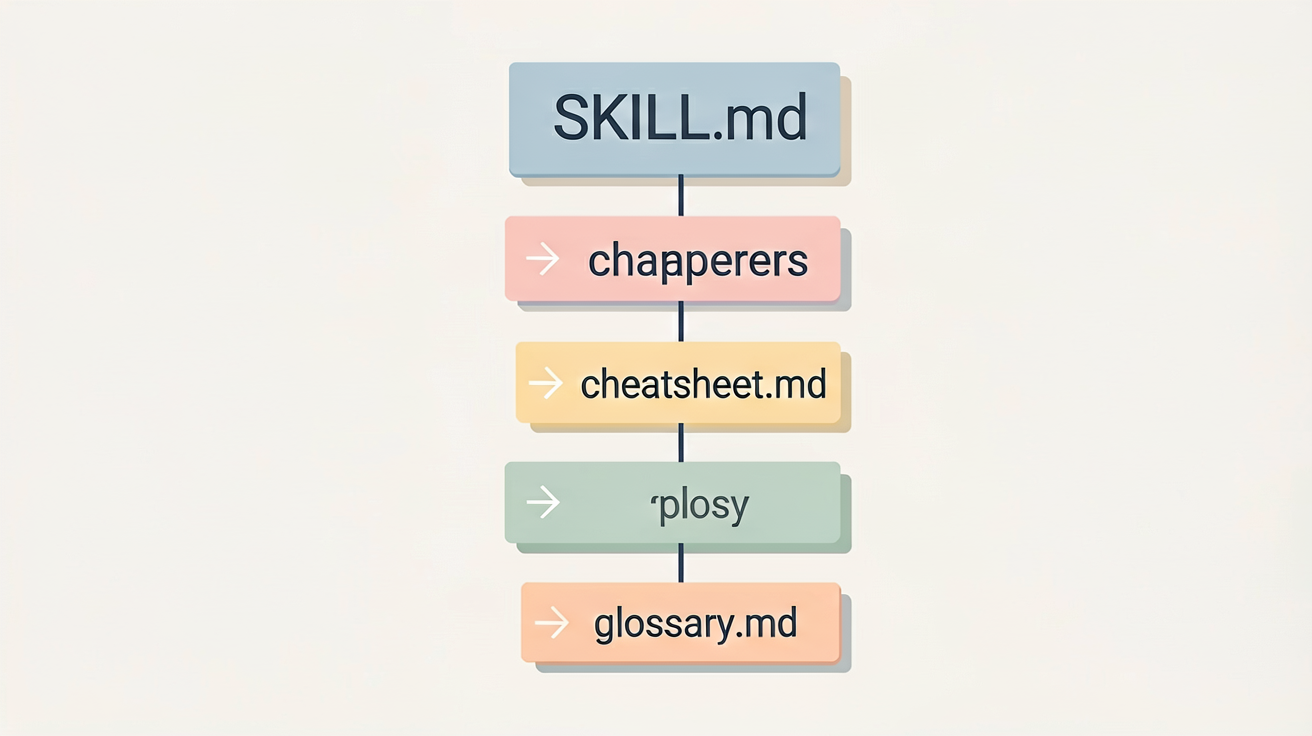
1.1 编译后的标准 Skill 目录结构
my-tech-book-skill/
├── SKILL.md          # 核心心智模型、总体知识图谱与章节索引 (仅占 3,000 Tokens)
├── chapters/         # 按章节精细拆分的知识大纲与核心法则
│   ├── ch01-basics.md
│   ├── ch02-architecture.md
│   └── ch03-performance.md
├── cheatsheet.md     # 快速速查表 (API 签名、核心命令行、速记表)
├── patterns.md       # 书中涵盖的经典设计模式与工程算法
└── glossary.md       # 专业术语表与名词解释
2. 传统 PDF 直接喂入 vs book-to-skill 范式对比
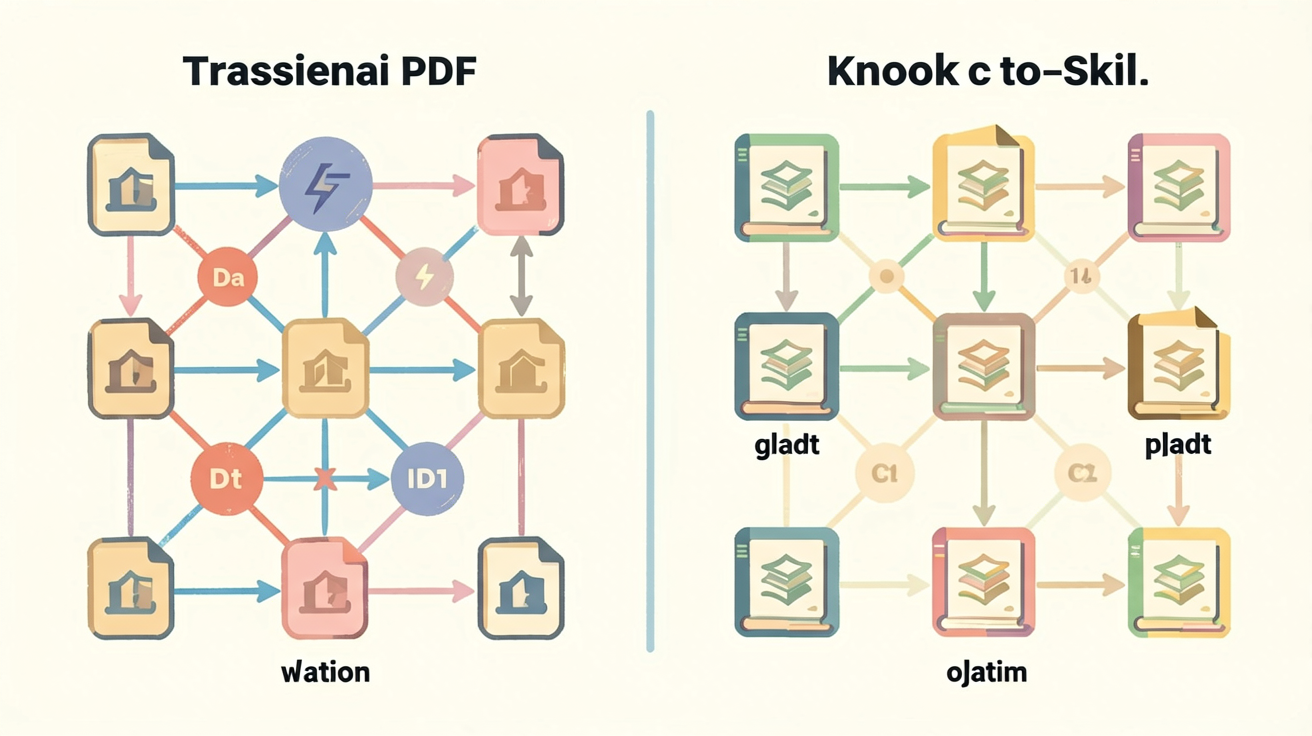
我们将 直接喂入大部头 PDF 与 book-to-skill 知识编译 进行了多维技术对比:
| 对比维度 | 直接喂入大部头 PDF / EPUB | book-to-skill 知识编译范式 |
|---|---|---|
| Token 消耗 | 极其昂贵 (一次性耗费 10万~30万 Tokens) | 极低 (主索引仅占 3,000 Tokens,节省 50 倍) |
| 幻觉率 (Hallucination) | 高 (庞大长文本导致注意力涣散) | 极低 (根据 SKILL.md 精准定位章节按需读取) |
| 上下文完整性 | 弱 (RAG 切片断章取义) | 极强 (保留全书逻辑脉络与章节目录树) |
| Agent 复用度 | 一次性对话用完即废 | 标准目录包,可在所有项目与 Agent 中复用 |
3. 实战指南:三步把一本 PDF / EPUB 变成 AI 随身军师
3.1 步骤一:格式清洗 (使用 MinerU)
如果是带有复杂公式、表格或论文样式的 PDF,推荐先使用开源解析工具 MinerU(上海人工智能实验室出品)将其精准转换为干净无瑕的 Markdown。
# 安装并运行 MinerU 解析 PDF
pip install mineru
magic-pdf -p my_book.pdf -o ./markdown_output/
3.2 步骤二:使用 book-to-skill 自动编译
通过全局 CLI 运行 book-to-skill,自动对清洗后的 Markdown 电子书进行结构化提炼:
# 全局安装 book-to-skill
npx skills add virgiliojr94/book-to-skill

# 运行知识编译命令
book-to-skill build --input ./markdown_output/my_book.md --name "ddia-book-skill" --output ~/.gemini/config/skills/
3.3 步骤三:在 Agent 中精准调用
在 Claude Code、Cursor 或自带 Skill 的 Agent 中,大模型会根据你的提问自动激活对应的 SKILL.md 索引:
User: "帮我用 Rust 实现 DDIA 第三章里提到的 LSM-Tree 跳表并发写入逻辑"

Agent: [激活 ddia-book-skill]
Agent: [定位索引 SKILL.md ➔ 动态读取 chapters/ch03-storage-engines.md]
Agent: 根据 DDIA 第三章 LSM-Tree 存储引擎规范,我们应当分成 SSTable 与 MemTable 两部分...
4. 落地避坑与版权合规提醒
⚠️ 1. DRM 版权移除与合法合规
如果是从 Kindle 或电子书商城购买的 EPUB/PDF,转换前需确保仅用于个人学习与私有 Agent 研读。切勿在公共 GitHub 仓库传播有版权保护的书籍 Skill。⚠️ 2. 掌握
cheatsheet.md与glossary.md的精髓
在生成 Skill 时,一定要让 Agent 自动抽离出专门的速查表(Cheatsheet)。写代码时,AI 查询 Api 和函数签名的速度将提升 10 倍!
5. 总结
book-to-skill 代表了“上下文工程”与知识管理的最新方向。它把原本呆板、沉睡在大文本里的书籍知识,编译成了灵活、高效、随时按需调用的 AI 军师。
如果你也有许多一直没时间读完的技术好书,不妨用这套工具链把它们全编译成你的专属 AI 技能包!
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: