ThinkWiki 开源!爆火的 LLM Wiki 范式,我做成了本地知识库 Agent Skill
过去一年,几乎每个做 AI 开发的朋友都搭过 RAG(检索增强生成)知识库。但在真实落地中,传统 RAG 经常面临一个尴尬的困境:“每次提问都从零切片搜索,知识永远是散乱的死文件;文档越多,越难形成系统化的认知链条。”
针对这一工程痛点,大模型先驱 Andrej Karpathy 提出了全新的 LLM Wiki 方法论——倡导让 AI Agent 将原始素材“编译”为可自我演进、互联互通的个人与企业 Wiki。
今天,我们正式将这一方法论工程化落地,并开源了 ThinkWiki 项目!它不仅是一个本地优先的知识库工具,更是一个开箱即用的 Agent Skill。通过自然语言对话,你就能让 Claude Code、Cursor、OpenClaw 等 Agent 替你自动消化网页、论文与代码,持续编译出越用越聪明的“数字第二大脑”。
1. 为什么是 LLM Wiki?传统 RAG vs 编译式知识库
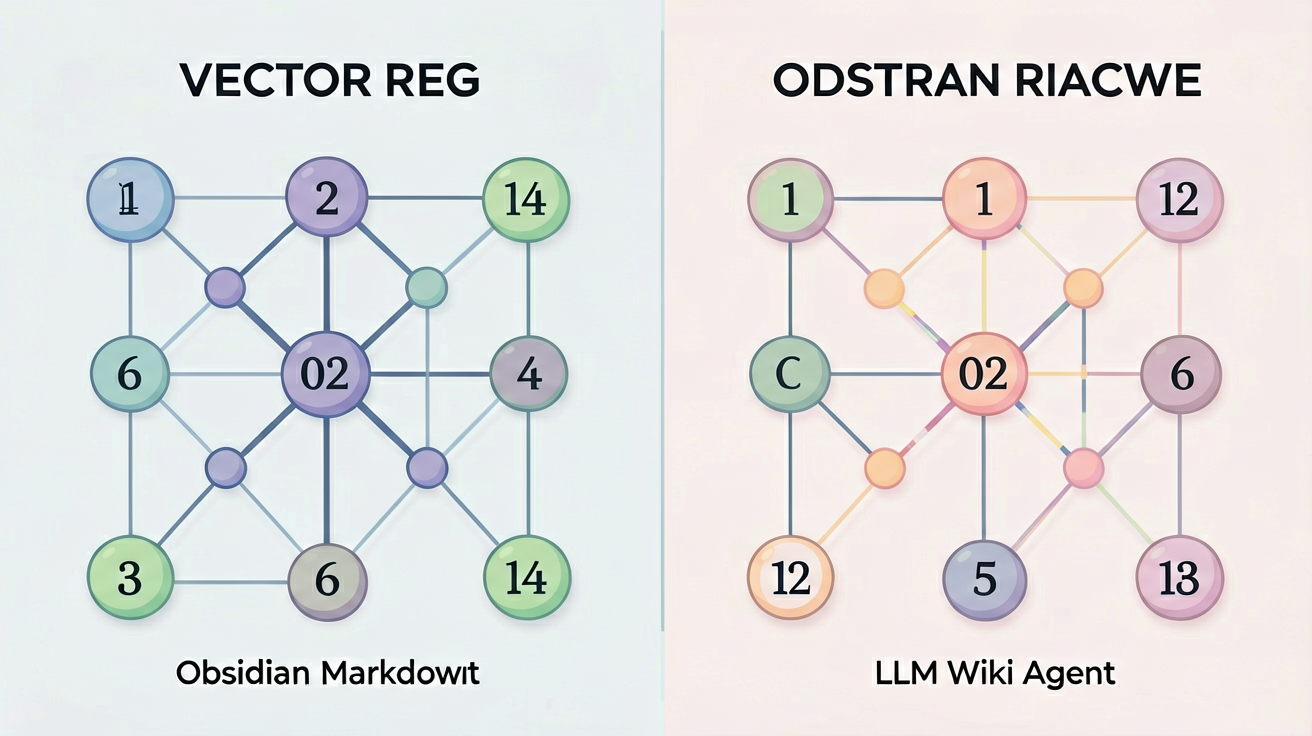
为了搞清楚 ThinkWiki 的技术突破,我们需要先对比传统 RAG 与 LLM Wiki 的底层架构差异。
1.1 传统 RAG 的“零散搜索”瓶颈
- 离线切片局限:传统 RAG 将 PDF/网页强行切成 512 Token 的 Chunk。切片之间缺乏上下文关联,导致大模型无法跨章节理解项目全貌。
- 无知识复利:每次用户提问,系统都临时做 Embedding 检索。回答结束后,LLM 总结出的真知灼见随之挥发,无法沉淀回知识库本身。
1.2 LLM Wiki 的“编译与演进”范式
- 编译式提取 (Compiled Extraction):当输入新文章或网页时,Agent 会像编译器一样解析出“实体 (Entity)”、“核心概念 (Concept)”和“推理链条 (Logic Chain)”。
- 双向链条与知识演进:新知识会自动与已有的本地 Markdown 页面建立 Wikilink(如
[[RAG 架构]]、[[Vector Search]]),实现知识粒度越丰富、检索越精准的复利效应。
2. ThinkWiki 的核心架构与 Agent Skill 设计
ThinkWiki 的设计理念是 “本地优先 (Local-First) + Agent 驱动”。整个系统完全基于纯文本 Markdown 构建,无需额外部署复杂的图数据库或向量服务。
[原始素材: 网页 / PDF / 代码 / 笔记]
                  │
                  ▼ (Agent 自然语言指令: "消化此链接/文件")
┌─────────────────────────────────────────────────────────┐
│              ThinkWiki Agent Skill 核心引擎             │
│                                                         │
│   ├── 1. Entity & Concept Extraction (实体概念抽取)       │
│   ├── 2. Incremental Wiki Compilation (增量编译)         │
│   └── 3. Bi-directional Linker (双向链接与健康校验)        │
└─────────────────────────────────────────────────────────┘
                  │
                  ▼ (纯本地 Markdown 文件夹)
┌─────────────────────────────────────────────────────────┐
│               ThinkWiki 本地知识库工作区                │
│                                                         │
│   ├── index.md (主索引与大纲)                            │
│   ├── pages/ (概念与实体结构化页面)                     │
│   └── graph.html (交互式数字山水语义图谱)               │
└─────────────────────────────────────────────────────────┘
2.1 核心命令与 Skill 操作流
ThinkWiki 作为标准 Agent Skill,内置了极简的自然语言指令接口:
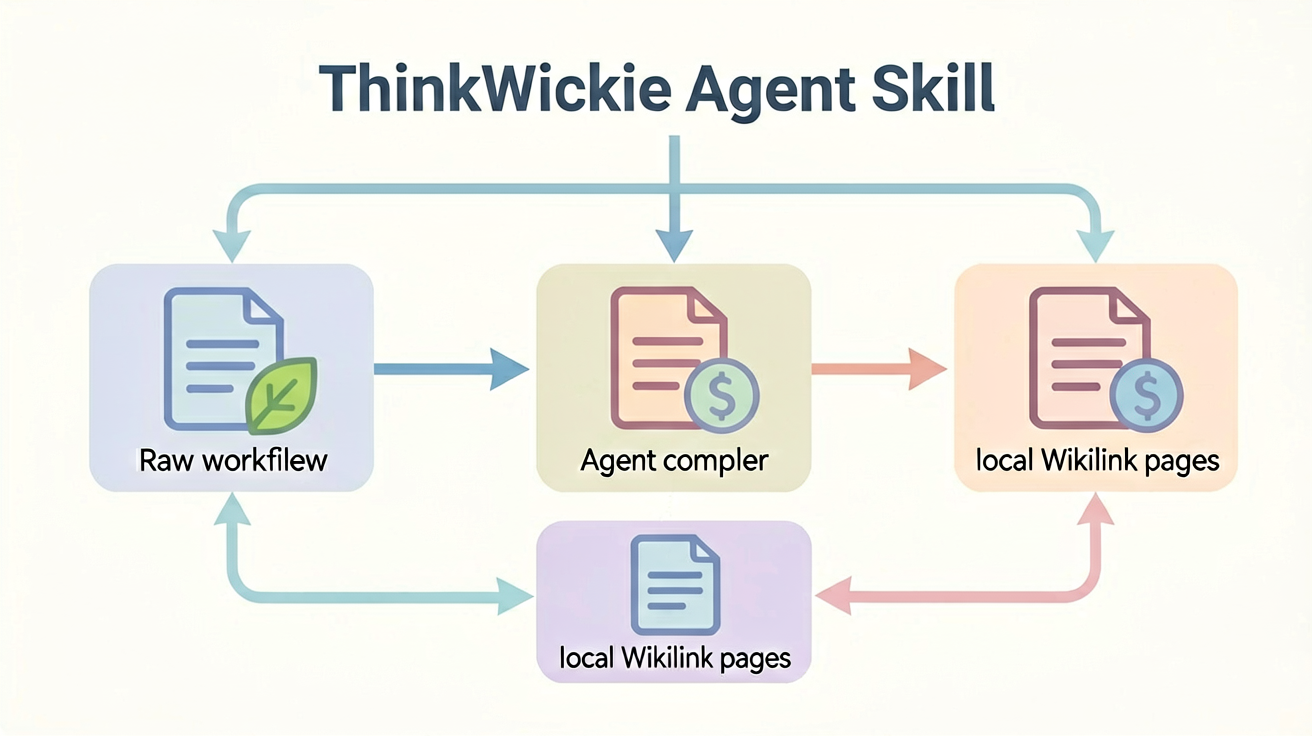
1. thinkwiki init:初始化本地知识库工作区与目录结构;
2. thinkwiki ingest <URL/File>:自动抓取源内容,消化并增量写入对应的实体 Markdown 页面;
3. thinkwiki lint:自动扫描知识库中的悬空链接、重复实体与孤立节点,进行健康度修复;
4. thinkwiki graph:自动生成可视化 HTML 交互式语义关系图谱。
3. 三大知识库范式多维度对比
为了方便开发者进行技术选型,我们将 传统向量 RAG、Obsidian 手动双链 与 ThinkWiki (LLM Wiki Agent) 进行了多维对比:
| 对比维度 | 传统纯向量 RAG | Obsidian 手动双链 | ThinkWiki (LLM Wiki Agent) |
|---|---|---|---|
| 知识构建成本 | 低 (全自动切片) | 极高 (需要人工手动整理 Markdown) | 极低 (Agent 自动编译整理) |
| 知识结构化程度 | 散乱 (无整体视图) | 高 (依赖人工打标签) | 极高 (Agent 自动提取实体与关系) |
| 多跳推理能力 | 较差 (易断链) | 强 (依赖人工路径) | 极强 (基于 Wikilink 与结构化关联) |
| 数据隐私与本地化 | 视部署情况而定 | 100% 本地纯文本 | 100% 本地纯文本,零依赖 |
| Agent 可读性 | 弱 (仅得到切片文本) | 中等 | 原生 Agent 友好,包含完整上下文 |
4. 落地实战:Python 极速体验 ThinkWiki 编译流程
下面我们使用 Python 演示一个简易的 ThinkWiki 增量知识编译与 Wikilink 生成 Engine:
import os
import re
from openai import OpenAI

# 初始化 LLM Client
client = OpenAI(base_url="http://127.0.0.1:8045/v1", api_key="sk-b2674a9e6c2f4e53ae3e376c49a10e4f")

def compile_thinkwiki_page(raw_text: str, wiki_dir: str = "./thinkwiki_workspace"):
    """
    ThinkWiki 核心处理流:从原始文本中提取实体与概念,生成结构化 Markdown 页面
    """
    os.makedirs(os.path.join(wiki_dir, "pages"), exist_ok=True)

    prompt = f"""
你是一个专业的 ThinkWiki 知识库编译 Agent。请分析以下原始输入文本,完成两项任务:

1\. 提取出 3-5 个核心技术实体(Entity)或概念(Concept);

2\. 将输入内容重构成一篇包含 Wikilink 双向链接(格式如 [[概念名]])的结构化 Markdown。

原始文本:
{raw_text}
"""

    response = client.chat.completions.create(
        model="claude-3-5-sonnet",
        messages=[{"role": "user", "content": prompt}],
        temperature=0.3
    )

    compiled_md = response.choices[0].message.content

    # 自动保存编译后的主页面
    output_path = os.path.join(wiki_dir, "pages", "compiled_entry.md")
    with open(output_path, "w", encoding="utf-8") as f:
        f.write(compiled_md)

    print(f"[✓] 知识编译完成!已写入 ThinkWiki 工作区: {output_path}")
    return compiled_md

if __name__ == "__main__":
    sample_text = """
    WeKnora 是腾讯开源的端到端文档理解与 RAG 框架。它基于改造自 Chromium 的 IMA 内核,
    支持浏览器级多模态解析,并落地了父子分块(Parent-Child Chunking)算法。
    """
    compile_thinkwiki_page(sample_text)
5. 生产落地建议与避坑指南
在将 ThinkWiki 引入团队或个人工作流时,建议注意以下边界规则:
⚠️ 1. 定期执行
thinkwiki lint保持健康度
随着 Agent 消化素材增多,可能会产生重名实体(如[[RAG]]与[[检索增强生成]])。必须定期让 Agent 执行健康检查与实体归并。⚠️ 2. 控制单页 Markdown 粒度
概念页应当“少而精”,围绕单一主题展开。避免让 Agent 将成千上万字的原始 PDF 堆砌在一个 Markdown 中,保持清晰的 Wiki 结构。⚠️ 3. 搭配纯文本 Git 托管
由于 ThinkWiki 产出的全部是标准.md文件,强烈建议使用 GitHub / GitLab 私有仓库进行版本管理,轻松实现多人协作与增量追溯。
6. 总结
Andrej Karpathy 提出的 LLM Wiki 正在掀起下一代知识管理的革命。ThinkWiki 将这一先进范式封装为标准的 Agent Skill,让大模型从“单次问答工具”升级为“可自我演进的知识库伴侣”。
如果你也苦于散乱的 PDF 和永远整理不完的笔记,不妨试试 ThinkWiki,体验 AI 编译带来的知识复利!
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: