RAG 挨骂三年,企业为何还在加码?向量检索 × 图谱 × LLM Wiki 三层架构讲透
「RAG 已死」「Chunk 检索是上古方案」——这类论调在 2024–2026 年的技术圈里几乎没断过。可如果你去看真实的企业招标与 POC 清单,向量检索 + 知识库 依然是私有化大模型落地的第一选项;区别只是:大家不再满足于「切文档 + TopK」,而是开始叠加 知识图谱(GraphRAG) 和 LLM Wiki 做分层。
这篇文章不讲情绪,只讲工程:普通 RAG、图谱 RAG、LLM Wiki 各自解决什么问题、怎么组合、选型时别踩哪些坑。
一、为什么大模型离不开外部知识?
LLM 再强,也有四条硬约束:
1. 不知道你的私有数据(内规、接口文档、工单、代码注释)
2. 知识会过期(训练 cutoff 之后的新政策、新 API)
3. 会幻觉(缺依据时编造得一本正经)
4. 上下文不是免费午餐(全量塞文档又贵又噪)
所以主流路径仍是:先检索,再生成(RAG)。争议不在「要不要检索」,而在 检索的组织方式 够不够。
二、普通 RAG:覆盖率担当,但不是银弹
2.1 标准流水线
原始文档 → 清洗切分(Chunk) → Embedding → 向量库
用户提问 → 问题向量化 → TopK 相似 Chunk → 拼 Prompt → LLM 回答
典型参数:chunk_size 500–1000、overlap 100–200、top_k 3–10,向量库可选 Milvus / Qdrant / Weaviate / pgvector 等。
2.2 优点
| 维度 | 说明 |
|---|---|
| 上手成本 | 概念简单,LangChain / LlamaIndex 模板多 |
| 非结构化友好 | PDF、Word、网页、Markdown 直接吃 |
| 实时性好 | 新文档 embedding 入库即可检索 |
2.3 典型失效场景
- 跨文档关系题:「A 系统故障会不会影响 B 客户 SLA?」——Chunk 相似度未必能串起链路
- 全局归纳题:「过去三年架构演进主线是什么?」——向量检索偏向局部片段
- 无状态重复劳动:昨天查过的核心结论,今天仍从零 chunk 拼凑(Karpathy 等讨论的痛点)
社区常说「RAG 失效」,很多时候是 把 RAG 当终局,而不是当 召回层。
三、GraphRAG / 知识图谱 RAG:补「关系」与多跳推理
图谱方案在索引阶段做 实体抽取 + 关系抽取,查询时沿子图扩展,而不是只比 embedding 相似度。

适合:
- 因果溯源、依赖链、风险传导
- 多跳问答(「谁批准了 → 影响了 → 哪些下游」)
- 需要 可解释路径 的合规/运维场景
代价:
- 建图与 实体消歧 成本高
- 图谱陈旧速度与文档更新不同步时要维护 pipeline
- 小团队 POC 容易「图有了,推理没提升」
工程上常见落地形态包括 LightRAG(local / global / mix 双层检索)、Microsoft GraphRAG 思路,以及 KnowLion 等 HyperGraphRAG 多路召回融合方案。
四、LLM Wiki:把碎片沉淀成「可维护的知识页」
LLM Wiki 的核心不是「再建一个向量库」,而是:
用 LLM 把原始资料编译成主题化 Wiki 页(摘要、概念、关系、来源、版本),查询时优先命中高质量页面,而不是每次从 chunk 现拼。
对比:
| 普通 RAG | LLM Wiki | |
|---|---|---|
| 知识单元 | 原始 Chunk | 主题页 / 概念页 |
| 更新方式 | 重切分 + 重 embedding | 增量修订 Wiki、记录矛盾 |
| 优势 | 覆盖广、实现快 | 精度高、可积累、可治理 |
| 短板 | 关系弱、无沉淀 | 构建慢、覆盖依赖摄入质量 |
53AI 等团队的实测结论很有参考价值:纯 Wiki 覆盖率可能只有 ~15% 核心域,但精度极高;纯 RAG 覆盖率 100% 但重复劳动多。 务实架构是 Wiki 优先 + RAG 兜底。
五、三层混合架构:2026 年更常见的「终局」形态
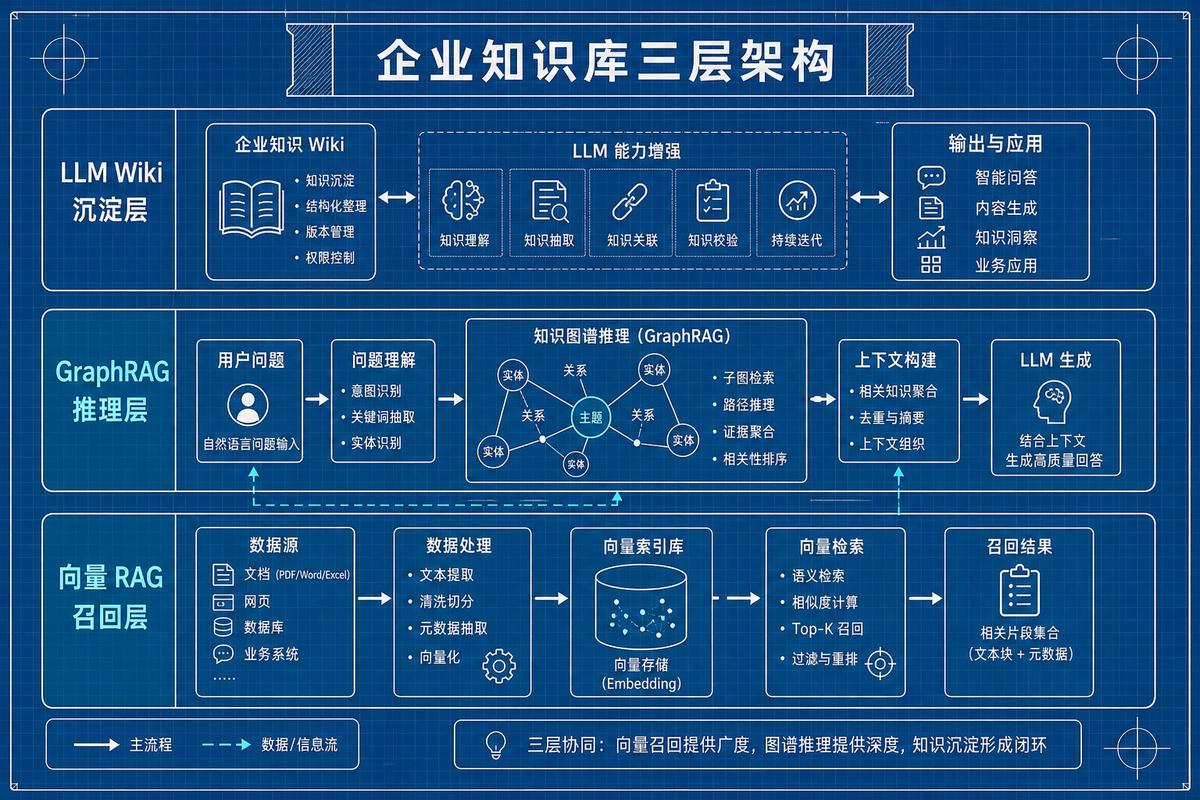
越来越多生产方案采用分层,而不是三选一:
┌─────────────────────────────────────────┐
│  LLM Wiki 层:核心概念、规范、对比总结   │  ← 精度 / 沉淀
├─────────────────────────────────────────┤
│  GraphRAG 层:实体关系、多跳、因果链     │  ← 推理 / 可解释
├─────────────────────────────────────────┤
│  向量 RAG 层:全量文档、长尾、新上传文件   │  ← 召回 / 覆盖
└─────────────────────────────────────────┘
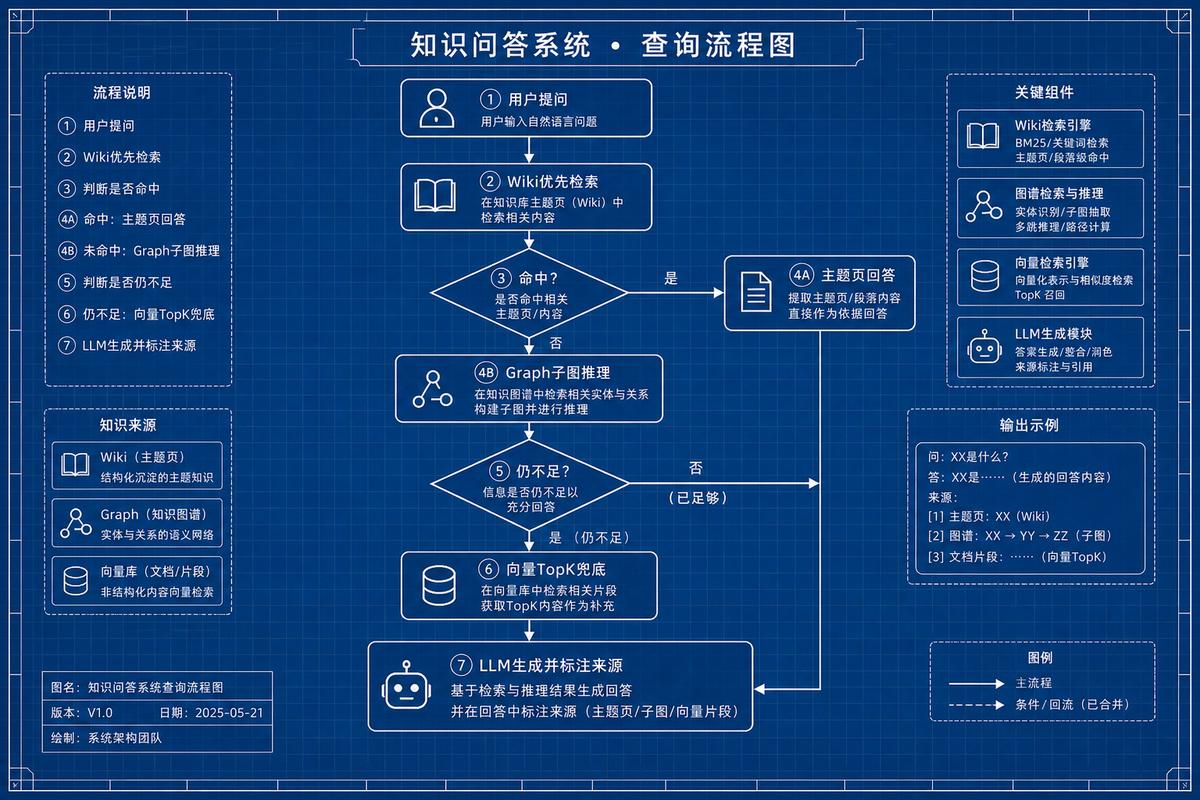
查询分流示例(Wiki 优先,RAG 兜底):
1. 先查 Wiki / 图谱:命中高置信主题页或子图 → 直接组织答案
2. 未命中或置信度低 → 走向量 TopK 补证据
3. 合并输出时 标注来源类型(Wiki / Graph / Chunk),方便审计
运维故障场景举例:
- GraphRAG:拉因果链路与设备依赖
- 向量 RAG:捞当次报错日志、未入库的新 patch note
- LLM Wiki:匹配标准处置手册与历史复盘模板
六、选型速查表
| 你的问题类型 | 优先方案 |
|---|---|
| 「这段文档怎么说?」单点事实 | 普通 RAG |
| 「A 和 B 什么关系?影响链路?」 | GraphRAG |
| 「给我们一份可复用的领域知识手册」 | LLM Wiki |
| 企业级生产、文档海量、既要覆盖又要推理 | 三层混合 |
入门路径建议:
1. 先用 普通 RAG 跑通数据管道与评测集(没有评测就不要上图谱)
2. 关系类问题占比高 → 加 GraphRAG 子模块
3. 核心域稳定、重复查询多 → 建 LLM Wiki 骨架,RAG 兜底长尾
七、工程避坑清单
1. 没有评测集就叠图谱:先定义 50–100 条真实业务问答,再比 Recall@K 与人工打分
2. Chunk 切太碎:语义断裂比「切得细」更致命,overlap 不要省
3. Wiki 摄入不设人工闸门:自动提取概念页会污染图谱,核心域建议 INGEST 确认
4. 忽略权限与多租户:企业知识库检索必须和 ACL 同步,向量库 alone 不管行级权限
5. 把 RAG 当一锤子买卖:文档更新、embedding 版本、图谱增量都要有 job 与回滚策略
八、总结
RAG 被嘲三年,讽刺的往往是 「只有 Chunk 检索的简陋 RAG」,而不是「检索增强」这条路线本身。企业真正在加码的,是:
- 向量层 保覆盖与实时性
- 图谱层 补关系与推理
- Wiki 层 做沉淀与治理
三者组合,才接近「既查得到,又讲得清,还能越用越聪明」的知识库目标。下一篇如果你在做 WeKnora、ThinkWiki、LightRAG 等具体项目落地,可以把组件选型单独拆一版实战。
延伸阅读关键词:GraphRAG、LightRAG、LLM Wiki、Karpathy wiki 思路、混合检索、企业知识库评测
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: