再见传统 RAG!腾讯/开源圈爆火的 SAG 架构到底凭什么又快又准?
在企业级大模型落地和知识库构建中,RAG(Retrieval-Augmented Generation,检索增强生成) 几乎是过去两年的绝对主角。然而,随着应用场景逐步深入到复杂的业务文档、跨部门项目追溯、多文档逻辑关联以及精准数据筛选时,传统纯向量 RAG 的短板暴露无遗:模糊语义能对上,复杂逻辑断联;多跳推理靠运气,回答幻觉频发。
为了解决多跳推理的痛点,社区曾兴起过 GraphRAG(知识图谱 + RAG) 浪潮,但 GraphRAG 离线预构建全局全量图谱的算力成本极其高昂,被不少团队戏称为“吞金兽”,且极难应对高频动态更新的数据源。
就在这一背景下,SAG(SQL-Augmented / SQL-Retrieval Augmented Generation) 架构在开源社区与头部科技大厂中迅速爆火。它不仅在 HotpotQA、2WikiMultiHopQA 等多跳推理基准测试中表现亮眼,而且凭借 “查询时动态超边(Dynamic Hyperedge Routing)” 与 “SQL 强约束”,在精准度与运维成本之间找到了完美的平衡。
本文将深度拆解 SAG 的底层工程设计、核心工作原理、与传统 RAG / GraphRAG 的硬核对比,并提供开箱即用的落地架构实践指南。
1. 传统 RAG 与 GraphRAG 的“死穴”在哪里?
要搞懂 SAG 的革新之处,首先需要看懂当前两套主流架构在真实工程中的瓶颈。
1.1 传统纯向量 RAG 的语义短板
传统 RAG 的核心工作流是:文档切片 (Chunking) -> 向量化 (Embedding) -> 向量数据库 (Vector Database) -> 余弦相似度 Top-K 检索 -> Prompt 拼接 -> LLM 生成。
• 断链痛点(无法连点成线):向量检索擅长“模糊语义匹配”,但不擅长“关系链条追踪”。假设用户询问:“A 公司在 2025 年收购的 B 团队,其核心负责人 C 此前在哪家机构任职?”* 文档 1 包含:A 公司收购 B 团队;* 文档 2 包含:C 属于 B 团队核心成员,曾任职于 X 实验室。* 传统向量 RAG 在检索时,因输入问题无法一次性在向量空间中与文档 1 和文档 2 同时发生高相似度碰撞,极易丢掉关键链路,造成“断链”或幻觉。
1.2 GraphRAG 的算力与运维“大山”
针对多跳推理,GraphRAG 引入了知识图谱(Entity-Relation Triplets)。但 GraphRAG 带来了两大工程灾难:
1. 预构建吞金兽:在离线建库阶段,需要调用大模型对全量文档逐句提取实体和关系,几十万字文档可能消耗数千美金 Token 费用;
2. 增量更新噩梦:一旦源文件修改或新增,全局图谱与社区摘要(Community Summary)需要重新聚类和重构,难以满足实时性要求。
2. SAG 架构核心原理:查询时动态超边 (Dynamic Hyperedge)
SAG 的核心哲学是:离线阶段轻量结构化,在线查询时才按需构建局部关联。
[原始文档 / 语料库]
       │
       ├──> 离线解析 ──> 事件表 (Events: 文本上下文) + 实体表 (Entities: 关键桥梁)
       │                    │                           │
       │                    ▼                           ▼
       │               [向量数据库]                [关系型 SQL 数据库]
       │             (Vector Search)               (SQL JOIN 强关联)
       │                    │                           │
       └────────────────────┴─────────────┬─────────────┘
                                          │
   用户 Query ──> [Query 意图路由与实体识别] ──> [SQL 动态超边关联 Engine] ──> [精准 Prompt] ──> LLM 最终生成
2.1 离线阶段:事件 (Event) 与实体 (Entity) 的轻量抽离
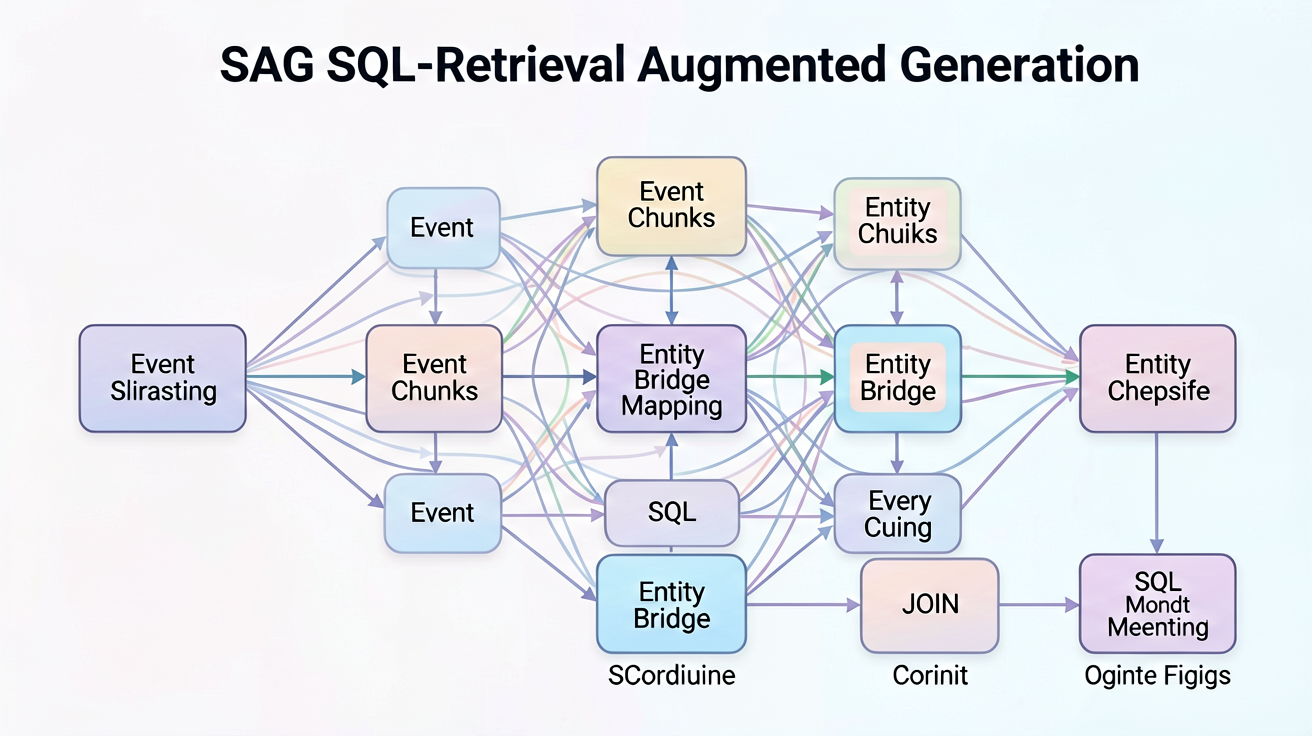
SAG 在离线解析文档时,并不盲目构建全量图谱,而是将文本拆分为两个核心表结构:
- 事件表 (Events Table):保存保留完整语义上下文的文本切片;
- 实体表 (Entities Table):提取文档切片中出现的核心实体(人名、机构、技术术语、项目 ID 等),并在 SQL 数据库中建立 Event_Entity_Mapping 关联表。
2.2 在线阶段:SQL 驱动的“动态超边”路由
当用户提交一个复杂的多跳查询时:
1. 实体解析:识别 Query 中的关键词与目标实体;
2. SQL JOIN 超边构建:利用 SQL 数据库的确定性索引,执行 JOIN 查询,瞬间找到“共享同一实体/隐性逻辑桥梁”的所有相关事件切片;
3. 向量与全文混合重排序:将 SQL 精准筛选出来的事件集合与向量相似度评分结合,构建出针对当前查询的高相关上下文(超边)。
3. 三大知识库架构硬核对比选型
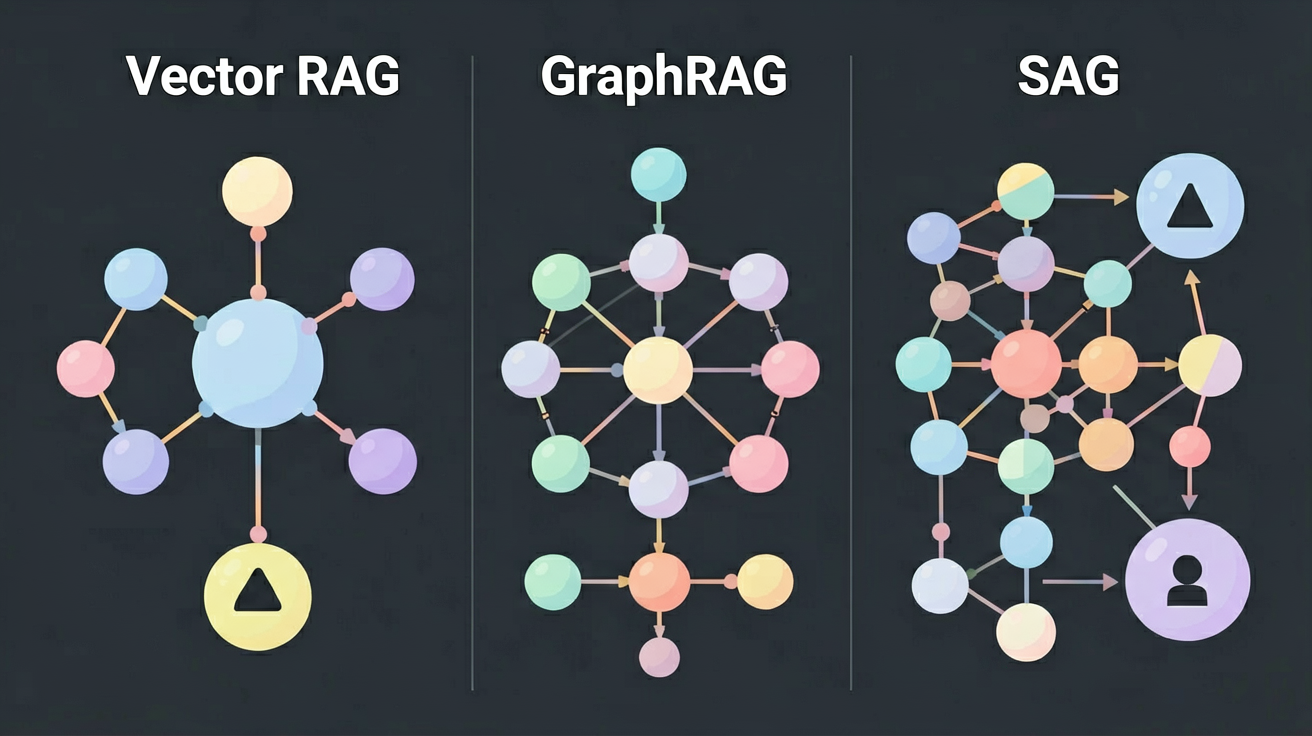
为了帮助架构师快速选型,我们将 传统向量 RAG、GraphRAG 与 SAG 进行了多维度对比:
| 评估维度 | 传统纯向量 RAG | GraphRAG (知识图谱) | SAG (SQL 动态超边) |
|---|---|---|---|
| 检索核心机制 | 向量空间余弦相似度 Top-K | 图遍历 (Graph Traversal) + 社区摘要 | SQL JOIN 确定性关联 + 向量混合 |
| 多跳推理能力 | 较弱 (依赖语义交集,易断链) | 极强 (逻辑网完整) | 极强 (按需实时链路追踪) |
| 离线建库成本 | 极低 (仅计算 Embedding) | 极高 (全量提取实体/关系耗费大量 Token) | 低 (提取基础 Entity + SQL 建索引) |
| 数据增量更新 | 秒级 (Direct Insert) | 极慢 (需重新聚类和重构全局图) | 秒级 (标准 SQL 事务插入/更新) |
| 数据可溯源性 | 模糊 (仅包含相似分数) | 中等 (节点关系) | 百分百可溯源 (精确定位 SQL Row ID 与文件行号) |
| 运维门槛 | 低 (常用向量库即可) | 高 (需维护 Neo4j/NebulaGraph 等图库) | 极低 (基于 PostgreSQL/MySQL 等传统 SQL 基建) |
4. 落地实战:用 Python + PostgreSQL 极速构建 SAG 检索 Engine
下面我们使用 PostgreSQL (pgvector) 演示如何编写一个简易但功能完整的 SAG 动态超边检索逻辑。
import psycopg2
from openai import OpenAI
import json

# 初始化 API Client
client = OpenAI(base_url="http://127.0.0.1:8045/v1", api_key="sk-b2674a9e6c2f4e53ae3e376c49a10e4f")

# 链接 PostgreSQL 数据库
conn = psycopg2.connect("dbname=knowledge_db user=postgres password=secret host=localhost port=5432")
cursor = conn.cursor()

def sag_dynamic_hyperedge_query(user_query: str, target_entities: list):
    """
    SAG 在线查询核心:通过 SQL JOIN 动态连接共享实体的事件切片
    """
    print(f"[*] 执行 SAG 动态超边检索,关联实体: {target_entities}")

    # 1. 使用 SQL JOIN 获取包含目标实体的所有事件切片 (SQL 强约束)
    sql_query = """
        SELECT DISTINCT e.id, e.content, e.source_doc
        FROM events e
        JOIN event_entity_mapping m ON e.id = m.event_id
        JOIN entities ent ON m.entity_id = ent.id
        WHERE ent.name = ANY(%s)
        LIMIT 10;
    """
    cursor.execute(sql_query, (target_entities,))
    matched_events = cursor.fetchall()

    context_blocks = []
    for event_id, content, source_doc in matched_events:
        context_blocks.append(f"[来源: {source_doc} | Event_ID: {event_id}]\n{content}")

    full_context = "\n\n".join(context_blocks)

    # 2. 拼接 Context 喂给 LLM 生成最终回答
    system_prompt = "你是一个基于 SAG 架构的精密知识库助手。请严谨依据提供的上下文回答,不得产生幻觉。"
    user_prompt = f"上下文知识库内容:\n{full_context}\n\n用户问题:{user_query}"

    response = client.chat.completions.create(
        model="claude-3-5-sonnet",
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt}
        ],
        temperature=0.2
    )

    return response.choices[0].message.content

if __name__ == "__main__":
    # 模拟多跳关联查询
    query = "请总结 A 公司收购 B 团队后,相关核心负责人的学术背景"
    entities = ["A公司", "B团队", "负责人C"]

    answer = sag_dynamic_hyperedge_query(query, entities)
    print("\n[SAG LLM 回答结果]:\n", answer)
5. 避坑指南与生产落地建议
在将 SAG 架构引入生产环境时,务必注意以下工程边界与避坑要点:
⚠️ 1. 实体提取粒度控制
离线提取 Entity 时,绝对不要过度提取通用词汇(如“数据”、“系统”、“功能”),否则会导致 SQL JOIN 时返回过多泛化节点(超边膨胀),拖慢检索性能。仅提取专有名词、人名、项目代号、架构模块名与版本号。⚠️ 2. 必须结合混合重排序 (Hybrid Re-ranking)
单纯的 SQL JOIN 能解决“查得到”的问题,但筛选出来的候选 Events 数量可能较多。在将 Events 喂给 LLM 前,必须使用 BGE-Reranker 或 Cohere Reranker 进行二次精细打分,截取 Top 3-5 送入 Prompt,兼顾 Token 消耗与精确度。⚠️ 3. PostgreSQL + pgvector 是一站式终极基建
无需盲目引入独立的向量数据库或复杂的图数据库。PostgreSQL 结合pgvector插件既支持 JSONB / SQL JOIN 处理实体图谱,又支持 HNSW 向量检索,是目前搭建 SAG 架构性价比最高的选择。
6. 总结
从纯向量 RAG 到 GraphRAG,再到如今的 SAG (SQL 动态超边),AI 知识库的演进证明了一个道理:纯粹依赖大模型的模糊语义是不靠谱的,确定性的传统数据库索引与关系代数依然是解决幻觉的最佳解药。
对于 90% 的企业级知识库应用来说,SAG 无疑是当下精度更高、成本更低、运维最轻量的终极方案。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: