拆解 10,000+ Star 开源 Agent 系统:RAG 语义检索与可视化工作流的深度融合
随着生成式 AI 人工智能技术在企业级生产环境的全面落地,单纯依赖 Prompt 提示词工程的“聊天机器人”形态已远不能满足严肃业务场景的要求。企业需要的不仅是能“回答问题”的模型,更是一个能够高效调取私有知识库(RAG)、编排多步骤业务流程并具备自动化工具调用能力的企业级 Agent 系统。
在 GitHub 狂揽上万 Star 的开源 Agent 基础设施架构,通过混合 RAG 检索(Hybrid Vector & Keyword RAG)与可视化无代码/低代码工作流编排引擎(Visual Workflow Orchestration)的有机融合,为建设高可靠、低幻觉的企业级 AI 智能体体系提供了标准的工程范式。
一、企业级 AI 应用落地的三大核心痛点
企业在将大模型技术接入实际业务线(如客户服务、智能运维、法规审计)时,普遍面临着以下结构性挑战:
1. 幻觉与事实不符:基础大模型缺乏企业内部特定业务逻辑与专有数据,容易在回答中“虚构事实”。
2. 知识更新滞后与高昂的微调成本:通过的全量模型微调(Fine-tuning)不仅算力成本高昂,且无法满足分钟级知识增量更新的需求。
3. 复杂业务流程不可控:简单的单轮 Chat 无法处理需要“先校验身份 -> 再查询数据库 -> 触发审批 -> 发送邮件”的多阶段分支流程。
二、开源 Agent 系统的双核架构设计
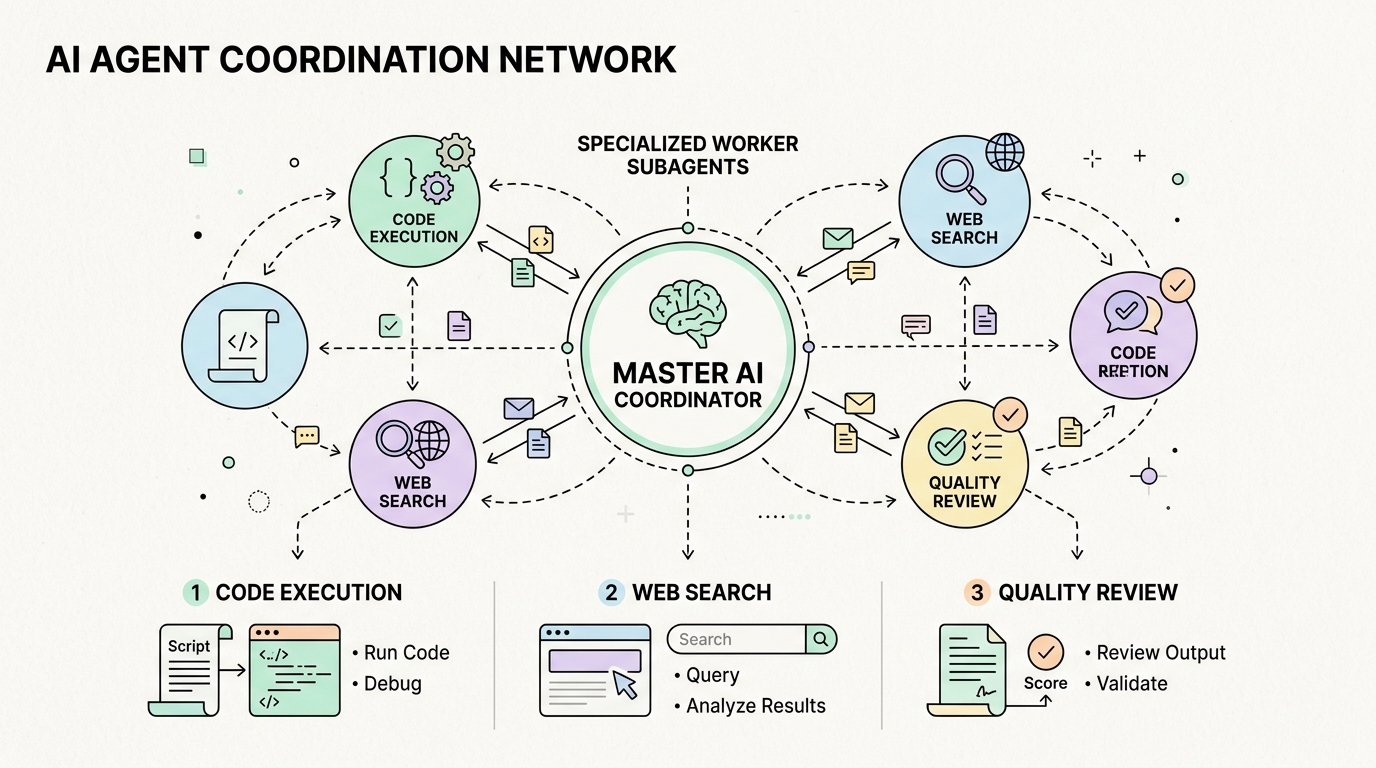
为了解决上述问题,现代开源 Agent 系统普遍采用了 “RAG 检索增强 + 可视化工作流编排” 的双核解耦架构。
2.1 混合 RAG 检索(Hybrid RAG Engine)
传统的纯向量检索(Dense Retrieval)在面对专有名词、产品型号、精确编号时极易出现召回失效。现代 Agent 系统普遍采用混合检索 + 重排(Hybrid Search & Reranking)架构:
• 向量语义召回:使用 Embedding 模型(如 text-embedding-3)计算高维语义相似度;
• 关键词精确匹配:结合经典的 BM25 / Sparse Vector 倒排索引算法;
• 交叉编码器重排(Cross-Encoder Reranker):将候选文档与 Query 组合输入 Rerank 模型(如 Cohere Rerank / BGE-Reranker),精细排序剔除噪声。
(此处有架构流程图,微信客户端暂不支持文本渲染,请升级 or 使用支持的客户端查看)
2.2 可视化节点工作流(DAG Workflow Engine)
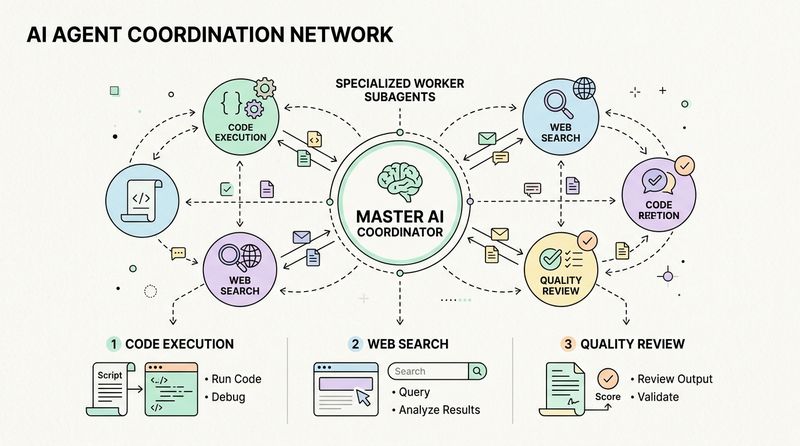
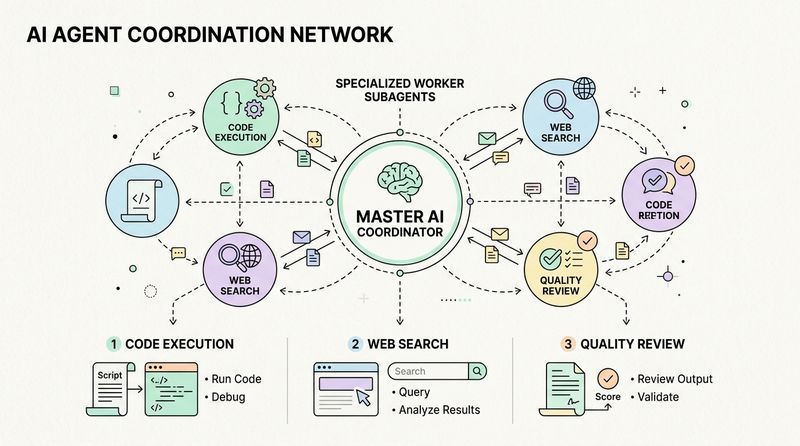
系统引入基于有向无环图(DAG)的节点编排模式。开发者可以在画布上将“RAG 检索节点”、“大模型推理节点”、“代码沙箱节点”与“HTTP API 条件分支”像搭积木一样自由组合:
| 维度 / 特征 | 传统单轮 Prompt 模式 | 开源 Agent 混合架构 (RAG + Workflow) |
|---|---|---|
| 事实准确度 | 存在模型幻觉风险 | 基于企业私有知识库 RAG 精准召回 |
| 流程可控制性 | 无法干预模型的中间推理 | DAG 节点强控制,分支逻辑 100% 可预测 |
| 数据更新时效 | 依赖模型训练周期 | 文档秒级切片与增量向量入库 |
| 外部 API 扩展 | 仅支持简单 Function Calling | 图形化集成 HTTP 节点、Python/JS 沙箱 |
三、Agent 工作流配置与 Python SDK 实战
在开源 Agent 系统中,工作流可以导出为标准的 JSON/YAML 文件,并通过 Python 脚本进行自动化触发。
3.1 工作流结构 practice/rag_agent_pipeline.json
在 practice/rag_agent_pipeline.json 中定义包含 RAG 与沙箱的节点链:
{
  "workflow_id": "enterprise_rag_agent_v1",
  "nodes": [
    {
      "id": "node_vector_search",
      "type": "retriever",
      "name": "Milvus Hybrid Vector RAG"
    },
    {
      "id": "node_llm_reasoning",
      "type": "llm",
      "name": "LLM Thought Engine"
    }
  ]
}
3.2 混合 RAG Python 调度示例
在 practice/demo_agent_rag.py 中,系统自动执行混合检索与 Prompt 动态注入:
import json
import time

class HybridRAGRetriever:
    def search(self, query: str):
        print(f"[RAG Engine] 正在对查询 [{query}] 进行混合检索...")
        # ... 混合重排逻辑
四、生产落地避坑指南
💡 架构建议:在构建企业级 Agent 系统时,分词与向量分块(Chunking)策略至关重要。
1. Chunk 大小选型:避免使用过大或过小的分块。推荐使用 500-1000 字符的块大小(Chunk Size),并保留 10%-15% 的重叠区间(Chunk Overlap),以保证上下文连续性。
2. 工具调用超时防范:在工作流中调用的外部 HTTP API 节点必须配置严格的 5 秒 ~ 10 秒超时熔断,防止第三方接口卡顿导致整个 Agent 流程挂起。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 直接体验运行验证。