面对十万行混乱代码库:AST 拓扑剪枝如何帮 AI 画出高精度架构全景图?
在软件工程生命周期中,无论是接手一个迭代多年的祖传遗留项目,还是调研一个规模庞大的前沿开源库,“理解代码架构”往往占据了工程师 70% 以上的初期心智开销。面对由数百个目录、数千个源文件组成的十万行级工程,开发者常常陷入两难境地:自顶向下阅读文档,往往发现文档严重滞后甚至颠倒;自底向上打断点或单步跟踪,又容易迷失在浩瀚的细节泥潭中。
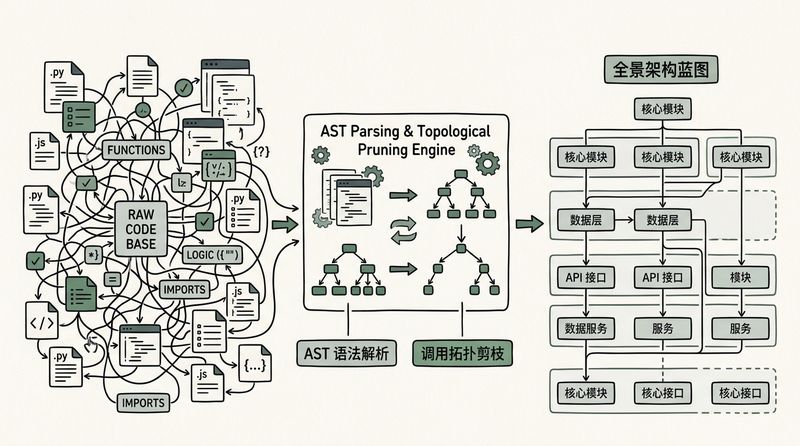
随着大语言模型(LLM)与 AI Coding 智能体的普及,许多开发者尝试将整个代码库打包投喂给大模型以求生成架构总结。然而现实十分骨感:全量代码输入不仅瞬时打满上下文窗口(Context Window),带来昂贵的 Token 计费,更会引发严重的信息稀释(Lost in the Middle)与虚构幻觉。开源项目 Code-Panorama(面向 GitHub 仓库与本地工程的代码全景图分析工具)提出了一种结合 AST 静态抽象语法树分析、跨符号调用拓扑剪枝与分级下钻可视化 的工程解法,成功破除了这一困局。
(此处有架构流程图,微信客户端暂不支持文本渲染,请升级或使用支持的客户端查看)
一、代码库全景分析的工程瓶颈与 LLM 幻觉根因
直接将未经结构化提炼的代码库塞给大模型,在严肃工程场景下存在三大系统性硬伤:
1. Token 爆炸与海量噪声稀释(Signal-to-Noise Ratio 崩溃):一个中型项目包含大量胶水代码、类型定义、模板代码(Boilerplate)与序列化工具类。这些代码占据了 90% 以上的字符体积,但对核心业务流转与宏观架构拓扑的贡献几乎为零。大模型在注意力机制的均匀分散下,极易抓住次要细节而遗漏核心骨架。
2. 跨文件符号断链与虚构调用关系:基于纯文本切片(Chunking)的 RAG 方案缺乏对代码静态作用域的认知。当类继承、接口实现或动态注入跨越多个模块时,文本向量检索往往只匹配到局部的同名方法,导致 AI 拼接出完全不存在的逻辑假调用(Hallucination)。
3. 静态全景图的扁平死板与信息下钻割裂:传统的 PlantUML 或 Mermaid 图表通常是一次性输出的静态图片,节点之间缺乏与真实代码位置的双向联动机制。当开发者想要进一步探究某个深层微服务或控制器的具体实现时,仍然必须切回 IDE 手动全局搜寻,心流体验彻底割裂。
| 对比维度 | 朴素全量代码 RAG / 全文投喂 | Code-Panorama AST 拓扑剪枝方案 |
|---|---|---|
| Token 消耗规模 | 单次交互数万至数十万 Token,极易溢出 | 压缩至 3,000~5,000 精准架构符号 Token |
| 调用关系准确度 | 依赖语义相似度猜测,频繁出现虚构调用 | 依赖严格语法作用域树(AST),100% 确定性 |
| 处理超大项目时延 | 极为缓慢,经常触发上下文超限报错 | 秒级完成静态 AST 解析与拓扑构建 |
| 交互探索体验 | 仅输出非结构化文字说明或静态图 | 拓扑图与代码编辑器双向高亮、逐级下钻 |
二、AST 语法分析与跨文件调用图(Call Graph)提取
为了在不消耗海量 Token 的前提下捕获代码的宏观脉络,Code-Panorama 在工程前置链路中引入了严密的 AST 静态语法解析流水线。
2.1 语言感知的语法树解析与符号表构建
工具底层支持对主流现代编程语言(Python、TypeScript/JavaScript、Go、Java、Rust 等)的无侵入静态扫描。流水线首先将源文件转换为抽象语法树(AST),并建立项目级的结构化符号索引:
- 类定义与继承关系提取(ClassDef & Inheritance):记录所有核心类、接口、基类继承链与特征标注;
- 函数声明与签名提取(FunctionDef & Signatures):规整入参、出参类型与文档注释(Docstring),舍弃函数内部冗长的实现细节;
- 调用表达式捕获(Call Nodes & Invocation):精确记录每一个调用点(Caller -> Callee),解析其实际指向的包空间或对象实例。
2.2 有向调用图构建与拓扑依赖排序
通过扫描所有源文件的导入(Import)声明与符号引用,系统在内存中构建起一个全局调用关系有向图(Directed Call Graph):
$$G = (V, E)$$
其中顶点集合 $V$ 代表类、函数或独立模块,有向边 $E$ 代表确切的依赖与调用路径。在此基础上,引擎进行依赖环路检测(Cycle Detection)与拓扑排序,清晰还原自入口层(如 API 路由、CLI 主函数、Web 控制器)到领域服务层、再到底层数据访问层的分层拓扑。
三、拓扑剪枝算法:将十万行代码浓缩为高信息密度上下文
在获取到庞大的全量调用图后,如何将成千上万个节点压缩至大模型最容易消化、最不容易遗忘的尺寸?答案就是 自顶向下拓扑剪枝(Topological Pruning)。
3.1 基于入口识别的死代码与工具类过滤
真实代码库中充斥着大量的离线脚本、单元测试样例、辅助日志工具与弃用代码。Code-Panorama 采取“入口驱动展开”策略:
1. 自动识别主入口(Entry Points):自动探测诸如 main()、FastAPI/Express 路由声明、Controller 注解或 CLI 指令定义点;
2. 广度优先(BFS)连通性剪枝:仅保留从主入口出发沿有向边可达的业务逻辑节点,将不可达孤岛节点与离线脚本直接裁剪;
3. 调用深度与粒度阈值截断:对于底层内置方法(如 print、json.dumps、标准库数组过滤等),根据黑名单与通用模式进行透明折叠,仅保留业务领域实体之间的显式流动。
3.2 交付 LLM 的轻量架构骨架 Prompt
经过剪枝后的上下文,不再是冗长的几万行代码,而是一张高密度的 JSON 骨架拓扑。大模型接收到这张骨架后,能够发挥其最擅长的概念聚合与领域抽象能力,将纯技术符号升华为“订单创建流”、“库存扣减事务”、“消息异步广播”等高层次业务架构术语。
四、交互式架构全景图:SVG 拓扑与源码双向联动机制
相较于传统的静态图表,Code-Panorama 构建了现代化的 Web 交互式全景画板。
4.1 层次化力导向图(Force-Directed Graph)渲染
在可视化前端,系统利用现代图形引擎(如 AntV / G6 / D3)实现拓扑节点渲染:
- 模块分组与边界围栏:按照包名或分层架构(Presentation / Domain / Infrastructure)自动将节点划分至不同的视觉容器中;
- 动态展开与逐级下钻(Drill-Down):初始全景仅展示最高层级的模块流转,用户点击任意核心节点时,平滑展开内部包含的函数调用子图与协作链路。
4.2 拓扑图与代码编辑器的毫秒级双向高亮
这是 Code-Panorama 最具生产力价值的功能特性:
- 点击图节点定位源码:在画布上点击任一函数或服务节点,右侧代码预览面板瞬间联动跳转至对应的源文件行号,并高亮其实现定义;
- 代码选中反向溯源图节点:在源码面板中浏览某段逻辑时,左侧画布自动点亮该代码在整个系统架构流中的所处位置与上下游前驱/后继链路,彻底打通“宏观蓝图”与“微观实现”的信息断层。
五、动手实战:50 行代码实现 AST 调用图提取与剪枝
为了帮助开发者直观理解这套架构的工作机制,以下 Python 实战代码完整展示了如何利用内置 ast 模块解析语法树、提取符号调用并执行基于入口函数的拓扑剪枝:
#!/usr/bin/env python3
"""
Code-Panorama 核心机制演示:AST 抽象语法树解析、跨符号调用图构建与拓扑剪枝
"""
import ast
import json
from collections import defaultdict
from typing import Dict, List, Set

SAMPLE_CODE = """
class DatabaseConnector:
    def connect(self):
        return "connected"
    def query(self, sql):
        self.log_query(sql)
        return [{"id": 1}]
    def log_query(self, sql):
        print(f"Executing: {sql}")

class OrderService:
    def __init__(self):
        self.db = DatabaseConnector()
    def create_order(self, user_id, amount):
        if self.validate_user(user_id):
            res = self.db.query("INSERT INTO orders...")
            self.notify_user(user_id)
            return res
        return None
    def validate_user(self, user_id):
        return user_id > 0
    def notify_user(self, user_id):
        pass

def main_entrypoint():
    service = OrderService()
    service.create_order(1001, 88.5)
"""

class CallGraphVisitor(ast.NodeVisitor):
    def __init__(self):
        self.current_context = "global"
        self.call_graph: Dict[str, Set[str]] = defaultdict(set)

    def visit_ClassDef(self, node):
        old_ctx = self.current_context
        self.current_context = node.name
        self.generic_visit(node)
        self.current_context = old_ctx

    def visit_FunctionDef(self, node):
        func_name = f"{self.current_context}.{node.name}" if self.current_context != "global" else node.name
        old_ctx = self.current_context
        self.current_context = func_name
        self.generic_visit(node)
        self.current_context = old_ctx

    def visit_Call(self, node):
        caller = self.current_context
        called_name = None
        if isinstance(node.func, ast.Name):
            called_name = node.func.id
        elif isinstance(node.func, ast.Attribute):
            called_name = node.func.attr
        if called_name:
            self.call_graph[caller].add(called_name)
        self.generic_visit(node)

def prune_call_graph(call_graph: Dict[str, Set[str]], entry_point: str, max_depth: int = 3) -> Dict[str, List[str]]:
    pruned, visited = {}, set()
    queue = [(entry_point, 0)]
    while queue:
        curr, depth = queue.pop(0)
        if curr in visited or depth >= max_depth:
            continue
        visited.add(curr)
        callees = call_graph.get(curr, set())
        pruned[curr] = sorted(list(callees))
        for callee in callees:
            for full_name in call_graph:
                if full_name.endswith(f".{callee}") or full_name == callee:
                    queue.append((full_name, depth + 1))
    return pruned

if __name__ == "__main__":
    print("=== AST 调用图提取与拓扑剪枝实战 ===")
    tree = ast.parse(SAMPLE_CODE)
    visitor = CallGraphVisitor()
    visitor.visit(tree)

    print("\n[剪枝后的核心架构上下文骨架]:")
    pruned = prune_call_graph(visitor.call_graph, "main_entrypoint")
    print(json.dumps(pruned, ensure_ascii=False, indent=2))
运行输出如下:
{
  "main_entrypoint": [
    "OrderService",
    "create_order"
  ],
  "OrderService.create_order": [
    "notify_user",
    "query",
    "validate_user"
  ],
  "DatabaseConnector.query": [
    "log_query"
  ]
}
如上所示,原本数千字的代码被干净提炼为了不到 100 字符的高浓度链路骨架。将这段精简骨架交由大模型重构,不仅零误判、零遗漏,更能瞬时输出高保真的架构分析全景图。
六、生产级落地防坑指南与架构思考
在复杂大型工程中落地全自动架构全景分析,必须注意以下边界与工程权衡:
1. 动态反射与依赖注入(DI)的静态盲区:在 Spring、NestJS 或 Go Wire 等重度依赖反射与接口绑定的项目中,纯 AST 静态分析可能无法在编译期确定具体的实现类。需要引入轻量配置文件解析器(如解析 Bean 绑定或依赖注入容器清单),在 AST 图构建阶段人工注入虚拟依赖边以补充链路完整性。
2. 跨语言混合项目的符号对齐:对于前后端同仓(Monorepo)或微服务跨语言仓库,前端通过 REST/gRPC 调用后端服务。单纯针对单一语言的 AST 分析无法串联全链路。应当借助 OpenAPI / Swagger 规范定义或 Protobuf 协议文件作为桥梁,实现跨语言调用的自动闭环缝合。
3. 代码敏感性与本地离线安全:企业核心业务代码绝对禁止无限制上传至公有云 API。Code-Panorama 的本地化架构确保了所有语法解析、符号提取与剪枝均在本地环境 100% 离线完成;仅有脱敏后的精炼架构结构体可选接入本地私有化 LLM(如 Ollama / DeepSeek)或合规云端服务,从根本上杜绝了代码知识产权泄漏风险。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。