一个 while 循环加两个 trait,用 Rust 手写扛得住厂商格式差异的 ReAct Agent
社区里流传着一句话:“你不需要一个 Agent 框架,你需要的是一个 while 循环:观察、决策、行动、反思。”
这句话说对了一半。循环本身确实简单,真正把人拖进泥潭的是循环之外的东西:每家大模型返回的工具调用格式都不一样;网络抖动和服务端过载需要重试,而密钥错误不该重试;模型偶尔会陷入死循环,或者试图读取它不该读的文件。
最近有位开发者分享了用 Rust 从零写 AI Agent 的经历,其中两个踩坑细节很有代表性:一是 Anthropic 的工具调用格式和 OpenAI 完全不同,必须单独写解析器;二是他的 Anthropic 适配器曾经一直在静默丢弃系统提示,代码编译通过、运行不报错,功能却从未生效。
本文沿着这两个坑,用一个可离线运行的 Rust 示例(约 360 行,依赖只有 serde_json 和 thiserror),把一个“能上生产”的最小 ReAct Agent 拆成五个部分讲清楚。
一、为什么用 Rust 写 Agent
Python 依然是 Agent 生态最成熟的语言,选 Rust 并不是为了跑分,而是为了下面这些“长期运行”时才显现的特性:
| 关注点 | Python 常见情况 | Rust 的做法 |
|---|---|---|
| 部署 | 虚拟环境、依赖版本冲突 | cargo build 产出单个二进制文件 |
| 资源占用 | 解释器加依赖,常驻内存较高 | 无 GC、无运行时,内存占用可控 |
| 行为确定性 | GC 停顿、GIL 影响并发 | 无 GC 停顿,异步运行时可预测 |
| 错误处理 | 异常可能被宽泛的 except 吞掉 |
Result 必须显式处理,模式匹配强制覆盖分支 |
| 重构安全 | 运行到才发现字段名写错 | 结构体和枚举改动后编译器逐一指出 |
最后两行是 Agent 场景里最实用的:Agent 的逻辑分支多、外部输入不可控,编译期能拦下的错误越多,凌晨三点被告警叫醒的次数就越少。
二、骨架:两个 trait 加一个循环
整个 Agent 的扩展点只有两个 trait:LlmProvider 负责接入不同的大模型后端,Tool 负责给 Agent 赋予能力。
trait LlmProvider {
    fn name(&self) -> &str;
    fn complete(&self, messages: &[Message], tools: &[&dyn Tool]) -> Result<Completion, AgentError>;
}

trait Tool {
    fn name(&self) -> &'static str;
    fn description(&self) -> &'static str;
    fn parameters_schema(&self) -> Value;   // JSON Schema,告诉模型参数长什么样
    fn execute(&self, args: &Value) -> Result<String, AgentError>;
}
为了让示例不依赖网络,这里用的是同步 trait。真实项目中调用 HTTP 接口需要异步,在 trait 上加 #[async_trait] 并把方法改成 async fn 即可,结构完全相同。
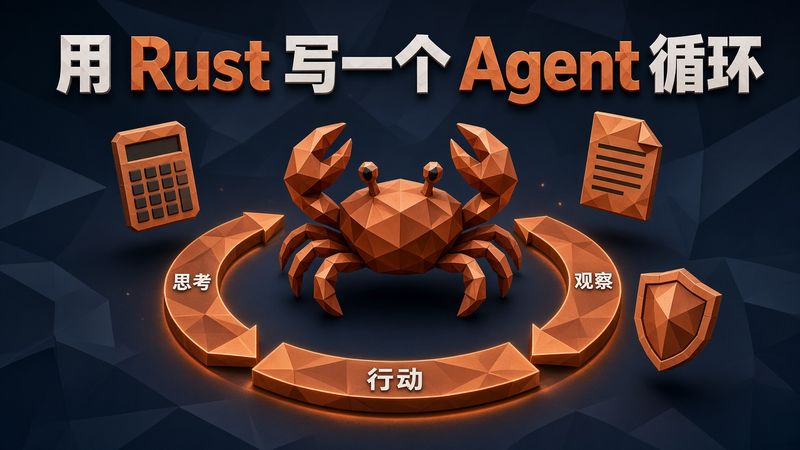
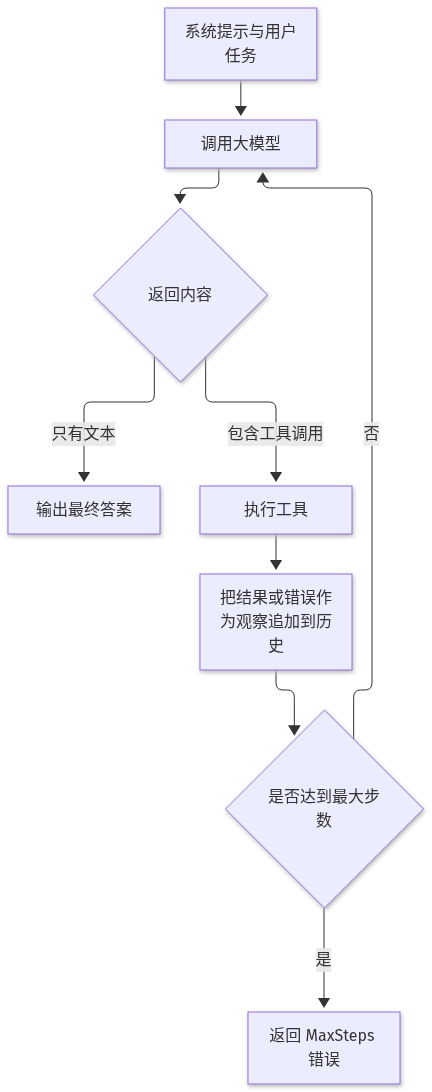
Agent 主循环就是经典的 ReAct:把历史消息交给模型,模型要么返回最终答案,要么返回若干工具调用;执行工具,把结果作为“观察”追加进历史,进入下一轮,直到拿到答案或达到步数上限。
for step in 1..=self.max_steps {
    let completion = self.complete_with_retry(&history, &tool_refs)?;
    if completion.tool_calls.is_empty() {
        return completion.text.ok_or_else(|| AgentError::InvalidResponse { /* ... */ });
    }
    for call in completion.tool_calls {
        let observation = match self.tools.iter().find(|t| t.name() == call.name) {
            Some(tool) => tool.execute(&call.args).unwrap_or_else(|e| format!("ERROR: {e}")),
            None => format!("ERROR: 未知工具 {}", call.name),
        };
        history.push(Message { role: Role::Tool, content: observation });
    }
}
Err(AgentError::MaxSteps(self.max_steps))
注意工具执行失败时,错误不会直接让整个 Agent 崩溃,而是以 ERROR: ... 的文本作为观察结果交还给模型,让模型有机会换个参数重试。这是 ReAct 循环里“观察”这一步的价值所在。
三、最大的坑:每家模型的工具调用格式都不一样
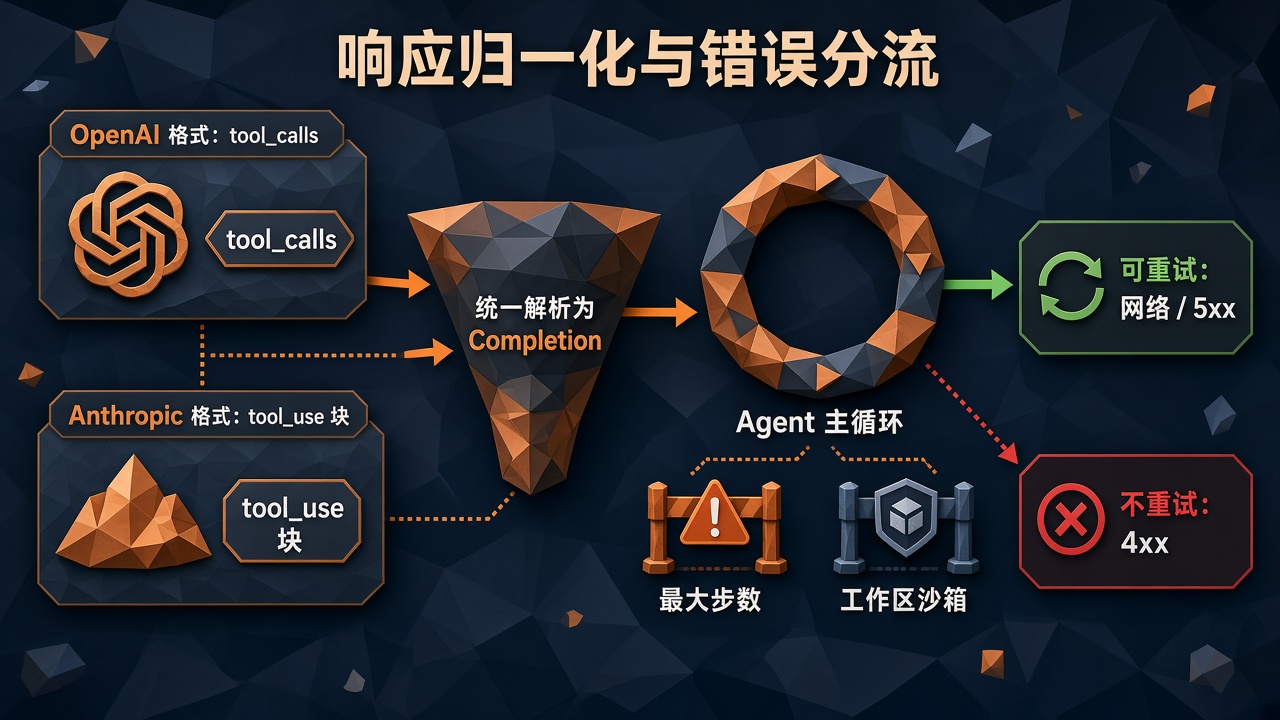
OpenAI 及其兼容接口(OpenRouter、DeepSeek 等)把工具调用放在 choices[0].message.tool_calls 里,参数是一个 JSON 字符串,需要二次解析:
{ "choices": [{ "message": { "content": null, "tool_calls": [
  { "id": "call_1", "type": "function",
    "function": { "name": "add_numbers", "arguments": "{\"a\":42,\"b\":58}" } }
] } }] }
Anthropic 则不返回 tool_calls,而是在 content 数组里混排文本块和 tool_use 块,参数 input 直接就是 JSON 对象:
{ "content": [
  { "type": "text", "text": "让我计算一下。" },
  { "type": "tool_use", "id": "abc", "name": "add_numbers", "input": { "a": 4, "b": 7 } }
] }
正确的做法是为每种格式写一个解析器,统一转换成内部的 Completion 结构,主循环只认 Completion:
fn parse_anthropic(provider: &str, body: &Value) -> Result<Completion, AgentError> {
    let blocks = body["content"].as_array().ok_or_else(|| AgentError::InvalidResponse {
        provider: provider.into(),
        reason: "缺少 content 数组".into(),
    })?;
    let mut out = Completion::default();
    for b in blocks {
        match b["type"].as_str() {
            Some("text") => out.text = b["text"].as_str().map(String::from),
            Some("tool_use") => out.tool_calls.push(ToolCall {
                id: b["id"].as_str().unwrap_or_default().into(),
                name: b["name"].as_str().unwrap_or_default().into(),
                args: b["input"].clone(),
            }),
            _ => {}
        }
    }
    Ok(out)
}
OpenAI 解析器里最容易漏的是 arguments 的二次解析:模型偶尔会生成不合法的 JSON,这时应该返回结构化的 InvalidResponse 错误,而不是 unwrap() 让程序崩掉。
系统提示被静默丢弃的那个 bug
两家的请求格式同样不同:OpenAI 把系统提示作为一条 role: system 的消息放在 messages 里;Anthropic 要求系统提示放在请求体顶层的 system 字段,messages 里只能有 user 和 assistant。
那位开发者的 bug 就出在这里:他在 Anthropic 适配器里把系统提示写死成了 None,从未真正从消息历史里提取。编译器无法发现这种“逻辑上漏传”的问题,所以更稳妥的做法是写一个专门的请求构造函数,并在测试里断言 system 字段不为空:
fn build_anthropic_request(messages: &[Message]) -> Value {
    let system: Vec<&str> = messages
        .iter()
        .filter(|m| matches!(m.role, Role::System))
        .map(|m| m.content.as_str())
        .collect();
    let rest: Vec<Value> = messages
        .iter()
        .filter(|m| !matches!(m.role, Role::System))
        .map(|m| {
            let role = if matches!(m.role, Role::Assistant) { "assistant" } else { "user" };
            json!({ "role": role, "content": m.content })
        })
        .collect();
    json!({ "system": system.join("\n"), "messages": rest })
}
四、错误处理:从字符串升级到可匹配的枚举
最初的错误类型往往是这样的:
#[error("Provider error: {0}")]
ProviderError(String),
看起来没问题,但调用方拿到一个字符串,既无法判断是不是网络问题,也无法据此决定要不要重试。把关键信息结构化之后,情况就完全不同了:
#[derive(Error, Debug)]
enum AgentError {
    #[error("Network error: {0}")]
    Network(String),
    #[error("Provider '{provider}' error{}: {message}",
        .status.map(|s| format!(" (HTTP {s})")).unwrap_or_default())]
    Provider { provider: String, message: String, status: Option<u16> },
    #[error("Invalid response from {provider}: {reason}")]
    InvalidResponse { provider: String, reason: String },
    #[error("Tool '{tool}' failed: {reason}")]
    ToolExecution { tool: String, reason: String },
    #[error("Agent reached the maximum of {0} steps without a final answer")]
    MaxSteps(usize),
}

impl AgentError {
    fn is_retryable(&self) -> bool {
        matches!(
            self,
            Self::Network(_) | Self::Provider { status: Some(429 | 500..=599), .. }
        )
    }
}
有了 is_retryable,重试逻辑就变成了一个干净的模式匹配:网络错误、服务端 5xx 和 429 限流可以重试,401 密钥错误、400 参数错误这类客户端问题重试也没用,直接返回。
fn complete_with_retry(&self, history: &[Message], tools: &[&dyn Tool]) -> Result<Completion, AgentError> {
    let mut attempt = 0;
    loop {
        match self.provider.complete(history, tools) {
            Err(e) if e.is_retryable() && attempt < self.max_retries => attempt += 1,
            other => return other,
        }
    }
}
这正是 Rust 的类型系统“逼着你做对”的地方:偷懒用字符串会让后续的重试、告警、降级都写不下去,自然就会把错误设计成可匹配的结构。
五、安全护栏:步数上限和工作区沙箱
Agent 的能力越强,边界越重要。示例里放了两道最基本的护栏:
1. 最大步数:模型陷入“调用工具、失败、再调用”的死循环时,max_steps 保证循环一定会结束,并返回明确的 MaxSteps 错误。
2. 工作区沙箱:文件类工具只允许访问指定的工作区目录,任何包含 ..、绝对路径或盘符的参数都直接拒绝。
let escapes = Path::new(rel).components().any(|c| {
    matches!(c, Component::ParentDir | Component::RootDir | Component::Prefix(_))
});
if escapes {
    return Err(AgentError::ToolExecution {
        tool: self.name().into(),
        reason: format!("路径 {rel} 越出工作区,已拒绝"),
    });
}
生产环境还应继续加码:执行 Shell 命令的工具要有危险命令检测(如 rm -rf /),网络请求类工具要阻止访问内网 IP,防止 Agent 被提示词注入后成为攻击跳板。
六、动手实验:五个场景跑一遍
配套工程位于 practice/rust-react-agent/。为了离线可运行,Provider 用“剧本”依次返回 OpenAI 或 Anthropic 真实格式的 JSON,再经过同一套解析器:
cd practice/rust-react-agent
cargo run
实际输出(省略开头的工具定义清单):
场景一:OpenAI 格式,一次工具调用后给出答案
    [第 1 步] 调用 add_numbers({"a":42,"b":58}) -> 100
  ✅ 最终答案: 42 + 58 = 100

场景二:Anthropic 格式(content 数组里的 tool_use 块)
    [请求] system = String("你是一个只用工具计算、绝不心算的助手")
    [第 1 步] 调用 read_file({"path":"notes.txt"}) -> 周报截止时间:周五 18:00
    [请求] system = String("你是一个只用工具计算、绝不心算的助手")
  ✅ 最终答案: 周报要在周五 18:00 前交。

场景三:服务端 503 可重试,第三次成功
    [重试 1/2] Provider 'openrouter' error (HTTP 503): upstream overloaded
    [重试 2/2] Provider 'openrouter' error (HTTP 503): upstream overloaded
  ✅ 最终答案: 服务恢复后直接回答:OK

场景四:401 属于客户端错误,不重试
  ❌ Provider 'openai' error (HTTP 401): invalid api key(可重试: false)

场景五:模型想越权读文件,沙箱拒绝后陷入循环,触发步数上限
    [第 1 步] 调用 read_file({"path":"../../etc/passwd"}) -> ERROR: Tool 'read_file' failed: 路径 ../../etc/passwd 越出工作区,已拒绝
    [第 2 步] 调用 read_file({"path":"../../etc/passwd"}) -> ERROR: Tool 'read_file' failed: 路径 ../../etc/passwd 越出工作区,已拒绝
    [第 3 步] 调用 read_file({"path":"../../etc/passwd"}) -> ERROR: Tool 'read_file' failed: 路径 ../../etc/passwd 越出工作区,已拒绝
  ❌ Agent reached the maximum of 3 steps without a final answer(可重试: false)
五个场景分别验证了:两种响应格式被归一化后走同一套循环;Anthropic 请求每一轮都带上了系统提示;503 按策略重试后成功;401 不浪费重试次数;越权访问被沙箱拦截,死循环被步数上限终止。
要接入真实模型,只需新增一个实现 LlmProvider 的结构体,用 HTTP 客户端(如 reqwest)发请求,再把响应交给对应的解析函数,主循环一行都不用改。
七、落地排坑清单
1. 工具结果的回传格式也要分厂商:示例为简化起见把观察结果当作普通消息追加。真实请求中,OpenAI 要求回传 role: tool 并带上 tool_call_id,Anthropic 要求在 user 消息里放 tool_result 块并对应 tool_use_id,ID 对不上会直接报 400。
2. arguments 永远要容错解析:模型生成的 JSON 字符串可能被截断或带多余字符,解析失败应返回结构化错误,必要时把错误作为观察交还模型让它重试。
3. 为系统提示写测试:构造请求的函数要单独测试,断言系统提示确实出现在请求体中,这类“编译通过但功能失效”的问题只能靠测试兜底。
4. 重试要配退避:示例为演示直接重试,生产环境应使用指数退避加随机抖动,并尊重 429 响应中的 Retry-After 头。
5. 步数上限之外再加成本上限:长任务可能在步数用完前就消耗大量 token,建议同时限制总 token 或总费用。
6. 并行工具调用:模型一次可能返回多个工具调用,彼此独立时可以用 futures::join_all 并发执行,但写文件、调接口这类有副作用的工具要谨慎。
7. 不是所有场景都需要完整 Agent:工单分类、意图识别这类窄任务,一个小模型加一次调用往往就够了,引入多轮循环只会增加延迟和成本。
八、总结
“Agent 就是一个 while 循环”这句话没错,但一个能长期跑在生产环境的循环,至少还需要三样东西:把各家响应格式归一化的解析层、能区分“该不该重试”的结构化错误、以及限制步数和权限的护栏。
Rust 在这里的优势不是让循环跑得更快,而是让这三样东西更难被写错:枚举让错误分支必须被处理,trait 让新增模型和工具不影响主循环,编译器在每次重构时替你检查一遍。如果你也想动手试试,从本文的示例工程开始,接上一个真实的模型接口,你的第一个 Rust Agent 这个周末就能跑起来。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。