别再只背 TCP 三次握手了,跟着 tshark 把一个抓包工具从解码写到会话还原
很多人学完 C/C++ 和计算机网络,留下的印象是水仙花数和一张七层模型图:SYN、ACK、滑动窗口都能背,可真把一个 pcap 文件丢过来,却不知道从哪个字节读起。
公众号「轩辕的编程宇宙」的作者分享过一个很好的练手方向:基于 Wireshark 自带的命令行组件 tshark,自己做一款可视化抓包软件 EasyTshark。后端用 C/C++ 负责调度 tshark 和处理数据包,前端用 React 写界面,再用 Electron 打包成跨平台桌面程序。作者选 C/C++ 的理由很实在:要装在个人电脑上,要跨平台,还要扛住数据包处理的性能压力。
这个项目覆盖的知识面很广:系统编程里的进程间通信与信号、Modern C++ 的智能指针和多线程、SQL 存储、RESTful 接口、协议分析,再加上前端。本文不讲课程本身,而是把这类工具的后端主链路拆开:tshark 怎么调、输出格式怎么选、pcap 文件长什么样、会话怎么归并,并用一个纯标准库的 Python 脚本把整条链路跑通。
一、为什么抓包工具是好的练手项目
“管理系统”类项目的问题在于,写来写去都是增删改查,网络、操作系统这些底层知识几乎碰不到。抓包工具正好相反:
- 数据是二进制的:你得按字节偏移解析以太网头、IP 头、TCP 头,字节序、位运算、变长头部一个都躲不掉;
- 数据是流式的:实时抓包时数据包源源不断,后端必须边读边处理,管道缓冲、线程模型、背压都会遇到;
- 结果要能查询:几十万个包摊在内存里不现实,落库和按会话聚合就成了刚需;
- 协议知识有反馈:三次握手在课本上是一张图,在你的程序里是三行带时间戳的记录,RTT 能直接算出来。
把这些串起来,课本上的概念第一次有了“看得见的输出”。
二、整体架构:让 tshark 做解码,自己做编排
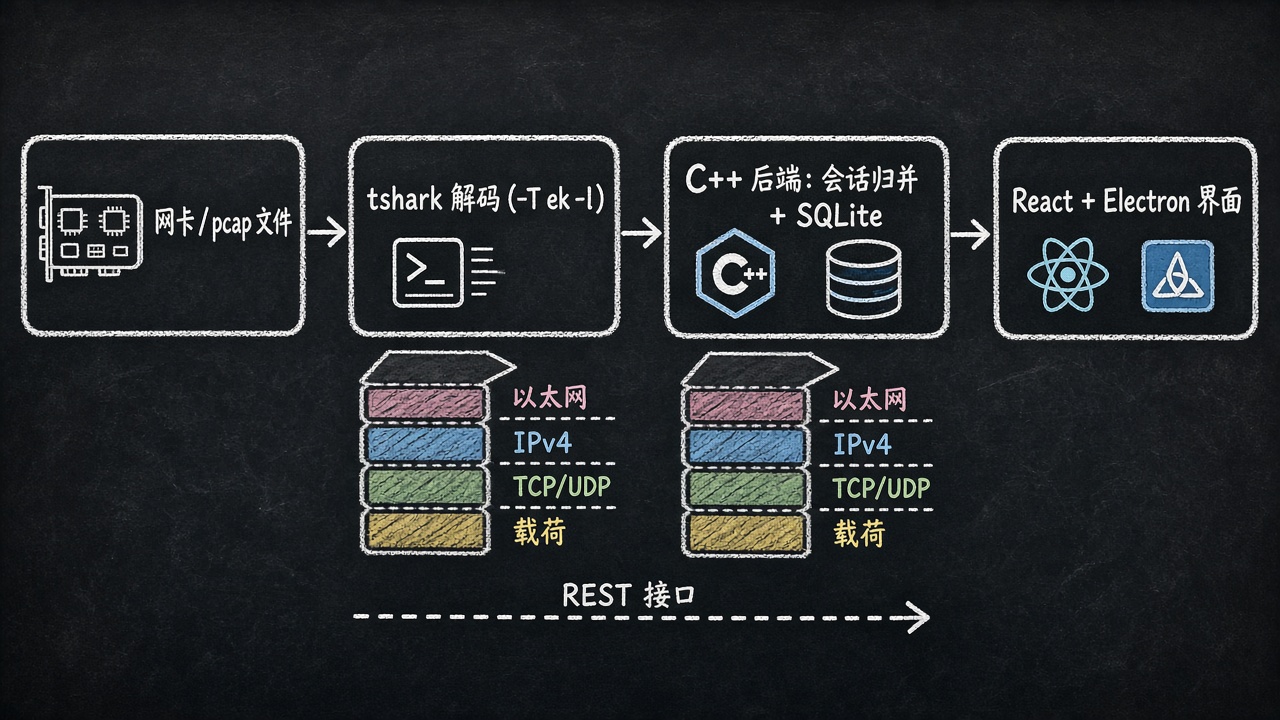
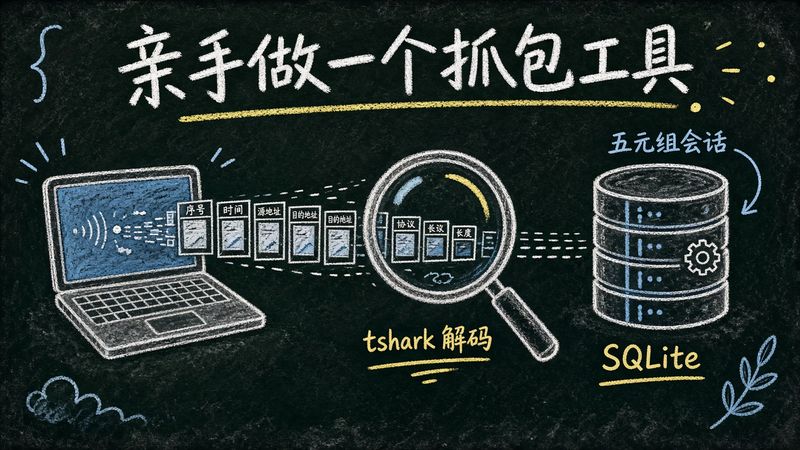
自己从零写协议解析器是无底洞,Wireshark 支持的协议解析器数以千计。EasyTshark 的思路是把解码外包给 tshark,后端只做 tshark 不擅长的事:

这条链路里,后端的职责有四块:
1. 进程管理:启动、停止 tshark,处理它的退出码和标准错误输出;
2. 流式解析:按行读取 tshark 输出,不能等全部结束再处理;
3. 会话归并:把同一条连接的双向数据包归到一起,统计包数、字节数、时长;
4. 存储与查询:落库后通过接口按协议、地址、时间段分页返回给前端。
三、tshark 的输出格式怎么选
tshark 的 -T 参数决定输出格式,官方手册列出的取值有 ek、fields、json、jsonraw、pdml、ps、psml、tabs、text。做工具时最常用的是下面三种:
-T fields:配合-e指定字段,按分隔符输出一行一个包,体积最小、解析最简单,适合列表视图;-T json:输出完整的协议树,信息最全,但它是一个大 JSON 数组,必须读完才能解析,大文件会把内存撑爆;-T ek:换行分隔的 JSON(为 Elasticsearch 批量导入设计),每个包是独立的一行,可以流式解析,同时保留协议细节。
列表视图用 fields,点开单个包看详情时再用 json 或 ek 取那一个包的协议树,是比较均衡的做法。读离线文件的典型命令:
tshark -r capture.pcap -l -T fields -E separator=/t -E header=n \
  -e frame.number -e frame.time_epoch -e frame.len -e frame.protocols \
  -e ip.src -e ip.dst -e tcp.srcport -e tcp.dstport -e udp.srcport -e udp.dstport
几个参数值得单独说:
-l让 tshark 每输出一个包就刷新一次标准输出。不加它,管道另一端的后端会因为缓冲而“一顿一顿”地收到数据,实时抓包界面就会卡;-Y是显示过滤器(如-Y "tcp.port == 443"),语法与 Wireshark 界面一致;-f是抓包过滤器(BPF 语法),只在实时抓包时生效;-q -z conv,tcp直接输出 TCP 会话统计,可以用来校验自己的会话归并结果;- 字段名记不住时,用
tshark -G fields导出全部字段清单再搜索。
四、后端:用管道把 tshark 接进 C++
C++ 后端调用 tshark 的核心就是“起子进程、读管道、逐行处理”。下面是一个 POSIX 平台上的最小骨架,Windows 上把 popen/pclose 换成 _popen/_pclose 即可:
#include <cstdio>
#include <memory>
#include <sstream>
#include <string>
#include <vector>

struct Packet {
    long no; double ts; int len;
    std::string protocols, src, dst;
    int sport = 0, dport = 0;
};

static std::vector<std::string> split(const std::string& line, char sep) {
    std::vector<std::string> out;
    std::stringstream ss(line);
    std::string item;
    while (std::getline(ss, item, sep)) out.push_back(item);
    return out;
}

bool readPackets(const std::string& pcap, void (*onPacket)(const Packet&)) {
    std::string cmd = "tshark -r '" + pcap + "' -l -T fields -E separator=/t "
                      "-e frame.number -e frame.time_epoch -e frame.len -e frame.protocols "
                      "-e ip.src -e ip.dst -e tcp.srcport -e tcp.dstport "
                      "-e udp.srcport -e udp.dstport 2>/dev/null";
    std::unique_ptr<FILE, decltype(&pclose)> pipe(popen(cmd.c_str(), "r"), pclose);
    if (!pipe) return false;

    char buf[4096];
    while (fgets(buf, sizeof(buf), pipe.get())) {
        std::string line(buf);
        if (!line.empty() && line.back() == '\n') line.pop_back();
        auto f = split(line, '\t');
        f.resize(10);
        Packet p{std::stol(f[0]), std::stod(f[1]), std::stoi(f[2]), f[3], f[4], f[5]};
        const std::string& sp = !f[6].empty() ? f[6] : f[8];
        const std::string& dp = !f[7].empty() ? f[7] : f[9];
        if (!sp.empty()) p.sport = std::stoi(sp);
        if (!dp.empty()) p.dport = std::stoi(dp);
        onPacket(p);
    }
    return true;
}
这段代码里藏着几个真实项目一定会遇到的问题:
- 命令拼接有注入风险:文件名来自用户时,用
fork + execvp(Windows 上用CreateProcess)传参数数组,而不是拼 shell 字符串; - 停止抓包要能杀进程:实时抓包时 tshark 不会自己退出,后端要保存子进程 PID,停止时发
SIGTERM(Windows 用TerminateProcess); - 读取要放在独立线程:管道读取是阻塞的,主线程还要响应 HTTP 请求,通常一个读线程往线程安全队列里塞数据,另一个线程批量写库;
- 批量写库:SQLite 每条一次事务会慢到无法接受,攒几百条在一个事务里提交,吞吐能差出一两个数量级。
五、拆开 pcap 文件:24 字节文件头加一串记录
即使解码交给 tshark,理解 pcap 文件格式依然很有价值:做文件校验、快速统计包数、截取片段时都用得上。经典 pcap 格式非常简单:
- 全局头 24 字节:魔数
0xA1B2C3D4(4 字节)、主次版本号(2+2)、时区修正与时间戳精度(4+4)、最大抓取长度 snaplen(4)、链路层类型(4,以太网为 1); - 每条记录 16 字节头:秒、微秒、实际保存长度
incl_len、原始长度orig_len,后面紧跟incl_len字节的帧数据。
魔数同时承担了字节序探测的职责:按小端读出来是 0xA1B2C3D4 说明文件是小端写的;读出来是 0xD4C3B2A1 就要按大端处理。如果魔数是 0xA1B23C4D,则时间戳的小数部分是纳秒而不是微秒。
需要注意,新版 Wireshark 和 tshark 默认保存的是 pcapng 格式,它是块结构,与上面的经典格式不兼容。自己的解析器只支持 pcap 时,可以在保存时加 -F pcap,或用 editcap -F pcap in.pcapng out.pcap 转换。
帧数据本身按层剥开即可:以太网头 14 字节,最后 2 字节的类型字段 0x0800 表示 IPv4;IPv4 头的长度由第一个字节低 4 位(IHL)乘以 4 得到;TCP 头长度由第 13 个字节高 4 位(数据偏移)乘以 4 得到;标志位在第 14 个字节。
六、动手实验:一个脚本跑通“写包、解包、归并、入库”
配套脚本 practice/demo_pcap_sessions.py 只依赖 Python 标准库,不需要安装 tshark,也不需要 root 权限。它做了六件事:
1. 手工构造 8 个以太网帧(一次 DNS 查询应答、一条完整的 HTTP 短连接),按经典格式写成 pcap 文件;
2. 按上一节的格式逐条读回记录,并根据魔数判断字节序;
3. 逐层解析以太网、IPv4、TCP/UDP 头,取出五元组、TCP 标志位和载荷;
4. 把双向数据包按排序后的“地址+端口”归并成同一个会话,写入内存中的 SQLite;
5. 用 SQL 完成会话统计,用 SYN 与 SYN|ACK 的时间差算出握手 RTT,拼接载荷还原 HTTP 请求首行;
6. 组装成一个 REST 接口风格的 JSON 响应。
会话归并的关键只有一行:把 (源地址, 源端口) 和 (目的地址, 目的端口) 排序后再拼成键,这样请求和响应方向的包会落在同一个会话里。
def session_key(p):
    a, b = (p["src"], p["sport"]), (p["dst"], p["dport"])
    lo, hi = sorted([a, b])
    return f'{p["proto"]} {lo[0]}:{lo[1]} <-> {hi[0]}:{hi[1]}'
运行结果:
$ python3 demo_pcap_sessions.py
[1] 写出 /tmp/demo_capture.pcap,共 8 帧,684 字节
[2] 逐包解析(等价于 tshark -r demo_capture.pcap -T fields -e frame.number -e ip.src ...)
    #1 UDP 192.168.1.10:53000 -> 8.8.8.8:53          payload=29B
    #2 UDP 8.8.8.8:53 -> 192.168.1.10:53000          payload=29B
    #3 TCP 192.168.1.10:51514 -> 93.184.216.34:80 SYN      payload=0B
    #4 TCP 93.184.216.34:80 -> 192.168.1.10:51514 SYN|ACK  payload=0B
    #5 TCP 192.168.1.10:51514 -> 93.184.216.34:80 ACK      payload=0B
    #6 TCP 192.168.1.10:51514 -> 93.184.216.34:80 ACK|PSH  payload=47B
    #7 TCP 93.184.216.34:80 -> 192.168.1.10:51514 ACK|PSH  payload=19B
    #8 TCP 192.168.1.10:51514 -> 93.184.216.34:80 ACK|FIN  payload=0B
[3] 会话统计(等价于 tshark -q -z conv,tcp / conv,udp)
    UDP 192.168.1.10:53000 <-> 8.8.8.8:53          包数=2 字节=142 时长=20.2ms
    TCP 192.168.1.10:51514 <-> 93.184.216.34:80    包数=6 字节=390 时长=90.0ms
[4] TCP 握手 RTT ≈ 31.0 ms
[5] 还原 HTTP 首行:GET /index.html HTTP/1.1
全部校验通过
(第 6 步的 JSON 输出较长,这里省略。)生成的 /tmp/demo_capture.pcap 是标准格式,装了 Wireshark 的话可以直接打开,对照着看每个字段在图形界面里的位置;也可以执行 tshark -r /tmp/demo_capture.pcap -q -z conv,tcp,核对脚本的会话统计是否一致。
七、落地排坑清单
- 抓包权限:Linux 上不要用 root 跑整个后端,正确做法是把用户加入
wireshark组,或给dumpcap授权:sudo setcap cap_net_raw,cap_net_admin+eip $(which dumpcap)。tshark 实时抓包时实际是调用 dumpcap 完成的; - Windows 依赖 Npcap:安装 Wireshark 时勾选 Npcap,否则
tshark -D列不出网卡; - 不要整包读
-T json:几百 MB 的抓包文件转成 JSON 数组可能膨胀十倍以上,列表视图坚持用fields,详情按需取单包; - 字段可能为空:UDP 包没有
tcp.srcport,ARP 包没有ip.src,解析时每一列都要允许为空,上面的 C++ 骨架用resize(10)兜底就是为此; - 同一个包可能有多值字段:隧道或 IP-in-IP 场景下
ip.src会出现多个值,用-E occurrence=f只取第一个; - 时间戳精度:
frame.time_epoch是带小数的字符串,存库时用双精度或拆成秒加纳秒两个整数,避免排序错乱; - 会话超时:同一五元组可能在不同时间段复用(短连接端口复用),归并时要加空闲超时或以 SYN 作为新会话起点;
- 跨平台路径与编码:Windows 下文件名含中文时,管道两端的编码要统一成 UTF-8。
八、总结
做一个抓包工具,最有价值的不是界面多好看,而是逼着你把几块知识真正接起来:协议头是怎么按字节排布的,子进程和管道怎么协作,流式数据怎么落库,会话怎么从单个包里“长”出来。tshark 把最难的协议解码包办了,剩下的编排工作恰好是检验 C/C++ 和网络基础最好的考题。
建议先跑一遍本文的脚本,看懂每个字节的含义,再把解析部分换成调用真实的 tshark,最后接上前端。走完这条路,再看到 TCP 三次握手,你脑子里浮现的就不再是课本上的图,而是你亲手解出来的三行记录。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。