静态规则撞上大模型幻觉?解析智能代码审查 Agent 的 AST 与 RAG 双轨架构
在研发流水线中,代码审查(Code Review)始终是守护生产稳定性的核心屏障。然而,传统静态代码分析工具(如 SonarQube、Checkstyle、PMD 与 Semgrep)虽然规则严格、速度极快,却只能死板地比对语法树特征,面对跨方法的业务逻辑时往往产生大量机械误报,难以理解真实的上下文意图。
随着大语言模型(LLM)的兴起,许多团队尝试引入 AI 自动化审查。但纯粹依赖大模型的 Prompt 方案很快暴露了另一面极端:大模型缺乏确定的语法约束,容易产生严重幻觉;动辄将数千行源码完整喂入 Prompt,不仅上下文 Token 成本高昂,模型甚至会信口开河指出莫须有的 Bug,或是对基础命名规范胡乱挑刺。
面向严肃的企业级研发场景,开源代码审查智能体 CodeGuardian AI 给出了破局方案:将传统 AST 静态语法解析与 LLM 上下文推理深度解耦,构建规则引擎与 RAG 知识库双轨协同审查架构。
一、双轨设计哲学:确定性规则与语义推理的边界划分
代码审查中的问题通常可划分为两类:“纯确定性语法反模式”与“强上下文语义缺陷”。
1. 确定性规范与语法反模式(交给规则引擎):- 比如未闭合的 I/O 流、硬编码的 API 密钥、空的 catch (Exception e) {} 块、违反驼峰命名。此类问题拥有确凿的 AST 判定依据,毫秒级即可定位,无需消耗昂贵的 LLM 算力,更不容许模型存在概率性误报。
2. 跨模块业务与并发隐患(交给 LLM + RAG):- 比如订单状态机流转是否缺少分布式幂等防重、RPC 接口调用超时重试是否可能引发雪崩、Spring 声明式事务在内部私有方法中是否失效。此类隐患需要结合团队特定的架构规范与业务语义进行多跳推断。
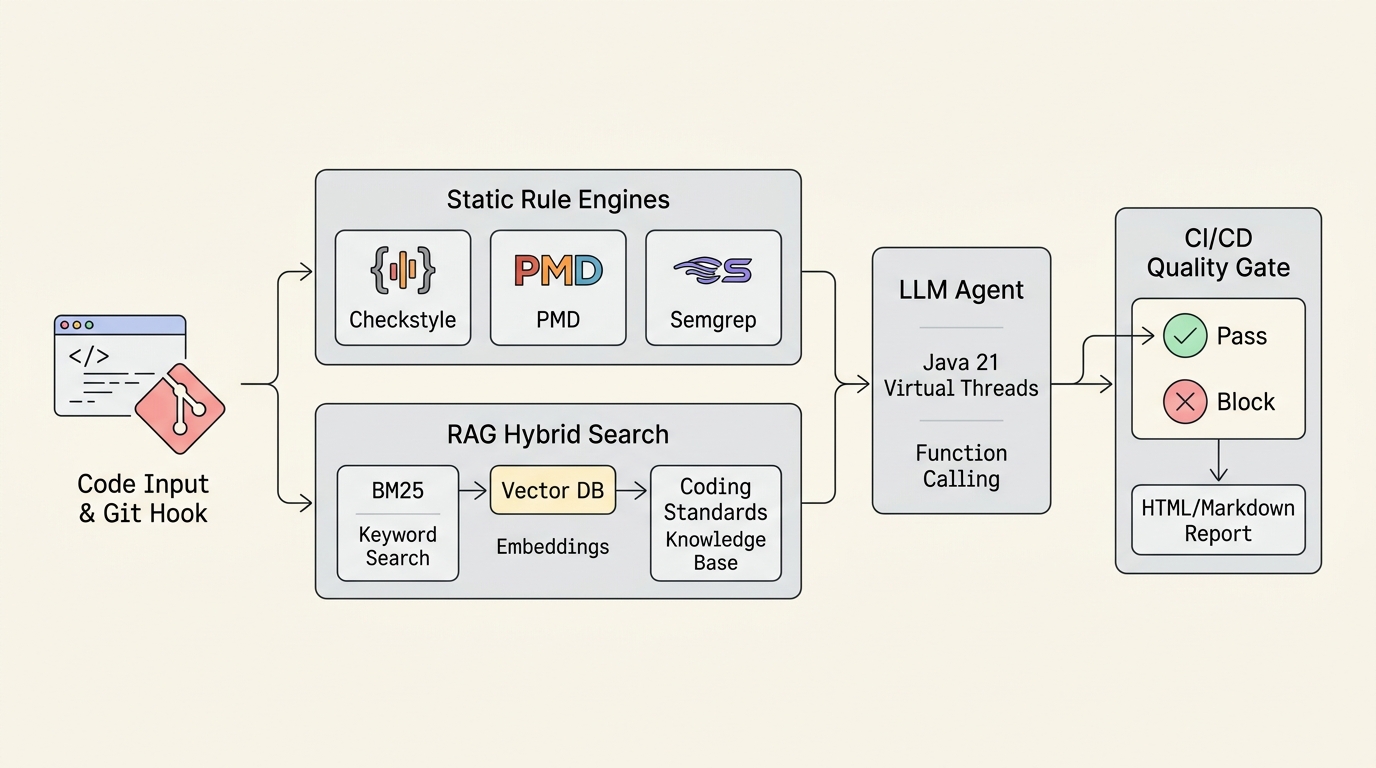
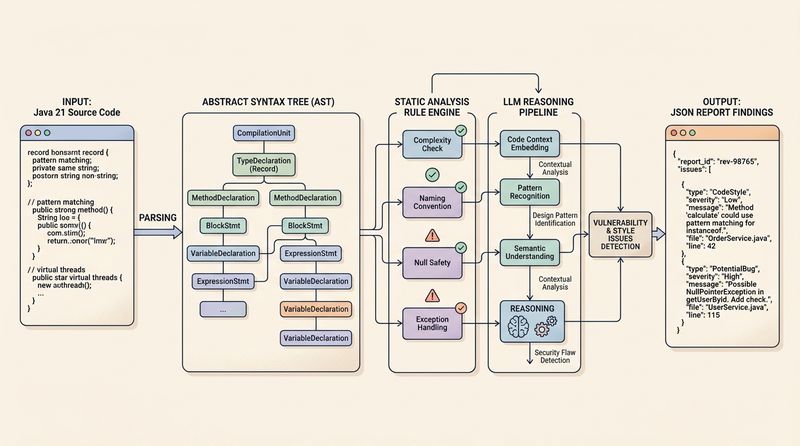
CodeGuardian 的核心流程是:AST 静态先行裁剪 -> 规则引擎前置过滤 -> RAG 规范精准召回 -> LLM 结构化判定。这种流水线使输入大模型的代码片段缩减了 80% 以上,同时保证了审查结果的绝对一致性。
二、核心技术实现解密
1. JavaParser / Tree-sitter 语法树细粒度切片
在输入代码进入审查流程前,系统利用 JavaParser(或 Tree-sitter 多语言解析器)将待审文件构建为抽象语法树(CompilationUnit)。
解析器不仅提取类与方法签名,还会根据 Git 提交记录中的 Diff 范围,精准计算出“受影响的最小 AST 节点(MethodDeclaration / BlockStmt)”。通过在 AST 级别进行拓扑遍历,静态规则引擎(PMD/Semgrep)可以直接在语法节点上执行 Lint 规则校验,筛除 90% 的低级规范违规。
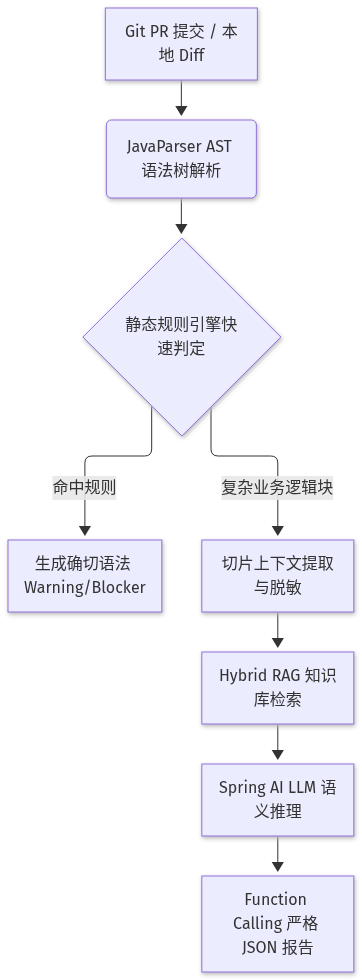
2. Hybrid RAG:企业规范库精准对齐
许多通用大模型审查之所以“不对味”,是因为它不知道团队内部的特定架构规范。CodeGuardian 引入了 Hybrid RAG(混合检索)管道:
- BM25 关键词检索:匹配特定的类名、注解(如
@Transactional、@Idempotent)与中间件 SDK。 - pgvector 向量语义检索:将团队历史代码审查排坑记录(如历史事故复盘文档、微服务调用治理规范)切块向量化,通过相似度召回最相关的准则。
- Rerank 重排:合并两路检索得分,仅提取 Top-3 最精准的规范要点注入 Agent Prompt,彻底杜绝了大模型在宽泛知识下的自由发散。
3. Spring AI Function Calling 强制结构化输出
为了阻断大模型的自由发挥,CodeGuardian 在与大模型交互时强依赖 Function Calling(工具调用) 模式。
定义严格的 JSON Schema 数据结构(ReviewFinding),强制模型必须填充字段:
- rule_id: 规范编号
- severity: 严重级别(BLOCKER / CRITICAL / MAJOR / MINOR)
- line_number: 源码行号
- component: 归属组件模块
- message: 问题简述
- suggestion: 可执行的具体重构代码
任何未能通过 Schema 校验的输出将被即时抛弃并触发重试,确保审查报告能够无缝对接到自动化流水线。
4. Java 21 虚拟线程(Loom)高并发分析吞吐
在企业级代码库中,一个大型 Pull Request 可能涉及数十个甚至上百个源码文件的变动。传统的单线程或固定线程池在面对外部 LLM API 几十秒的网络 I/O 延迟时容易阻塞枯竭。
CodeGuardian 底层全面采用 Java 21 虚拟线程(Virtual Threads):
// 使用 Java 21 虚拟线程并发处理多文件 AST 分析与模型请求
try (var executor = Executors.newVirtualThreadPerTaskExecutor()) {
    List<Future<FileReviewResult>> futures = files.stream()
        .map(file -> executor.submit(() -> processSingleFileReview(file)))
        .toList();
    for (var future : futures) {
        aggregateReport.merge(future.get());
    }
}
虚拟线程让系统能够在极轻量的系统资源下并发发起上百路语义审查,使得整个模块的综合审查耗时缩短至与常规单元测试相同量级。
三、实战原型演示:规则引擎与语义审查的结合
在实际落地中,通过 Python 或 Java 实现轻量级的双轨质检管道十分清晰。以下是一个验证 AST 静态捕获与语义审查相结合的原型实现:
import ast
from dataclasses import dataclass

@dataclass
class Finding:
    rule_id: str
    severity: str
    line: int
    message: str

class AstSecurityInspector(ast.NodeVisitor):
    def __init__(self):
        self.findings = []

    def visit_ExceptHandler(self, node):
        # 拦截空 catch 块与吞掉顶层异常
        if node.type is None or (isinstance(node.type, ast.Name) and node.type.id in ("Exception", "BaseException")):
            if len(node.body) == 1 and isinstance(node.body[0], ast.Pass):
                self.findings.append(Finding(
                    rule_id="RULE-SEC-001",
                    severity="CRITICAL",
                    line=node.lineno,
                    message="捕获全局 Exception 并静默忽略,可能隐藏致命错误。"
                ))
        self.generic_visit(node)
当静态解析器在毫秒级截获阻断级代码错误后,流水线可直接阻断,无需发起后续大模型调用;仅当代码通过基础门禁时,才将核心片段送入 LLM 执行更高级别的业务语义审查。
四、工程落地启示
从单一的大模型 Prompt 玩法转向“静态规则筑基 + RAG 知识对齐 + Agent 语义收敛”的双轨架构,是 AI 赋能软件研发从“玩具 Demo”走向“企业级生产”的必然演进路径。
通过明确划分确定性规则与概率推理的边界,研发团队既能享受静态代码检测的毫秒级精确拦截,又能借力大模型理解跨业务架构隐患,让智能代码审查真正成为开发者的坚实副驾。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。