解构企业级文档知识库:深入剖析 KY KMS 的 Elasticsearch 倒排检索与权限分层架构
项目规格书、技术白皮书、合同、审计凭证、内部制度……企业里的非结构化文档每年都在成倍增长。它们散落在文件服务器、网盘、部门共享目录和个人电脑里,形成典型的“知识孤岛”。真正需要时,员工面对的往往是三个问题:找不到、搜不准、不该看的也能看到。
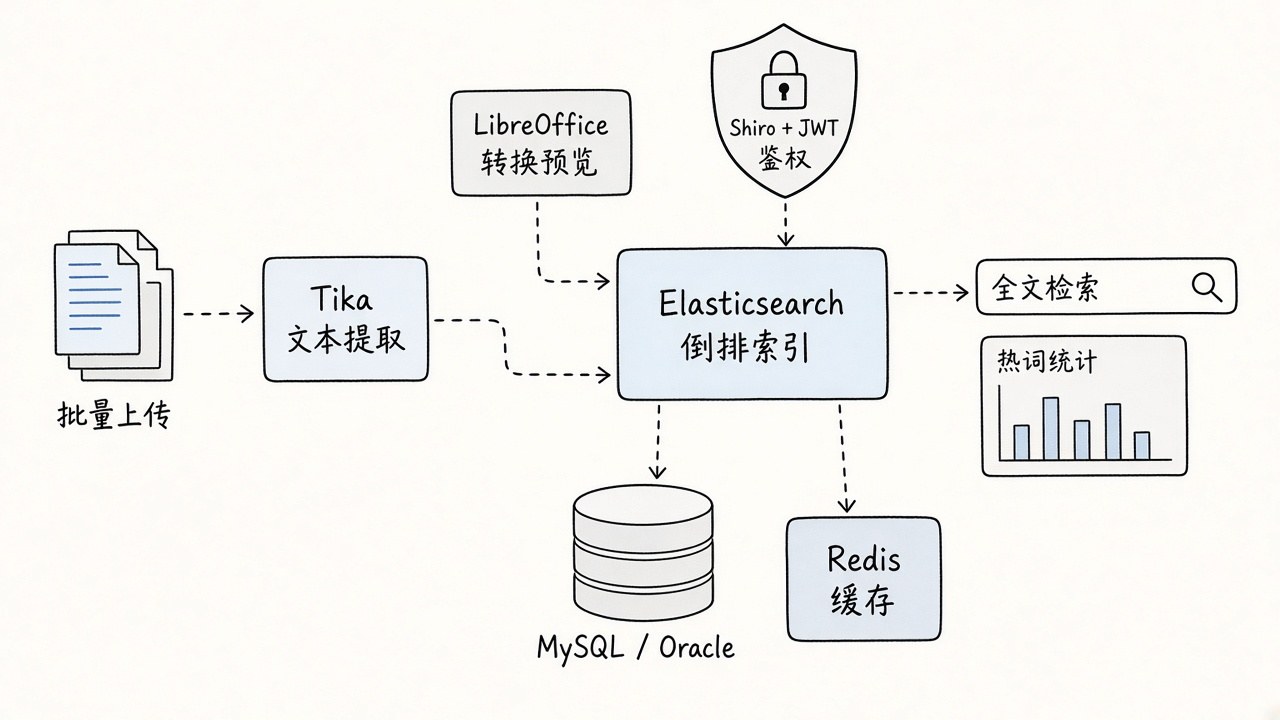
开源项目 KY KMS(科亿知识库) 是一个面向这一场景的文档型知识库管理系统。它以 Elasticsearch 为检索核心,配合 Apache Tika 文本提取与 LibreOffice 文档转换,提供全文检索、高级检索、知识专题、批量上传与热词统计等能力,关系数据库支持 MySQL、Oracle 与 SQL Server。
本文从技术栈出发,拆解它的文档入库链路、Elasticsearch 索引设计和权限体系,并给出在此基础上二次开发时值得关注的工程要点。
一、企业知识库为什么不能只靠关系数据库
在讨论 KY KMS 之前,先看清传统 CRUD 系统在文档检索上的三个天然瓶颈:
1. 模糊查询的性能悬崖:关系数据库处理长文本时依赖 LIKE '%关键词%',这种前后模糊匹配无法使用 B+ 树索引,数据量一大就退化为全表扫描。
2. 多格式解析断层:企业文档包括 PDF、DOC/DOCX、XLS/XLSX、PPT、纯文本等,要先把正文从各种二进制格式里“抠”出来,才谈得上检索。这不是业务 CRUD 代码擅长的事。
3. 权限与检索的冲突:检索追求“全量召回、精准排序”,安全要求“按部门、按角色隔离”。如果先检索再在应用内存里逐条过滤,分页总数和排序都会失真。
所以一个合格的知识库,至少要把三件事拆开:文本提取交给专门的解析库,检索与排序交给倒排索引引擎,身份与权限交给安全框架,并让后两者在查询时正确协作。KY KMS 的技术选型基本就是按这个思路组织的。
二、技术栈全景:一套典型的 Java 企业级组合
根据项目公开的技术说明,KY KMS 的技术栈如下:
| 层次 | 组件 | 版本 / 说明 |
|---|---|---|
| 语言与构建 | Java、Maven | Java 8 |
| 基础框架 | Spring Boot | 2.3.5.RELEASE |
| 持久层 | MyBatis-Plus | 3.4.1 |
| 检索引擎 | Elasticsearch | 7.6.1 |
| 文本提取 | Apache Tika | 1.17 |
| 文档转换 | LibreOffice | 7.1.4,用于格式转换与在线预览 |
| 安全认证 | Apache Shiro + JWT | Shiro 1.7.0,JWT 3.11.0 |
| 连接池 / 缓存 | Druid、Redis | Druid 1.1.22 |
| 定时任务 | Quartz | 定时任务调度 |
| 关系数据库 | MySQL 5.7+ / Oracle 11g / SQL Server 2017 | 多数据库支持 |
| 前端 | Vue 2.6、Vuex、Vue Router、ant-design-vue | AntV G2 / Viser 做统计图表 |
几点值得留意:
- 这是一套“稳”而不是“新”的组合。Spring Boot 2.3 与 Elasticsearch 7.6 都已不是最新版本,但对私有化部署的企业内网系统来说,成熟、资料多、运维人员熟悉,往往比追新更重要。二次开发时如果计划升级到 Spring Boot 3,需要同步迁移到 Java 17 和 Jakarta 命名空间,工作量不小。
- Tika 与 LibreOffice 分工不同。Tika 负责“读出文字”供索引使用;LibreOffice 负责“转换格式”,例如把 Office 文档转成 PDF 以便浏览器内预览。两者都比较吃资源,是部署时需要单独评估的部分。
- Shiro + JWT 是无状态鉴权的常见搭配:Shiro 负责权限模型与注解式校验,JWT 让前后端分离场景下的接口调用不依赖服务端会话。
三、文档入库链路:从文件到倒排索引
一个文档从上传到可被搜索,大致经历以下几步:
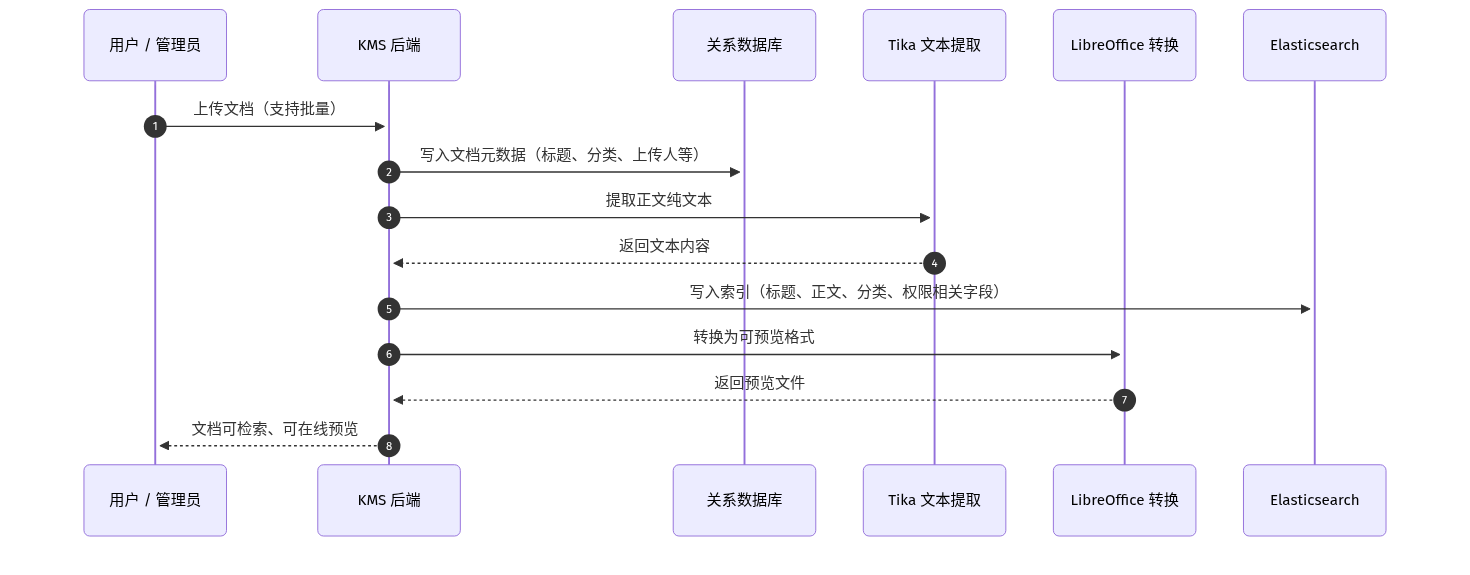
这条链路里最容易出问题的是“提取”和“转换”两步:
- 扫描件没有文字层:Tika 只能读出文件中本来就存在的文本,扫描版 PDF 和图片提取结果为空。若这类文档比例高,需要额外接入 OCR(例如 Tika 搭配 Tesseract),否则它们永远搜不到。
- 大文件与异常文件:几百页的 PDF、带宏或损坏的 Office 文件都可能让解析耗时飙升甚至卡死。生产环境中建议为解析设置超时和文件大小上限,并把解析放到独立线程池或队列中,避免拖垮 Web 请求线程。
- 批量上传要考虑幂等:按文件内容计算哈希(如 SHA-256)去重,可以避免同一份文件被重复入库、重复索引。
四、Elasticsearch 索引设计:分词决定了能不能搜准
Elasticsearch 能做到快速全文检索,靠的是倒排索引:先把文本切成词条(Term),再记录每个词条出现在哪些文档里。对中文来说,怎么切词直接决定了搜索质量。
Elasticsearch 自带的标准分词器会把中文按单字切开,“知识库”变成“知”“识”“库”三个词条,召回多、精度差。中文场景通常会安装 IK 分词插件,并采用“建索引细、查询粗”的策略。下面是一份适合知识库场景的 Mapping 示例(基于 IK 插件,供二次开发参考):
{
  "settings": {
    "number_of_shards": 3,
    "number_of_replicas": 1,
    "analysis": {
      "analyzer": {
        "kms_index_analyzer": { "type": "custom", "tokenizer": "ik_max_word", "filter": ["lowercase"] },
        "kms_search_analyzer": { "type": "custom", "tokenizer": "ik_smart", "filter": ["lowercase"] }
      }
    }
  },
  "mappings": {
    "properties": {
      "doc_id": { "type": "keyword" },
      "title": {
        "type": "text",
        "analyzer": "kms_index_analyzer",
        "search_analyzer": "kms_search_analyzer",
        "fields": { "keyword": { "type": "keyword", "ignore_above": 256 } }
      },
      "content": {
        "type": "text",
        "analyzer": "kms_index_analyzer",
        "search_analyzer": "kms_search_analyzer",
        "term_vector": "with_positions_offsets"
      },
      "category_id": { "type": "keyword" },
      "department_ids": { "type": "keyword" },
      "security_level": { "type": "integer" },
      "updated_at": { "type": "date" }
    }
  }
}
设计要点:
- 建索引用
ik_max_word,查询用ik_smart:写入时尽可能细地切词以提高召回,查询时用较粗的切分减少无关命中。 - 过滤字段用
keyword:分类、部门、作者这类字段只做精确匹配,不需要分词,keyword类型更省空间,也能用于聚合统计(比如热词、分类分布)。 - 正文开启
term_vector:高亮时可以直接利用词条位置信息定位片段,长文档的高亮性能会好很多,代价是索引体积增大,需要权衡。 - 自定义词典很关键:企业内部的产品代号、项目名、缩写,IK 默认词典里都没有。把它们加入扩展词典,往往比调任何打分参数都更能提升“搜准率”。
五、权限分层:让检索结果天然只包含“能看的”
KY KMS 使用 Shiro + JWT 完成身份认证和接口级权限控制:谁能登录、谁能进入管理后台、谁能上传和编辑文档。但对知识库来说,还有一层更细的问题:同一个搜索框,不同部门的人搜同一个词,结果应该不同。
最直观的做法是“先搜后滤”:Elasticsearch 返回前 N 条,应用层再逐条判断当前用户能不能看。这种做法有两个硬伤:一页 10 条可能被过滤得只剩 2 条;“共找到 X 条结果”的总数也不再准确。
更稳妥的做法是把权限条件下推到 Elasticsearch 查询本身,作为 bool 查询的 filter 子句。以下是在 KY KMS 这类 Spring Boot + ES 7 项目中二次开发时的参考写法:
public SearchRequest buildSecureSearchRequest(String keyword, UserContext user, int pageNum, int pageSize) {
    BoolQueryBuilder query = QueryBuilders.boolQuery()
        .must(QueryBuilders.multiMatchQuery(keyword, "title^3", "content"))
        // 部门白名单:用户所在部门或全员公开
        .filter(QueryBuilders.termsQuery("department_ids", user.getDepartmentId(), "PUBLIC"))
        // 密级:文档密级不得高于用户可见级别
        .filter(QueryBuilders.rangeQuery("security_level").lte(user.getSecurityLevel()));

    SearchSourceBuilder source = new SearchSourceBuilder()
        .query(query)
        .from((pageNum - 1) * pageSize)
        .size(pageSize)
        .highlighter(new HighlightBuilder()
            .field("title")
            .field("content")
            .fragmentSize(150)
            .numOfFragments(2));

    return new SearchRequest("kms_document_index").source(source);
}
这样写有三个好处:
1. 分页和总数准确:不可见的文档从一开始就不参与命中计算。
2. 不影响相关度排序:filter 子句只做“是否匹配”的判断,不参与打分,排序仍由关键词匹配决定。
3. 可被缓存:Elasticsearch 会对频繁使用的过滤条件做缓存,部门、密级这类取值有限的条件命中率很高。
⚠️ 边界提醒:权限字段写进索引后,文档权限变更(如调整可见部门)必须同步更新 Elasticsearch 中的对应文档,否则会出现“数据库里已收回权限、搜索里仍然能看到”的窗口期。建议把权限变更和索引更新放在同一个业务流程中,并配合定期全量校对任务(KY KMS 已集成 Quartz,可直接复用)。
六、实战验证:用 100 行 Python 模拟权限过滤检索
为了直观感受“倒排索引 + 权限过滤”的效果,我们编写了一个不依赖 Elasticsearch 的模拟脚本 practice/demo_es_indexer_pipeline.py:它对中文做二元切分来近似细粒度分词,构建倒排表,并在检索时按部门白名单过滤。
python3 practice/demo_es_indexer_pipeline.py
运行输出:
=== KY KMS 文档检索与权限过滤演练开始 ===
已构建索引: [DOC_001] 分布式微服务集群容灾部署规范手册
已构建索引: [DOC_002] 财务系统审计报表与季度税务结算规范
已构建索引: [DOC_003] 企业级 Elasticsearch 分词器优化与索引生命周期管理

--- 场景 A:研发人员 (DEPT_RND) 搜索 'Elasticsearch 索引' ---
匹配数量: 1
  -> 得分: 9.0 | 标题: 企业级 Elasticsearch 分词器优化与索引生命周期管理 | 高亮: ['...在海量文档检索场景下,中文<em>索引</em>建议采用 ik_max_word 做建<em>索引</em>分词、i...']

--- 场景 B:研发人员 (DEPT_RND) 尝试搜索财务机密 '财务 审计' ---
匹配数量: 0 (应被部门隔离权限自动拦截,返回空列表)

--- 场景 C:财务人员 (DEPT_FINANCE) 搜索 '财务 审计' ---
匹配数量: 1
  -> 得分: 7.0 | 标题: 财务系统审计报表与季度税务结算规范 | 高亮: ['...<em>财务</em>季报与流水对账应严格遵循跨部门审批流,敏感字段需通...']

=== 实战演练验证顺利完成 ===
场景 B 是关键:研发人员即使输入了完全匹配的关键词,财务文档也不会出现在结果里,因为它在过滤阶段就被排除了,而不是“搜出来再藏起来”。
七、部署与调优建议
把 KY KMS 部署到生产环境时,以下几点建议提前规划:
1. 资源分开评估:Elasticsearch、LibreOffice 转换和 Tika 解析都是“吃内存”的组件。小规模试用可以单机部署,文档量上来后建议把 Elasticsearch 独立部署,并给文档转换预留单独的 CPU 和内存。
2. Elasticsearch 堆内存:堆内存一般不超过物理内存的一半,且不要超过约 31GB(超过后 JVM 无法使用压缩指针,反而更浪费)。剩余内存留给操作系统做文件缓存,Lucene 索引文件能被缓存在内存中时检索最快。
3. IK 插件版本必须与 ES 严格对应:ES 7.6.1 需要安装同版本号的 IK 插件,版本不一致会直接导致节点启动失败。
4. 修改默认账号:项目默认管理员账号为 admin / 123456,部署后第一件事就是修改密码,并检查是否有其他演示账号。
5. 定期备份索引与原文件:索引可以由原文件重建,但重建耗时很长。建议同时备份数据库、原始文件目录,并对 Elasticsearch 配置快照仓库。
八、总结
KY KMS 的价值在于提供了一套“开箱可用”的企业文档知识库骨架:Tika 和 LibreOffice 解决多格式解析与预览,Elasticsearch 解决全文检索与统计,Shiro + JWT 解决认证与接口权限,Vue 2 + ant-design-vue 提供管理后台和检索门户。技术栈不算新,但每一块都是久经考验的成熟组件,适合私有化部署和二次开发。
如果要在此基础上继续演进,最值得投入的方向有三个:一是补齐 OCR,让扫描件也能被搜到;二是把文档级权限下推到检索查询中,保证结果天然合规;三是在关键词检索之外引入向量检索,与现有倒排索引做混合召回,为后续接入大模型问答(RAG)打好基础。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。
本文首发于边学边练技术中台:https://www.skillup.host/bxbl/6395.html