PB 级日志索引直接存 S3?深入剖析 Rust 云原生搜索引擎 Quickwit 的存算分离架构
在大规模可观测性与数据分析场景中,海量日志、链路追踪(Traces)与事件流的数据量往往呈指数级膨胀。传统以 Elasticsearch / OpenSearch 为代表的搜索引擎,虽具备成熟的倒排检索能力,但在 PB 级规模下却让无数运维团队苦不堪言:昂贵的高性能本地 SSD、JVM 垃圾回收(GC)引发的查询抖动、集群分片迁移重平衡(Rebalance)时的雪崩风险,以及动辄数倍副本带来的天价账单。
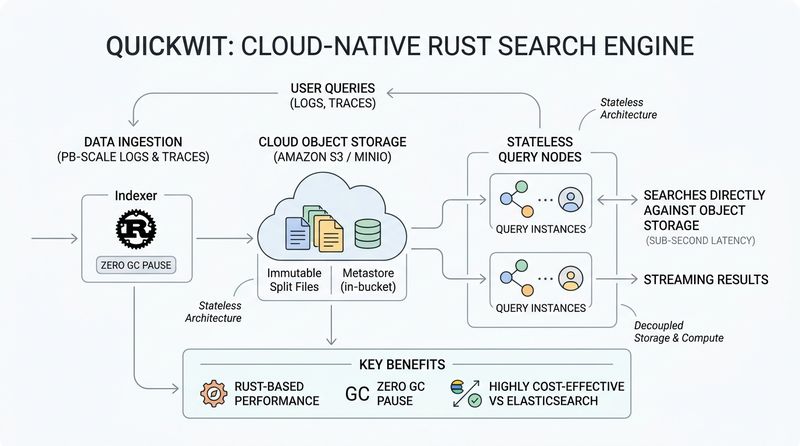
在这一背景下,基于 Rust 编写的开源云原生分布式搜索引擎 Quickwit(GitHub 狂揽 8k+ Stars)脱颖而出。它颠覆了传统搜索引擎依赖本地高性能存储的范式,直接将对象存储(如 Amazon S3、MinIO)作为唯一主存储,实现了极致的存算分离与十倍级降本。
一、传统搜索引擎的阿喀琉斯之踵
要理解 Quickwit 的架构创新,首先需要复盘传统分布式搜索引擎在大规模日志场景下的底层矛盾:
1. 存算耦合与本地磁盘绑定:Elasticsearch 等系统假定数据必须持久化在节点的本地文件系统中。为了应对突发读写,节点必须配置昂贵的 NVMe SSD。当存储容量见顶时,团队必须增加昂贵的计算节点来扩充磁盘,造成算力严重浪费。
2. JVM 运行时开销与长停顿:Java 运行时的垃圾回收机制在大堆内存(如 32GB 甚至 64GB 堆)和高频缓存失效时,容易发生数十秒的 Stop-The-World 暂停,直接拖垮高可用集群的 SLA。
3. 集群状态同步与重平衡灾难:当某个数据节点短暂宕机或网络分区时,集群元数据同步(Master 选举与分片重分配)会引发海量数据在节点间跨网复制,极易引发次生网络风暴。
Quickwit 从第一天起便确立了核心设计目标:存储直接卸载至对象存储,计算节点保持绝对无状态,用 Rust 追求零 GC 开销与极致资源利用率。
二、Quickwit 核心架构拆解:如何做到 S3 上毫秒级检索?
很多人会有直觉疑问:对象存储(S3)的网络延迟通常在 50~100ms 级别,如何能支撑起搜索引擎的实时检索?Quickwit 依靠三项底层关键技术化解了这一矛盾。
1. 不可变切片(Immutable Splits)与 Tantivy 引擎
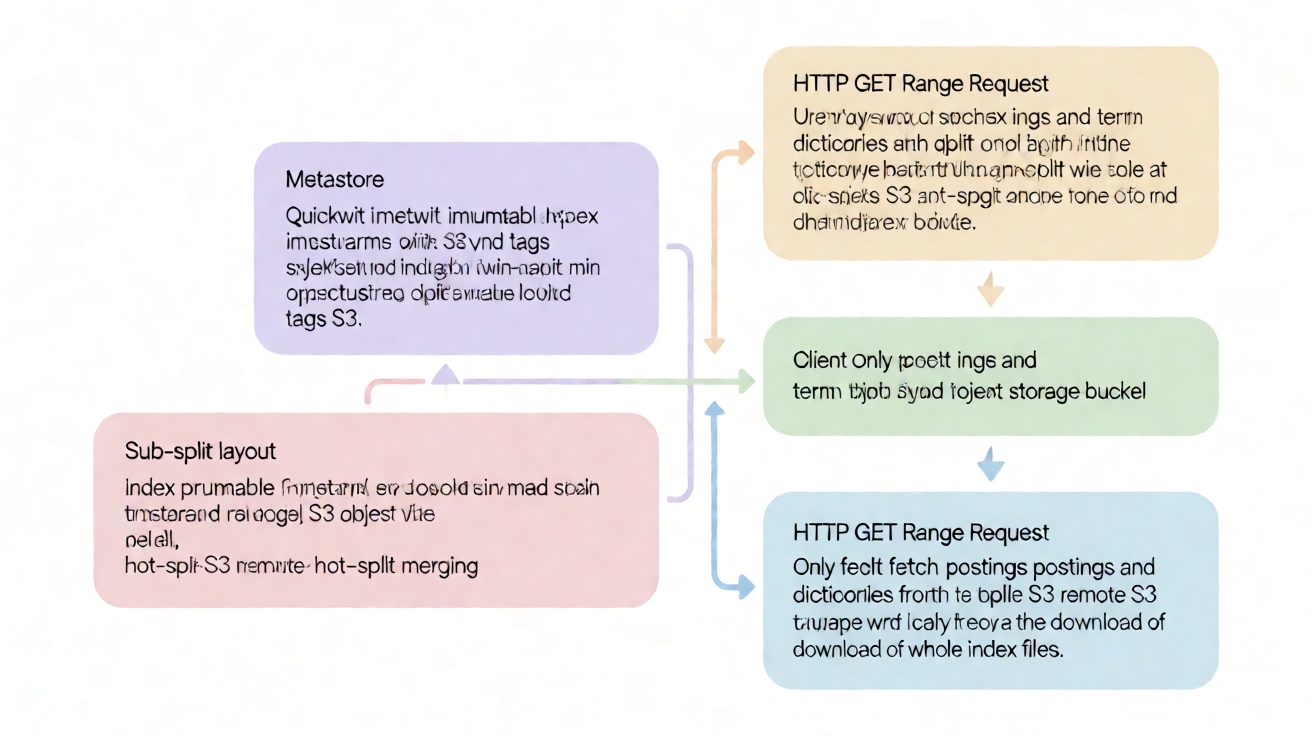
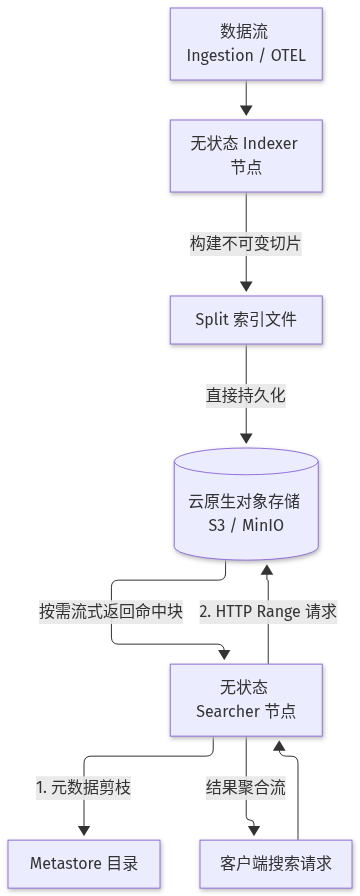
Quickwit 的核心索引能力基于 Rust 生态顶级倒排索引库 Tantivy 构建。在数据写入端,Quickwit 采用微批处理(Micro-batching)机制: - 数据流首先进入无状态的 Indexer 节点; - 累积到一定阈值(如几十万条记录或特定时间间隔)后,直接在内存中编译构建成一个自包含、自描述的“切片”(Split); - 切片构建完成后立即上传至 S3,一旦上传便永久不可变。
不可变切片彻底消除了写锁竞争、行级更新和动态段合并(Merge)带来的 I/O 抖动,使得副本冗余可以直接借力 S3 本身高达 99.999999999%(11 个 9)的持久性,无需在计算节点维护昂贵的多副本。
2. 子文件布局(Sub-file Layout)与 HTTP Range Request
传统方案若想读取远程文件,通常需要将整个文件下载到本地临时盘。而在 PB 级数据下,下载数 GB 的索引文件将彻底扼杀查询性能。
Quickwit 的关键突破在于精心设计的 Split 内部物理排布: - 切片尾部存储了固定格式的 Footer 元数据目录,记录了字段词典(Term Dictionary)、文档倒排链(Postings)、列式存储(Fast Fields)在文件中的精确字节偏移(Byte Offset); - 当查询到达无状态 Searcher 节点时,节点首先发送极小的 HTTP GET Range 请求读取尾部数十字节元数据; - 随后,根据查询词的哈希位置,仅针对目标词条所在的几 KB 字节区间发起精确 Range 请求。
通过几次毫秒级的并发 Range 请求,Searcher 即可直接在 S3 上完成布尔过滤与文档定位,整个查询过程完全无需下载完整索引。
# 示例:HTTP Range Request 按需抽取远程索引切片原理
footer_bytes = storage.fetch_range(storage.total_size - 32, 32)
term_dict_off, postings_off = struct.unpack("<QQ", footer_bytes[:16])
# 仅拉取命中词条的倒排文档列表,完全无需下载整份索引文件
postings_bytes = storage.fetch_range(postings_off, 16)
doc_ids = struct.unpack("<4I", postings_bytes)
3. Metastore 索引剪枝(Pruning)
在面对跨度数月、包含上万个 Split 的海量集群时,盲目向每个切片发请求仍会产生高昂成本。Quickwit 在元数据层(Metastore)维护了每个 Split 的时间戳范围(Min/Max Timestamp)、分区键及标签。
在查询执行计划生成阶段,Quickwit 首先通过时间窗口和标签在内存中实施剪枝,通常能直接过滤掉 95% 以上无关切片,将实际并发请求数压缩至最小范围。
三、弹性与成本:彻底解放运维心智
得益于存算分离架构,Quickwit 带来了颠覆性的运维体验:
- 秒级水平自动扩缩容:由于 Searcher 节点完全无状态(不挂载持久卷、不存储持久数据),在双十一大促或流量激增时,团队可以通过 Kubernetes HPA 在几秒钟内将查询节点从 5 个扩容至 100 个;流量回落后迅速释放,实现真正的“按需付费”。
- 硬件成本直降 80%+:冷热数据无需分别配置不同规格的高昂存储节点,通用日志直接落盘在 S3 标准存储或甚至降级到冷归档存储,综合存储账单相较传统 ES 集群可节省高达 70%~90%。
- 原生兼容 Elasticsearch 查询协议:Quickwit 提供了对 Elasticsearch 查询 API 的兼容层,现有的 Grafana 仪表盘和 Kibana 可以几乎无缝对接。
四、选型权衡:什么时候应该选择 Quickwit?
尽管 Quickwit 在日志和追踪场景优势巨大,但技术决策始终伴随权衡:
| 评估维度 | Elasticsearch / OpenSearch | Quickwit |
|---|---|---|
| 优势场景 | 高频随机文档单条实时更新、电商复杂相关性搜索 | 写入吞吐巨大、追加写入、PB 级日志/链路追踪分析 |
| 存储介质 | 本地高性能 SSD 强依赖 | 云原生对象存储 (S3 / MinIO / OSS) |
| 查询延迟 | 极低 (毫秒级,强内存依赖) | 极低至中等 (几百毫秒,无状态冷启) |
| 资源与维护成本 | 极高 (JVM 调优、内存占用、分片迁移复杂) | 极低 (无状态容器、极低内存、零 GC) |
五、结语
Quickwit 证明了:在云原生时代,搜索引擎的设计不必拘泥于传统的本地文件系统模式。通过充分发挥 Rust 的内存安全与零成本抽象优势,结合云端对象存储的高吞吐与低廉成本,构建真正的存算解耦架构,正是下一代海量大数据基建演进的大势所趋。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。