彻底告别格式地狱:Spring Boot 3 整合 Apache Tika 实现 PDF、Word 与异构文档的流式解析与元数据抽取
在企业数字化转型与当前大火的 大语言模型知识库(RAG,检索增强生成) 建设中,文档内容提取是几乎所有数据流水线的第一道关卡。
然而,凡是做过文档处理的 Java 开发者,几乎都经历过以下痛点构成的「格式地狱」:
- 依赖地狱与版本冲突:为了读 Word/Excel,引入 Apache POI 以及一堆 xmlbeans、curvesapi;为了读 PDF,引入 PDFBox 或 iText;为了读 EPUB、HTML、Markdown,又引入一堆零散的三方解析库,稍有不慎就触发 classpath 类冲突;
- 文件后缀造假与安全漏洞:用户上传的文件往往被篡改了扩展名(如将
.exe改为.pdf诱骗上传,或将.zip改为.docx),仅靠后缀名判断解析器极易崩溃或引发安全漏洞; - 内存泄漏与 OOM 灾难:常规解析方式常常将文档 DOM 树全部加载到 JVM 堆内存中,一旦遇到 100MB+ 的大文件或数百页报告,极易引发频繁 Full GC 乃至整个微服务内存溢出瘫痪。
有没有一种方案,只需一套极其简明的标准化 API,就能自动识别文件真实类型,流式解析包括 PDF、DOCX、XLSX、PPTX、HTML、RTF 在内的上千种文档,并同时无损抽取其深层元数据?
答案就是 Apache 顶级开源项目 —— Apache Tika。本文将基于最新的 Spring Boot 3.x 与 Apache Tika 2.x,带你从底层流水线机制到生产级代码,完整构建一套低内存、高并发、易扩展的通用文档流式解析引擎。
一、Apache Tika 核心机制与 MIME 自动探测流水线
Apache Tika 本质上是一个「文档内容分析与提取的统一门户(Toolkit)」。它并没有重新造轮子实现每一种格式的解码器,而是将业界最顶尖的专用解析库(如 PDFBox、POI、Rome、Metadata Extractor 等)统一封装在标准化抽象门面之后。
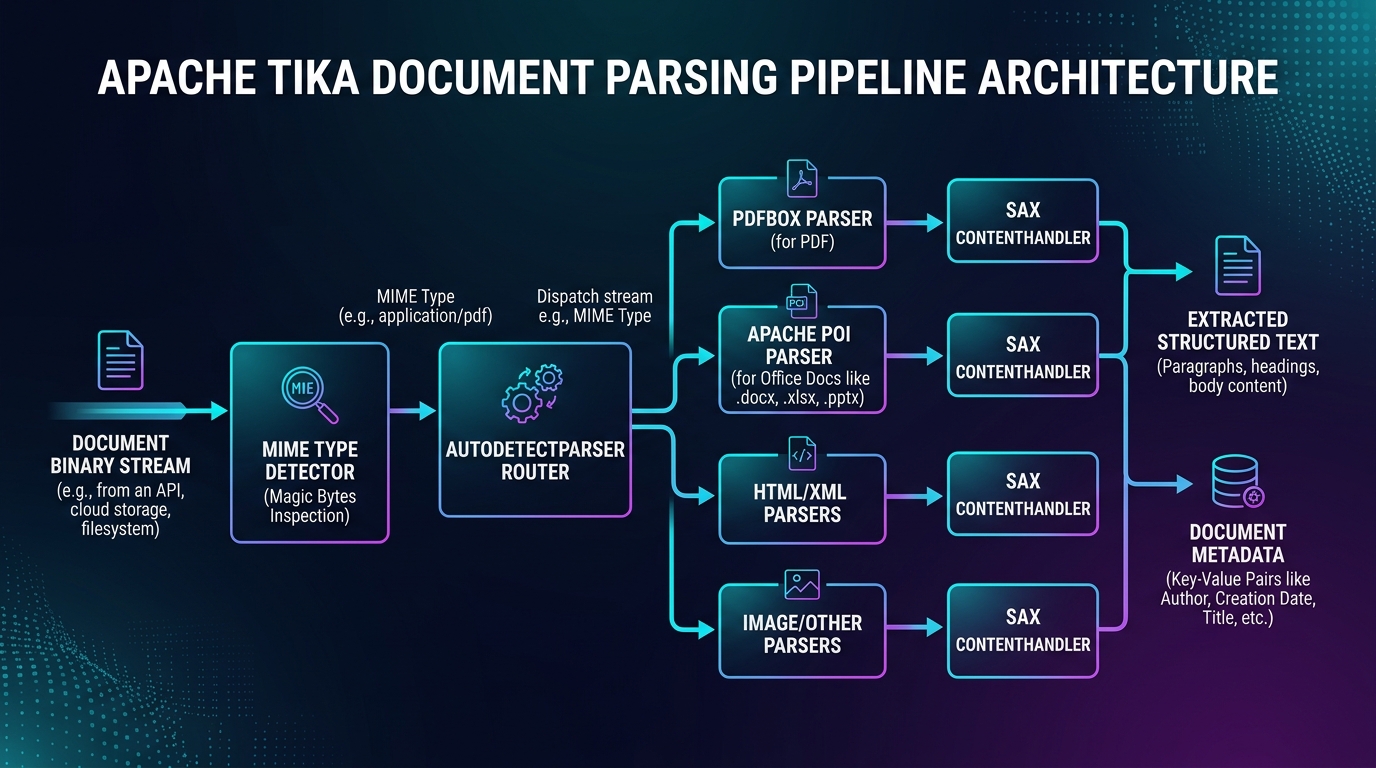
Tika 内部的处理流水线高度清晰,核心由三大支柱构成:
1. MIME 探测器(Detector):采用魔数嗅探(Magic Bytes)。不看文件扩展名,直接读取输入流前数十个字节的特征码,识别真实的媒体类型(如 %PDF- 对应 application/pdf,PK\x03\x04 对应 Zip 类容器);
2. 自动探测解析器(AutoDetectParser):充当总控路由器角色。根据 Detector 识别出的 MIME Type,在已注册的解析器注册表中自动匹配最适合的专业 Parser(如 PDFParser、OfficeParser);
3. SAX 内容处理器(ContentHandler):采用类似 XML SAX 的事件流驱动模型,逐行、逐段吐出提取到的文本或 XHTML 结构,从根源上摆脱了将整个大文件对象树载入内存的传统弊端。
二、Spring Boot 3 工程实战引入
在 Tika 2.x 时代,官方对依赖进行了大幅度的模块化拆分。我们推荐使用 tika-parsers-standard-package,它打包了主流的文本与 Office/PDF 解析组件:
1. Maven 依赖配置
<properties>
    <java.version>17</java.version>
    <tika.version>2.9.2</tika.version>
</properties>

<dependencies>
    <!-- Spring Boot 3 Web Starter -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-web</artifactId>
    </dependency>

    <!-- Apache Tika Core -->
    <dependency>
        <groupId>org.apache.tika</groupId>
        <artifactId>tika-core</artifactId>
        <version>${tika.version}</version>
    </dependency>

    <!-- Apache Tika Standard Parsers Bundle -->
    <dependency>
        <groupId>org.apache.tika</groupId>
        <artifactId>tika-parsers-standard-package</artifactId>
        <version>${tika.version}</version>
    </dependency>
</dependencies>
2. 注入全局线程安全 Bean
Tika 门面对象与 AutoDetectParser 内部维护了全局 MIME 字典与解析器映射表,是开销较大的重型对象,但它们是完全线程安全(Thread-Safe)的。在 Spring 中推荐配置为全局单例(Singleton):
package com.demo.tika.config;

import org.apache.tika.Tika;
import org.apache.tika.parser.AutoDetectParser;
import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;

@Configuration
public class TikaConfig {

    @Bean
    public Tika tika() {
        // 提供简易易用的快捷门面
        return new Tika();
    }

    @Bean
    public AutoDetectParser autoDetectParser() {
        // 提供高度可控的底层流式总控解析器
        return new AutoDetectParser();
    }
}
三、通用流式解析与元数据抽取实战
很多刚接触 Tika 的开发者往往使用 tika.parseToString(inputStream),看似只有一行代码,但默认情况下该方法内部限制了最大提取长度(100,000 字符),而且返回整个字符串仍然会在内存中生成大对象。
在生产环境中,我们要兼顾 全文字符提取、防止 OOM 与 抽取原始元数据。下面是封装好的工业级通用解析组件:
1. 结果承载 DTO
package com.demo.tika.dto;

import lombok.Builder;
import lombok.Data;

import java.util.Map;

@Data
@Builder
public class DocumentParseResult {
    /** 探测出的真实 MIME 类型 */
    private String mimeType;
    /** 纯文本正文内容 */
    private String content;
    /** 解析出的键值对元数据 (作者、创建时间、标题、页数等) */
    private Map<String, String> metadata;
    /** 字符总数 */
    private int characterCount;
}
2. 流式解析核心服务实现
package com.demo.tika.service;

import com.demo.tika.dto.DocumentParseResult;
import lombok.RequiredArgsConstructor;
import lombok.extern.slf4j.Slf4j;
import org.apache.tika.io.TikaInputStream;
import org.apache.tika.metadata.Metadata;
import org.apache.tika.parser.AutoDetectParser;
import org.apache.tika.parser.ParseContext;
import org.apache.tika.sax.BodyContentHandler;
import org.springframework.stereotype.Service;

import java.io.InputStream;
import java.util.HashMap;
import java.util.Map;

@Slf4j
@Service
@RequiredArgsConstructor
public class DocumentParserService {

    private final AutoDetectParser autoDetectParser;

    /**
     * 流式解析输入流,提取纯文本与全量元数据
     *
     * @param inputStream 输入文件流
     * @param originalFilename 原始文件名(用于辅助兜底检测,可选)
     */
    public DocumentParseResult parseStream(InputStream inputStream, String originalFilename) {
        // 1. 初始化元数据容器
        Metadata metadata = new Metadata();
        if (originalFilename != null) {
            metadata.set(Metadata.RESOURCE_NAME_KEY, originalFilename);
        }

        // 2. 使用 BodyContentHandler 承接 SAX 事件
        // 关键点:传入 -1 表示不对字符最大长度设限;若需严格限流,可传入如 5 * 1024 * 1024 限制字符数
        BodyContentHandler handler = new BodyContentHandler(-1);
        ParseContext context = new ParseContext();
        context.set(org.apache.tika.parser.Parser.class, autoDetectParser);

        // 3. 包装为 TikaInputStream(可自动利用临时文件优化超大流读取)
        try (TikaInputStream tikaStream = TikaInputStream.get(inputStream)) {
            // 执行自动探测解析
            autoDetectParser.parse(tikaStream, handler, metadata, context);

            // 4. 提取元数据键值对
            Map<String, String> metadataMap = new HashMap<>();
            for (String name : metadata.names()) {
                metadataMap.put(name, metadata.get(name));
            }

            String content = handler.toString();
            String detectedMime = metadata.get(Metadata.CONTENT_TYPE);

            log.info("文档解析成功,探测类型: [{}], 字符数: {}, 元数据项数: {}",
                     detectedMime, content.length(), metadataMap.size());

            return DocumentParseResult.builder()
                    .mimeType(detectedMime)
                    .content(content)
                    .metadata(metadataMap)
                    .characterCount(content.length())
                    .build();

        } catch (Exception e) {
            log.error("文档解析发生异常: {}", e.getMessage(), e);
            throw new RuntimeException("文档解析失败: " + e.getMessage(), e);
        }
    }
}
四、HTTP 上传解析接口与测试
编写 Controller,支持直接通过 multipart/form-data 上传文件并立即返回结构化数据:
package com.demo.tika.controller;

import com.demo.tika.dto.DocumentParseResult;
import com.demo.tika.service.DocumentParserService;
import lombok.RequiredArgsConstructor;
import org.springframework.http.ResponseEntity;
import org.springframework.web.bind.annotation.*;
import org.springframework.web.multipart.MultipartFile;

import java.io.IOException;

@RestController
@RequestMapping("/api/documents")
@RequiredArgsConstructor
public class DocumentParserController {

    private final DocumentParserService documentParserService;

    @PostMapping("/parse")
    public ResponseEntity<DocumentParseResult> uploadAndParse(
            @RequestParam("file") MultipartFile file) throws IOException {

        if (file.isEmpty()) {
            return ResponseEntity.badRequest().build();
        }

        DocumentParseResult result = documentParserService.parseStream(
                file.getInputStream(),
                file.getOriginalFilename()
        );

        return ResponseEntity.ok(result);
    }
}
解析效果示例(PDF 报告)
上传一份标准的立项申请 PDF,接口输出的 JSON 结果如下:
{
  "mimeType": "application/pdf",
  "content": "项目立项可行性评估报告\n\n一、项目背景与痛点概述...\n二、架构选型与系统指标...",
  "metadata": {
    "dc:creator": "研发中心架构组",
    "pdf:PDFVersion": "1.7",
    "xmp:CreatorTool": "Microsoft Word 2021",
    "meta:creation-date": "2026-03-15T09:20:00Z",
    "xmpTPg:NPages": "18",
    "Content-Type": "application/pdf"
  },
  "characterCount": 8450
}
无论是 Word 中的文档作者、修改历史,还是 PDF 中的制作工具、页码(xmpTPg:NPages),都以完全统一的 Key-Value 格式完整提取!
五、赋能 AI:构建 RAG 向量知识库与全文检索流水线
在 AI 知识库架构中,Tika 扮演着不可替代的数据中枢角色。一个标准的端到端 RAG 入库流水线如下:
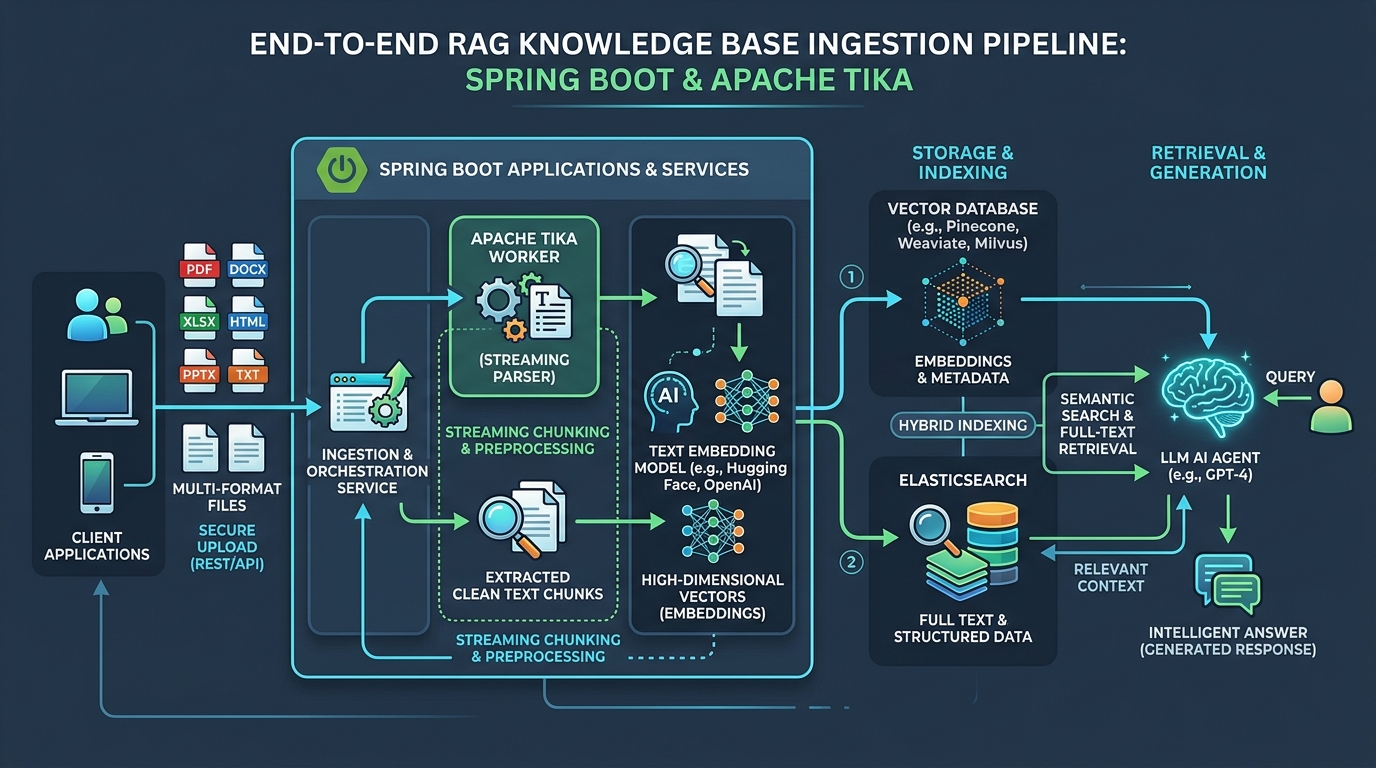
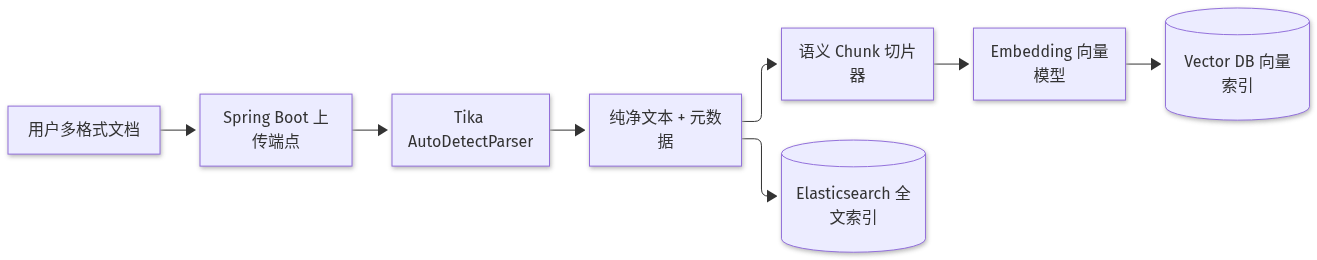
通过将 Tika 解析出的正文送入切片器(如按 500 Token 配合滑动窗口重叠切片),并将 Tika 抽取出的元数据(如 dc:creator、creation-date、NPages)作为向量 Payload 附加字段,在大模型召回时就能实现「向量语义搜索 + 元数据精准过滤」的强大混合检索能力!
六、生产环境避坑与高可靠实践
在企业大规模并发场景下使用 Tika,以下三大要点必须严加防范:
1. 防范 Zip Bomb(压缩炸弹)攻击:DOCX、XLSX、PPTX 本质上是基于 Zip 格式封装的 XML。恶意攻击者可能制作数 KB 但解压后达数十 GB 的恶意文档,瞬间撑爆服务器。Tika 内部集成了防炸弹机制,可通过配置 ZipBombThreshold 限制最大膨胀比例。
2. 超大文件使用 TikaInputStream.get(File/Path):如果文件已经落地在磁盘上,切忌使用普通 FileInputStream,务必直接传入 File 对象创建 TikaInputStream。Tika 会使用 Memory-Mapped File(零拷贝内存映射)或分段缓存技术,极大降低堆内存压力。
3. OCR 扩展解耦:若需处理扫描件图片或纯图片 PDF,Tika 支持通过 TesseractOCRParser 调用本地 Tesseract 引擎。但在微服务中,OCR 属于重度 CPU 密集型任务,强烈建议将纯文本解析与 OCR 识别拆分为独立的异构计算服务,避免影响主业务接口响应。
七、总结
通过整合 Spring Boot 3 与 Apache Tika 2.x,我们用几十行优雅的高阶代码,一揽子解决了多源异构文档解析中的格式兼容、类型嗅探、元数据获取与内存安全难题。
无论是搭建企业内部文档中心、打造全文搜索引擎,还是为大模型构建高吞吐的 RAG 知识库入库中枢,Apache Tika 都是 Java 生态中经久不衰的利器。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: