

告别 getBoundingClientRect 重排地狱:Cheng Lou 开源 Pretext,DOM-Free 文本测量与排版引擎拆解
前端做「自适应气泡」「虚拟列表」「杂志栏流排版」时,最刺手的往往不是组件框架,而是多行文本到底有多高。传统做法几乎都会落到 getBoundingClientRect / offsetHeight:先把节点塞进 DOM,再读尺寸。问题是——读布局会强制同步重排(layout reflow)。几百段评论各自量一次,帧预算就被读/写交错吃光。
前 React 核心成员、现 Midjourney 工程师 Cheng Lou 开源的 Pretext(@chenglou/pretext,MIT)把这件事拆成两阶段:prepare 一次量宽,layout 纯算术反复换行。官方演示站在 chenglou.me/pretext。本文按官方 README、源码注释与社区讨论深度改写——源微信页常遇验证码时,以 GitHub 文档为准,不臆造 API。
一、为什么「量一下文字高度」会拖垮整页?
浏览器布局是全局问题:你读一个节点的高度,引擎往往要先算完当前文档树的几何。虚拟列表若对每条消息都 getBoundingClientRect,就会出现源码注释里描述的典型病症——读/写交错,500 段文本可轻松吃掉 30ms+ 单帧。
社区(Hacker News)把 Pretext 的价值说得很直白:难的不是 canvas.measureText,而是完整复刻浏览器换行规则(连字符、emoji、CJK、尾随空白悬挂等),再用缓存宽度做反复排版。若只量一次、永不再流,收益有限;若窗口缩放、列宽变化、遮挡裁剪要反复重排,热路径才会拉开数量级差距。
| 方案 | 触发重排 | 缩放/多宽反复计算 | 多语言/复杂脚本 | 典型痛点 |
|---|---|---|---|---|
DOM 实测 getBoundingClientRect |
每次必触发 | 昂贵 | 浏览器原生最准 | 虚拟列表卡顿、布局抖动 |
| 粗估字数 × 行高 | 无 | 便宜但不准 | 差 | 中英混排、emoji 全翻车 |
Pretext prepare + layout |
准备阶段用 Canvas,热路径零 DOM | 极便宜 | Intl.Segmenter + 自研换行 |
需对齐 CSS font / line-height |
📌 洞见:Pretext 不是「完全不碰浏览器字体引擎」,而是把字体真相留在 Canvas 测量里,把换行决策搬到用户态纯算术——既保真,又避开整页 reflow。
二、双阶段架构:prepare 一次,layout 无数次
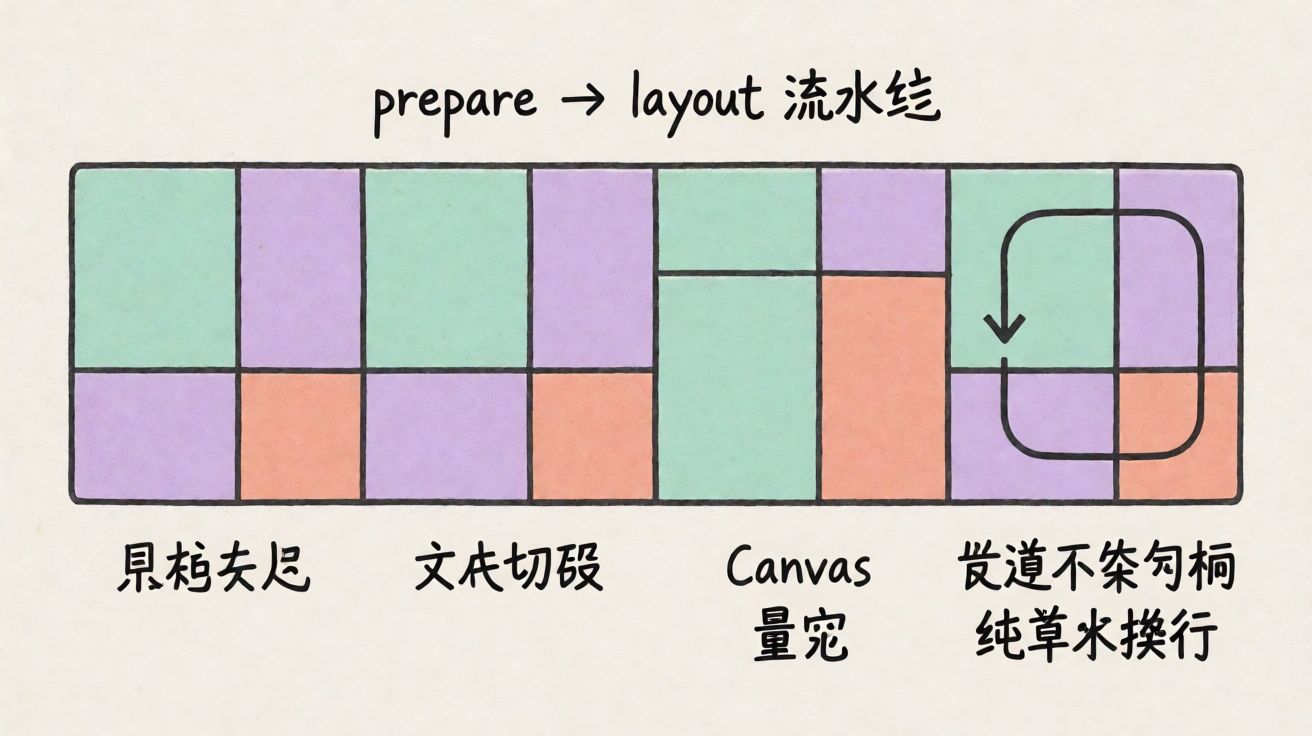
核心心智模型只有两步:
import { prepare, layout } from '@chenglou/pretext'

// 一次性:分词、胶粘规则、Canvas 量宽,返回不透明句柄
const prepared = prepare('AGI 春天到了. بدأت الرحلة 🚀', '16px Inter')

// 热路径:给定最大宽度与行高,纯算术算高度与行数——无 DOM、无 Canvas、无字符串分配
const { height, lineCount } = layout(prepared, 320, 20)
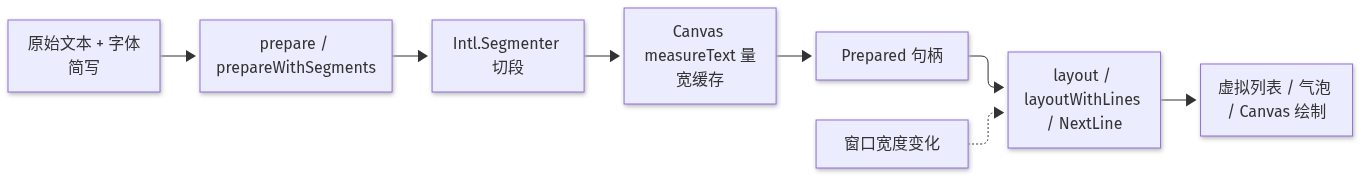
1. prepare():预处理与缓存
官方契约:
- 规范化空白、用
Intl.Segmenter切段; - 用 Canvas
measureText量每段宽度并缓存; - 必要时对 emoji 做一次按字体缓存的 DOM 校准读;
- 返回与宽度无关的
PreparedText,同一句柄可在任意maxWidth上layout。
基准量级(官方文档快照):约 500 段文本的 prepare 批处理约 19ms;之后单次 layout 可到亚毫秒乃至微秒级(源码注释写到约 0.0002ms/块 量级,视环境而定)。
致命误用:在 resize 回调里反复 prepare——等于每次都付 Canvas 成本,把优势打回原形。正确姿势是:文本/字体变了才 prepare;宽变了只 layout。
2. layout():纯算术热路径
layout(prepared, maxWidth, lineHeight) => { height, lineCount }
lineHeight必须与 CSSline-height对齐;font字符串必须与 Canvas/CSS font简写一致(字重、字号、族名);- 空字符串返回
{ lineCount: 0, height: 0 };若要模拟浏览器空块仍占一行,自行Math.max(1, lineCount) * lineHeight。
可选:prepare(..., { whiteSpace: 'pre-wrap' }) 保留空格/制表/硬换行;{ wordBreak: 'keep-all' }、{ letterSpacing: n }(按 CSS px)对齐常见排版开关。
三、进阶 API:自己拿行、绕图流排、富文本碎片
当高度不够,还要「逐行绘制 / 逐行改宽 / shrink-wrap」时,切换到带段信息的 API:
import {
  prepareWithSegments,
  layoutWithLines,
  measureLineStats,
  walkLineRanges,
  layoutNextLineRange,
  materializeLineRange,
} from '@chenglou/pretext'

const prepared = prepareWithSegments('AGI 春天到了. بدأت الرحلة 🚀', '18px "Helvetica Neue"')
const { lines } = layoutWithLines(prepared, 320, 26)
for (let i = 0; i < lines.length; i++) {
  ctx.fillText(lines[i].text, 0, i * 26)
}
变宽流排(绕浮动图)
let cursor = { segmentIndex: 0, graphemeIndex: 0 }
let y = 0
while (true) {
  const width = y < image.bottom ? columnWidth - image.width : columnWidth
  const range = layoutNextLineRange(prepared, cursor, width)
  if (range === null) break
  const line = materializeLineRange(prepared, range)
  ctx.fillText(line.text, 0, y)
  cursor = range.end
  y += 26
}
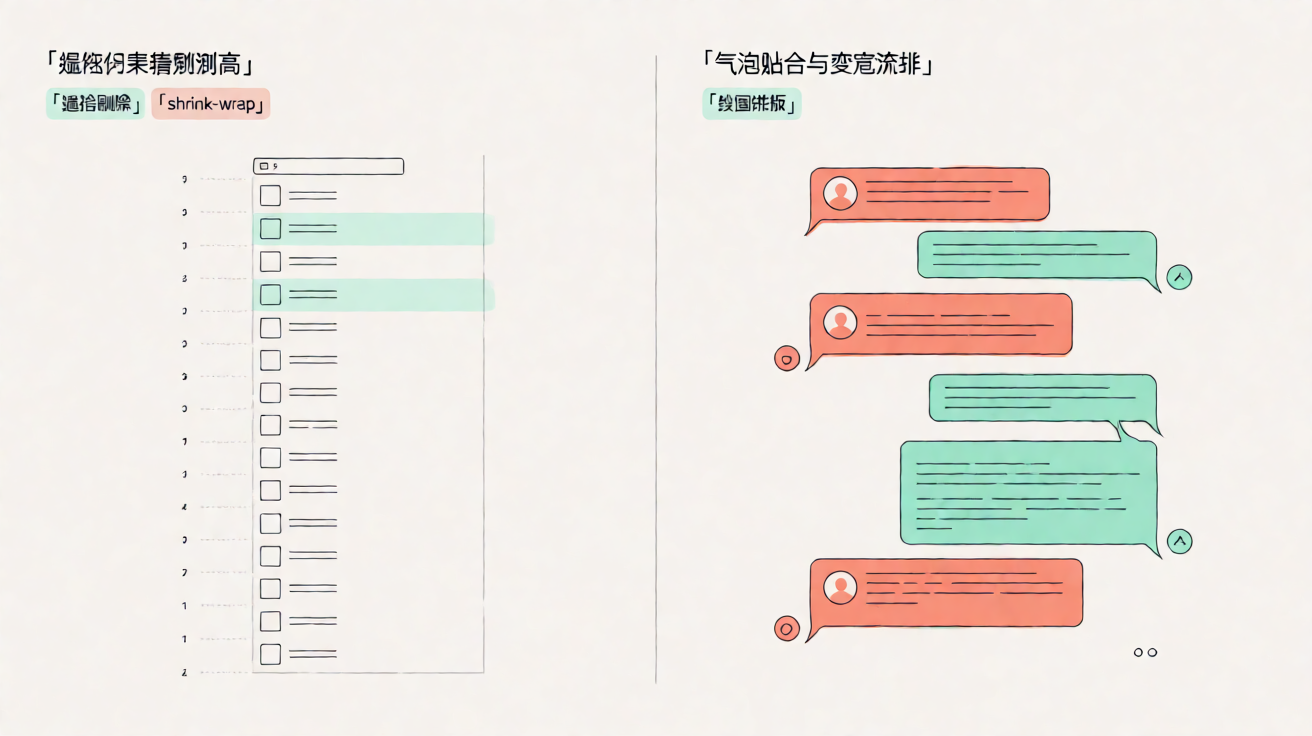
这正是杂志栏、聊天气泡「贴合文字的最紧宽度」、以及遮挡/虚拟化需要的能力:measureLineStats / walkLineRanges 可在不分配行字符串的前提下探宽探高。
富文本行内:@chenglou/pretext/rich-inline
Mention 芯片、代码 span、不同字重混排时:
import { prepareRichInline, walkRichInlineLineRanges, materializeRichInlineLineRange } from '@chenglou/pretext/rich-inline'

const prepared = prepareRichInline([
  { text: 'Ship ', font: '500 17px Inter' },
  { text: '@maya', font: '700 12px Inter', break: 'never', extraWidth: 22 },
  { text: "'s rich-note", font: '500 17px Inter' },
])

walkRichInlineLineRanges(prepared, 320, range => {
  const line = materializeRichInlineLineRange(prepared, range)
  // fragments 保留源 item 索引、gapBefore、游标
})
注意:rich-inline 不是完整 CSS inline formatting 引擎,目前按 flat item 列表、white-space: normal 工作。
四、解锁的 UI 场景(官方用例映射)
| 场景 | Pretext 怎么用 | 传统坑 |
|---|---|---|
| 虚拟列表 / 遮挡剔除 | prepare 后按列宽 layout 得精确高度 |
猜行高 + 缓存失效 = 滚动跳动 |
| 用户态 masonry / 类 flex | 反复 layout 试宽 |
改一点 padding 就整页 reflow |
| IM 气泡 shrink-wrap | measureLineStats / walkLineRanges 找最紧宽 |
大量隐藏 DOM 探针 |
| AI 生成 UI 防溢出 | 无浏览器也可在有 Canvas 的环境验标签是否换行 | 截图回归成本高 |
| 新文本加载后锚定滚动 | 预知高度变化,抵消 layout shift | 先插再量,闪一下 |
连字符:在 prepare 前自行插入软连字符(soft hyphen);Pretext 不自动插。混合语言/UGC 宜保守、按 locale 插入。
五、本机 API 形状与运行时边界存证
在流水线机器上安装 @chenglou/pretext 后执行结构校验(无浏览器 Canvas 时 prepare 会失败——这是真实边界,不是废话):
exports: clearCache, layout, layoutNextLine, layoutNextLineRange, layoutWithLines,
         materializeLineRange, measureLineStats, measureNaturalWidth, prepare,
         prepareWithSegments, setLocale, walkLineRanges
[expected in headless Node] prepare/layout requires Canvas 2D + Intl.Segmenter:
Text measurement requires OffscreenCanvas or a DOM canvas context.
结论写进排坑清单:
1. 运行时硬依赖:Intl.Segmenter、Canvas 2D 文本测量、Unicode 属性转义 \p{...};缺特特性直接无法加载或抛错。
2. SSR / 纯 Node:默认拿不到 DOM Canvas;要么上 OffscreenCanvas polyfill/环境,要么把 prepare 挪到浏览器/Worker。
3. 字体陷阱:macOS 上 system-ui / -apple-system 不安全(Canvas 与 DOM 解析可能不一致)——用具名字体(Inter、Helvetica、Arial…)。
4. CSS 对齐:font-optical-sizing、font-feature-settings、非 canvas 字符串表达的可变字体轴、非默认 font-kerning/word-spacing 都可能导致「量的和画的不一致」。
5. 双向文本:Pretext 不算完整 bidi level;英阿混排若按行拆到 Canvas fillText,标点/数字在断行处可能顺序异常——官方建议整段交给 DOM 并设方向。
6. 最小字号:Chrome/Firefox 用户可设最小字体;页面实际绘制可能被抬高,而 Pretext 按你传入字号测量。
辅助 API:clearCache() 释放字体/文本变体缓存;setLocale(locale?) 影响后续 prepare(会清缓存,不改写已有句柄)。
六、安装、演示与工程接入
npm install @chenglou/pretext
本地演示(官方):
git clone https://github.com/chenglou/pretext.git
cd pretext && bun install && bun start
# 浏览器打开 /demos/index ;Windows 用 bun run start:windows
接入清单(建议贴进 Code Review):
1. 文本首次出现 → prepare / prepareWithSegments;
2. resize / 列宽动画 → 只调 layout*;
3. font、letterSpacing、lineHeight 与真实 CSS 同源生成;
4. 根 lang 变化后重新 prepare;
5. 字号尽量整像素(Firefox Canvas 会圆整字号)。
架构关系可概括为:
七、社区争论与边界预期(别当银弹)
HN 上也有「一次性量表场景未必更快」「拉丁表格行高另有更快专用实现」等声音。理性预期:
- 强项:多宽反复重排、用户态复杂布局、多脚本换行保真、与 AI 迭代测量对齐浏览器真相;
- 弱项:不是完整字体渲染引擎;CSS 覆盖面有限;准备阶段仍依赖 Canvas;SSR 需额外设计;
- 历史渊源:Sebastian Markbage 早年 text-layout 的种子——Canvas 塑形、流式换行——在 Pretext 里被继续推到工程可用。
⚠️ 安全与合规提示:本文只讨论合法的开源文本排版库与性能工程,不涉及破解、攻击复现或绕过平台风控。
八、小结
Pretext 把「困扰前端二十年」的文本测高问题,收敛成一句工程纪律:贵的测量只做一次,便宜的换行随便做。若你在做聊天、Feed、杂志式栏流、或 AI 生成 UI 的防溢出校验,值得把 @chenglou/pretext 放进工具箱——记得对齐字体字符串,并避开 system-ui 这种「看起来省事、量出来跑偏」的坑。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





