

拒绝看无脑汇编!搞懂这套 AI 辅助逆向实战工作流,分析效率提升 10 倍
在传统的二进制安全分析与逆向工程中,安全研究员和逆向工程师最痛苦的事情莫过于面对 IDA Pro、Ghidra 中几万行密密麻麻的 sub_4012A0 匿名函数、高强度混淆的条件跳转以及未还原的数据结构。过去,还原一个核心算法往往需要手工比对数小时甚至数天。
随着大语言模型(LLM)与智能 Agent 技术的演进,“AI + 逆向工程” 已经从早期的简单代码解释,演进为一套具备代码解析、语义重构、动态插桩验证与脚本自动生成的完整自动化工作流。本文将为你系统拆解这套可复现的 AI 辅助逆向工程实战方法论。
一、 传统逆向痛点与 AI 逆向的工作流演变
传统逆向分析的核心痛点主要体现在:
1. 符号缺失与变量名混淆:函数名全部为 sub_xxxx,局部变量为 v1, v2, a1, a2,难以直观理解业务逻辑。
2. 反汇编/伪代码晦涩:C反编译结果中充斥着复杂的指针位运算、结构体偏移计算。
3. 动态验证成本高:每次编写 Frida Hook 脚本或 GDB 调试脚本,都需要反复搭建测试环境与测试用例。
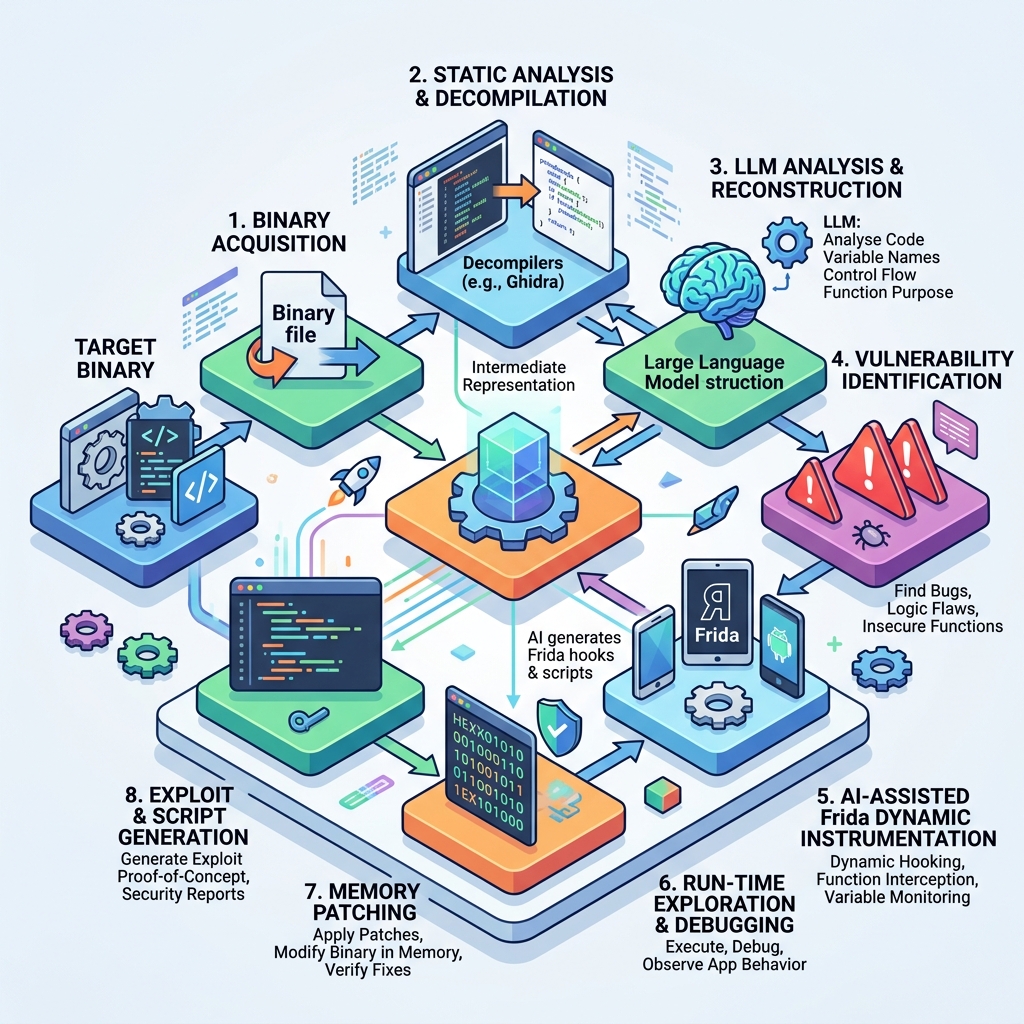
通过构建 AI 辅助逆向工作流,我们可以将复杂的逆向过程解耦为以下 4 个阶段:
二进制反编译 ➔ LLM 函数语义重构 ➔ Frida/GDB 动态验证 ➔ 自动化 Hook 导出
二、 第一步:使用 LLM 自动还原混淆函数语义
在反编译工具(如 Ghidra 或 IDA)导出 C 伪代码后,直接将其送入大模型,结合预定义的提示词模板进行函数语义重写。
1. 结构化提示词 (Prompt Template)
你是一个资深二进制安全与逆向工程专家。
请分析以下伪代码:

1\. 识别该函数的真实业务含义(例如:AES-128 加密、自定义 Base64、CRC32 校验、License 验证等)。

2\. 将无意义变量(v1, v2, a1)重命名为符合语义的变量名。

3\. 标注关键内存偏移与加密常量。

4\. 输出重构后的高质量 C/Python 伪代码。
2. 代码重写对比
经过 LLM 重构后,原本晦涩的混淆控制流被清晰表达:
// 原始反编译伪代码
int __fastcall sub_4015B0(char *a1, int a2) {
    int v3 = 0;
    for (int i = 0; i < a2; ++i) {
        v3 = (v3 ^ a1[i]) * 16777619;
    }
    return v3;
}

// 经过 AI 语义重写后
uint32_t calculate_fnv1a_hash(const char *input_buffer, size_t length) {
    uint32_t hash_val = 2166136261u; // FNV-1a 初始哈希种子
    for (size_t i = 0; i < length; ++i) {
        hash_val ^= (uint8_t)input_buffer[i];
        hash_val *= 16777619u; // FNV 质数乘子
    }
    return hash_val;
}
可以看到,AI 不仅瞬间识别出了这是 FNV-1a 哈希算法,还补充了未初始化的种子常量,大幅缩短了分析时间!
三、 第二步:自动化 Frida Hook 脚本生成
静态分析完成后,我们需要对目标函数进行动态验证。传统方式下编写 Frida Hook 脚本需要手写 Interceptor.attach 并处理 Native 类型转换。通过 AI 助手,我们可以直接生成确定性的 Frida 脚本。
自动生成的 Frida 验证脚本
// 由 AI 自动生成的 Frida Hook 脚本:监控算法输入与输出
Interceptor.attach(Module.findExportByName("libnative-lib.so", "calculate_fnv1a_hash"), {
    onEnter: function (args) {
        this.inputStr = Memory.readUtf8String(args[0]);
        console.log("\n[+] 拦截到算法输入参数:", this.inputStr);
    },
    onLeave: function (retval) {
        console.log("[+] 算法计算结果 (HEX):", retval.toInt32().toString(16));
    }
});
四、 第三步:AI 辅助逆向的实战排坑与边界警告
在实际落地 AI 逆向工作流时,需要特别注意以下避坑事项:
| 踩坑场景 | 触发原因 | AI 逆向应对策略 |
|---|---|---|
| 反编译内联函数误判 | 编译器自动将 memcpy 或 memset 内联,导致伪代码异常膨胀 | 在 Prompt 中显式指定 忽略标准库内联展开,引导 AI 归纳高层逻辑 |
| 花指令与控制流平坦化 | 存在 switch-case 大循环混淆控制流 | 先使用 OLLVM 平坦化还原脚本(如 amnesia),再将干净代码交给 AI 分析 |
| 大模型 Hallucination (幻觉) | 针对生僻算法,AI 容易盲目猜测逻辑 | 必须结合 Frida/GDB 的动态运行日志,对 AI 提取的入参和返回值进行交叉双重校验 |
五、 总结与展望
借助 AI 辅助逆向工作流,安全团队与逆向工程师可以将精力从繁琐的汇编指令推演中解放出来,聚焦于更高维度的漏洞挖掘与业务逻辑分析。
AI 并不会取代逆向工程师,但掌握 AI 工作流的逆向工程师将彻底碾压传统的分析方式!
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





