

告别频繁改版与封禁!开源 5.8k+ Star 的 Python 自适应爬虫框架 Scrapling 优雅秒过 Cloudflare
在现代网络数据采集的日常开发中,爬虫工程师往往面临两大“毁灭性痛点”:前端防爬对抗升级(如 Cloudflare Turnstile 验证),以及目标网站频繁改版导致的 CSS/XPath 选择器失效。
传统方案通常需要拼凑 undetected-chromedriver、playwright-stealth 和各种复杂的破解服务,代码臃肿且极其脆弱。而由开发者 Karim Shoair (D4Vinci) 开源的 Scrapling 框架,凭借自适应元素寻址(Adaptive Element Tracking)与原生抗封禁抓取引擎(StealthyFetcher),迅速在 GitHub 上狂揽 5.8k+ Star。
本文将深度拆解 Scrapling 的核心底层架构、自愈选择器算法,并提供开箱即用的实操落地代码。
核心痛点与 Scrapling 的破局解法
传统爬虫三大致命死穴
| 维度 | 传统爬虫框架(Requests/Scrapy/BeautifulSoup) | Scrapling 自适应框架 |
|---|---|---|
| 反爬对抗 | 易被 TLS 指纹/Turnstile 识别,需额外部署防封插件 | 内建 StealthyFetcher,开箱即用过 Cloudflare |
| 选择器维护 | 网站 HTML 类名一改,CSS/XPath 选择器立刻崩溃抛异常 |
自适应指纹追踪,DOM 结构变动后自动重定位目标 |
| 架构一体化 | 静态 HTTP 请求与动态渲染(Playwright/Selenium)解耦割裂 | 统一 API 接口,单代码库无缝切换 Fetcher / Stealthy / Dynamic |
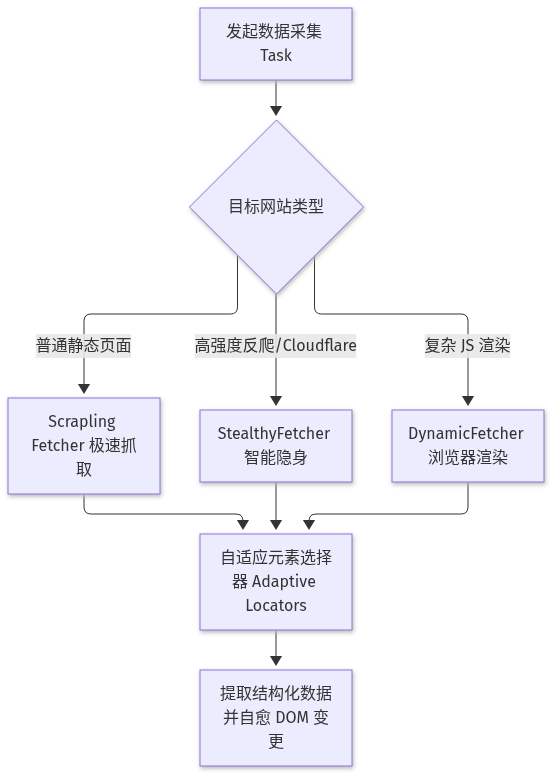
注意:Scrapling 的设计核心并非依赖高昂的大模型 API 进行解析,而是通过数学计算 DOM 节点的综合特征向量(标签层级、文本上下文、属性流)实现物理层面的“代码自愈”。
核心组件与实操落地
1. 基础请求与 StealthyFetcher 隐身抓取
Scrapling 提供了极简的 API 设计。仅需导入对应的 Fetcher,即可瞬间接管 HTTP 请求与浏览器隐身伪装:
from scrapling.fetchers import Fetcher, StealthyFetcher

# 1. 基础极速请求(针对无高强度反爬网站)
page = Fetcher.fetch("https://quotes.toscrape.com/")
print("基础抓取标题:", page.css("title::text").get())

# 2. StealthyFetcher 隐身抓取(秒过 Cloudflare Turnstile 验证)
stealth_page = StealthyFetcher.fetch(
    "https://nowecouldnotblockthis.com/",
    headless=True,
    network_idle=True
)

# 像使用 BeautifulSoup 一样提取数据,但性能大幅提升
items = stealth_page.css(".quote-item")
for item in items:
    text = item.css(".text::text").get()
    author = item.css(".author::text").get()
    print(f"[{author}]: {text}")
2. 核心黑科技:自适应 DOM 元素追踪 (Adaptive Tracking)
当目标网站重构(如 CSS 类名从 .product-title 改为 .prod_title_v2)时,只需开启 auto_save 与 adaptive 参数,Scrapling 即可自动匹配最优候选节点:
from scrapling.fetchers import StealthyFetcher

# 初次抓取:开启 auto_save,自动记录目标元素的特征流与 DOM 签名
page = StealthyFetcher.fetch("https://example.com/products", headless=True)
title_element = page.css(".product-name-v1", auto_save=True)

# 当网站前端改版、原 CSS 选择器失效时:
# 开启 adaptive=True,Scrapling 会基于历史特征向量自动定位新类名下的目标节点
updated_page = StealthyFetcher.fetch("https://example.com/products", headless=True)
adaptive_title = updated_page.css(".product-name-v1", adaptive=True)
print("自适应匹配结果:", adaptive_title.text)
生产环境架构与并发爬虫实战
在企业级批处理场景中,Scrapling 提供了类似 Scrapy 的并发控制与代理轮换支持:
from scrapling import Spider

class EnterpriseScraplingSpider(Spider):
    name = "enterprise_spider"
    start_urls = ["https://news.ycombinator.com/"]

    # 配置代理轮换与并发并发数
    concurrent_requests = 10
    download_delay = 0.5
    proxies = [
        "http://proxy1.example.com:8080",
        "http://proxy2.example.com:8080"
    ]

    def parse(self, response):
        # 使用自适应 Selector 提取新闻标题与链接
        articles = response.css("tr.submission-row")
        for article in articles:
            yield {
                "title": article.css("span.titleline > a::text").get(),
                "url": article.css("span.titleline > a::attr(href)").get(),
                "score": article.css("span.score::text").get(default="0 points")
            }

if __name__ == "__main__":
    spider = EnterpriseScraplingSpider()
    spider.run()
排坑指南与生产环境避坑建议
[!WARNING] 1. 避免无脑开启无头模式:部分最新的 Cloudflare 策略对纯无头浏览器检测极为严苛。在处理极为敏感的接口时,建议配合住宅代理 IP 并在
StealthyFetcher中配置真机 User-Agent。 2. 内存优化建议:并发抓取大量页面时,建议显式调用response.clean()释放 DOM 节点指针,避免 PyQuery 节点驻留内存。 3. 合规性红线:请严格遵守目标网站的robots.txt规则与爬取速率控制,合理配置download_delay。
总结
Scrapling 的出现彻底打破了以往“写爬虫 10 分钟,维护选择器 2 小时”的魔咒。通过把防封隐身与自愈定位收拢为底层基础设施,开发者可以再次专注于数据分析本身。
如果你正受困于 Cloudflare 验证或前端频繁改版,不妨立刻在终端体验一下 pip install scrapling!
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





