

从 Scrapy 到 Crawl4AI:2026 年必看 9 个 GitHub 顶级开源爬虫神器
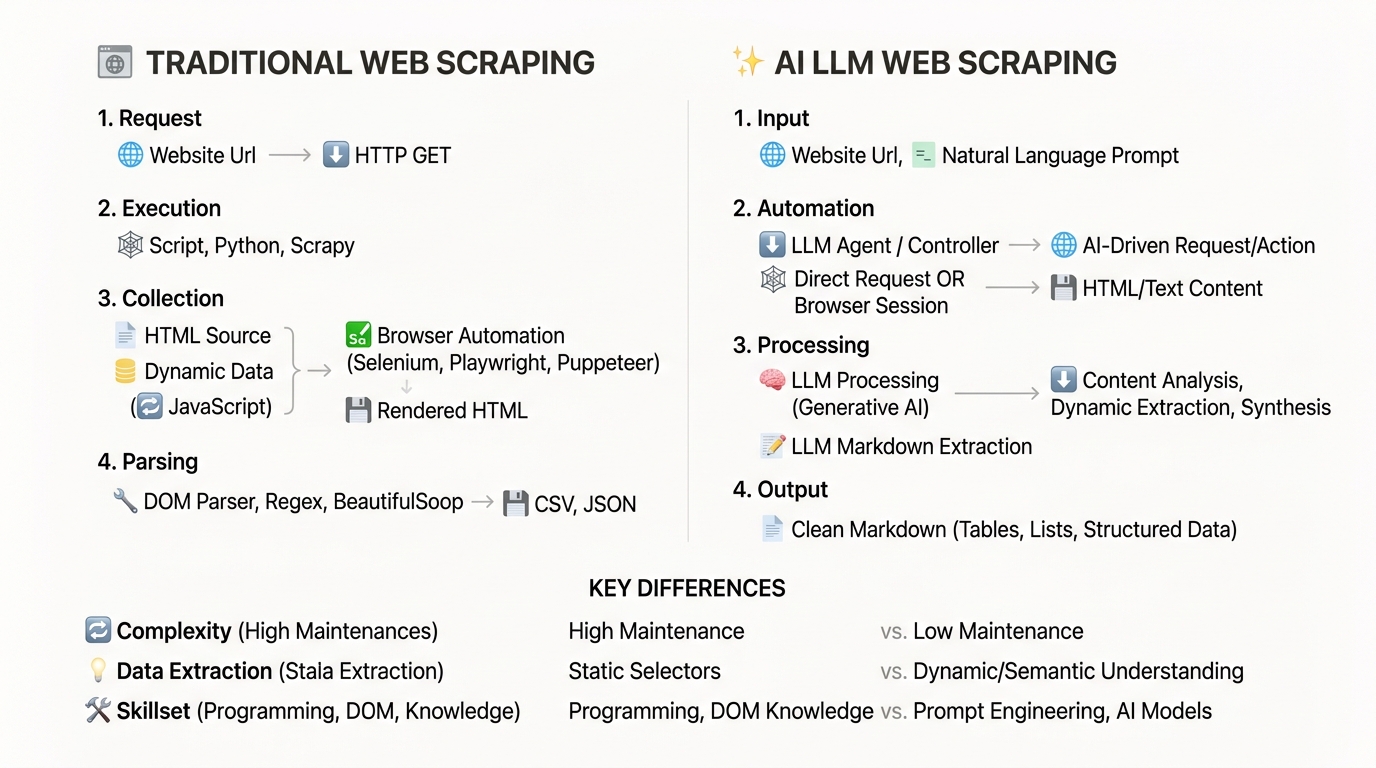
在数据驱动与大模型(LLM)爆发的当下,数据采集(Web Scraping)正迎来前所未有的范式变革。传统的 DOM 选择器解析与 HTTP 模拟已无法彻底满足大模型训练、RAG(检索增强生成)知识库构建以及复杂反爬机制下的高频需求。从工业级高并发框架,到专为 LLM 设计的 AI 原生提取工具,GitHub 上涌现出了一批极其优秀的开源项目。
本文为你深度盘点 2026 年最具代表性、Star 居高不下的 9 个开源爬虫神器,涵盖 Python、Node.js、Go 语言生态及 AI 驱动范式,助你在数据采集选型中游刃有余。
1. 传统与工业级数据采集的基石工具
在处理海量结构化数据、建立高并发管道或进行深度反爬对抗时,传统的工业级框架仍然是企业生产环境的首选。这类工具成熟度极高,生态丰富,支持高度自定义扩展。
1.1 Scrapy (Python) — 工业级分布式采集王者
Scrapy 是 Python 社区成熟度最高的异步爬虫框架。它基于 Twisted / asyncio 异步事件驱动内核,内置强大的 Engine、Spider、Item Pipeline 与 Downloader Middleware 机制。
适用场景:大规模、分布式电商商品数据、新闻资讯及结构化 API 批量抓取。
import scrapy

class ProductSpider(scrapy.Spider):
    name = "products"
    start_urls = ["https://example.com/products"]

    def parse(self, response):
        for item in response.css("div.product-card"):
            yield {
                "name": item.css("h2.title::text").get(),
                "price": item.css("span.price::text").get(),
            }
1.2 Playwright (Multi-language) — 现代浏览器自动化基石
微软开源的 Playwright 彻底改变了无头浏览器自动化的体验。相比传统的 Selenium,它具备速度快、网络拦截能力强、支持多上下文隔离等显著优点,能够轻松应对单页应用(SPA)与复杂 JavaScript 渲染页面。
核心亮点:支持 WebSocket 监听、自动等待元素加载、轻松跳过复杂的客户端渲染障碍。
from playwright.async_api import async_playwright
import asyncio

async def fetch_dynamic_data():
    async with async_playwright() as p:
        browser = await p.chromium.launch(headless=True)
        page = await browser.new_page()
        await page.goto("https://quotes.toscrape.com/js/")
        title = await page.title()
        print(f"页面标题: {title}")
        await browser.close()

asyncio.run(fetch_dynamic_data())
1.3 Crawlee (Node.js / Python) — 一体化反爬与队列调度库
由 Apify 团队打造的 Crawlee 是一款全能型爬虫库。它最强大的特性在于能够自动管理代理池轮换、指纹伪装,并允许开发者在 HTTP 快速请求模式与浏览器渲染模式之间无缝切换。
1.4 Colly (Go) — 极致高并发与性能代表
对于追求极致吞吐量与低内存占用的 Golang 开发者,Colly 是无可争议的首选。它提供了干净优雅的事件回调 API,内存开销极小,单个节点即可轻松支持每秒数万次 HTTP 请求。
2. AI 大模型时代的革命性爬虫架构
随着大语言模型(LLM)与 RAG 架构的普及,爬虫的目标从“提取某个特定 HTML 标签”转变为“将整个网页转化为清洁的 Markdown、结构化 JSON 或语义向量”。以下 3 个 AI 原生项目在过去一年掀起了革命性热潮。
| 项目名称 | 核心驱动 | 输出格式 | 核心优势 |
|---|---|---|---|
| Crawl4AI | Python / Async | Clean Markdown / JSON | 专为 LLM 设计,免费开源,支持流式渲染与代理池 |
| Firecrawl | TypeScript / API | LLM Markdown / Clean HTML | 彻底攻克反爬与页面转 Markdown 痛点 |
| ScrapeGraphAI | LLM (OpenAI/Ollama) | 结构化 JSON | 零 CSS 选择器,用自然语言 Prompt 驱动抓取 |
2.1 Crawl4AI — 专为大模型打造的开源数据引擎
Crawl4AI 是目前增长最迅猛的 AI 爬虫项目之一。它不仅能以极高速度抓取动态网页,更能自动剥离噪音广告,提取出极其精准的 Markdown 格式,天然适配 RAG 向量化索引 Pipeline。
from crawl4ai import AsyncWebCrawler

async def main():
    async with AsyncWebCrawler(verbose=True) as crawler:
        result = await crawler.arun(url="https://news.ycombinator.com")
        print("提取到的 AI 友好 Markdown 内容预览:")
        print(result.markdown[:300])
2.2 Firecrawl — 打造全网知识库转换通道
Firecrawl 致力于把任何复杂的 Web 站点转译为可被 LLM 消化的数据格式。它能够递归爬取整站地图(Sitemap),自动避开 Cloudflare 等反爬关卡,极大地降低了 RAG 数据源预处理的门槛。
2.3 ScrapeGraphAI — 自然语言驱动的零选择器抓取
ScrapeGraphAI 将 LLM 逻辑图与网页抓取流程深度整合。开发者无需编写任何 XPath 或 CSS 选择器,只需输入“提取页面中的商品名称与历史价格”,大模型便会自动理解 DOM 树并返回格式化 JSON。
3. 特殊场景与基础设施:自媒体与代理池
除了通用与 AI 爬虫,针对特定的自媒体生态与底层网络环境,社区同样贡献了重量级的针对性开源项目。
3.1 MediaCrawler — 社交媒体数据采集神器
MediaCrawler 是国内开发者广为青睐的自媒体数据采集项目。它基于 Playwright 模拟真实浏览器行为,支持小红书、抖音、快手、B站、知乎等平台的数据抓取,自带登录态 Cookie 维护与可视化界面。
3.2 Proxy_pool — 爬虫稳定的防封基石
无论使用何种爬虫框架,高频采集都离不开 IP 代理池的支持。Proxy_pool 能够自动抓取全网免费代理,进行定时健康检查与可用性测试,并提供简单易用的 RESTful API 供爬虫程序调用。
# 获取可用代理接口示例
curl http://127.0.0.1:5010/get/
4. 选型决策指南与避坑建议
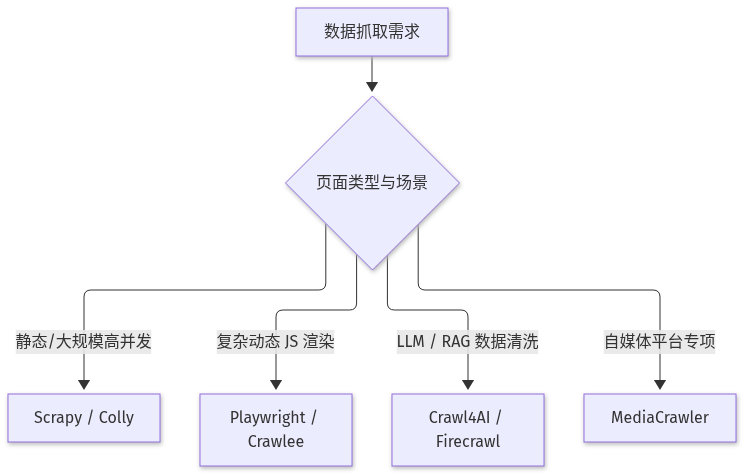
在选择爬虫工具时,建议团队根据业务目标、技术栈与维护成本综合决策:
1. 研发工业级抓取管道:推荐 Scrapy (Python) 或 Colly (Go),具备最高可控性与扩展性。
2. 大模型 RAG 与 AI 应用开发:优先选择 Crawl4AI 或 Firecrawl,省去繁琐的数据清洗工作。
3. 复杂社交媒体与动态逆向:采用 MediaCrawler 或 Playwright,最大程度还原真实用户交互。
[!WARNING] 合规与风控提示: 1. 请务必遵守目标网站的
robots.txt协议及相关法律法规,避免对目标服务器造成 DDoS 式过载压力。 2. 处理 Cookie 与登录凭证时,切勿将敏感 Token 提交至开源代码库中。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





