

别再用切片算余弦!开源 1.6万 Star 的 Cognee 用双擎图谱重构 AI 智能体长效记忆
在过去两年的大语言模型与智能体应用开发中,“挂知识库”几乎等同于“搞一套 RAG”。标准的落地方案大家都烂熟于心:拿一个开源框架把文档切成 512 或 1024 长度的文本块(Chunks),送入 Embedding 模型生成稠密向量,存入向量数据库;用户提问时计算余弦相似度 Top-K,最后拼进 Prompt 喂给大模型。
这套模式应付静态的单次文档问答尚能应付,但一旦将其作为 AI Agent 的长效记忆基础设施,就会频繁暴露致命硬伤:你问“上周张工在架构会上承诺了什么,谁反对了这个方案”,传统 RAG 往往只给你抛回几段语义相似但互不相干的散落文字;多轮追问之后,因缺少实体间的逻辑连接,上下文瞬间断裂。
面对“检索只对一半、记忆毫无连贯性”的行业痛点,在 GitHub 斩获 1.6 万 Star 的开源项目 Cognee(遵循 Apache-2.0 协议)提供了一种根本性的破局思路:彻底弃用孤立的纯文本切片,采用“知识图谱 + 语义向量”双擎驱动,将 Agent 的记忆构建为具备实体推理能力的拓扑网络。
一、传统切片 RAG 的“记忆失真”根因剖析
要理解 Cognee 的价值,必须看透传统向量切片在智能体长效记忆构建上的三层本质缺陷:
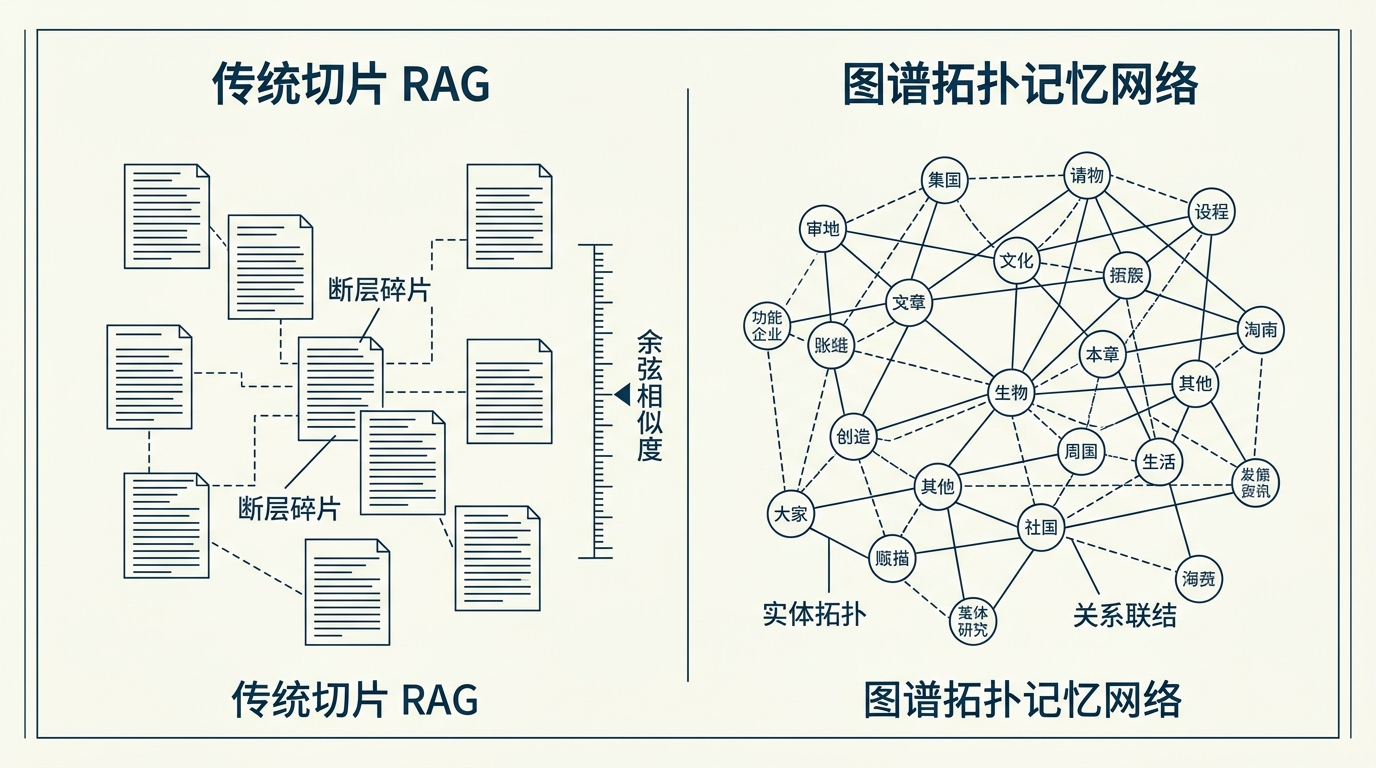
1. 时空与事件上下文断层:现实中的交互是有因果链条和时间维度的。切片算法粗暴地将文本按字符长度一刀切断,导致“前因”在 Chunk A,“后果”在 Chunk B。计算向量时,两者被分散在多维空间的不同坐标,检索时极难完整聚合。
2. 多跳关系推理无能为力:在复杂工程或企业业务中,问题往往涉及多个中介节点。例如“A 项目依赖的核心组件是哪个部门的谁负责维护的?”这种链式逻辑(Project A → Component X → Team Y → Person Z)在向量空间里没有任何直接相近的余弦值,导致向量检索彻底失效。
3. 记忆更新引发的“局部幻觉”:当某个技术选型被推翻或配置被更新时,传统向量库直接追加新记录。此时旧的废弃切片依然存在于高维空间,大模型在 Top-K 召回时经常把已过期的历史碎片与新规则混在一起,产生灾难性的逻辑幻觉。
二、双擎记忆架构:知识图谱连边 + 语义向量召回
Cognee 的核心突破在于:它不再把输入数据看作单纯的字符串流,而是将其看作一个由实体(Entity)、概念(Concept)和关系(Relation)构成的认知拓扑图。
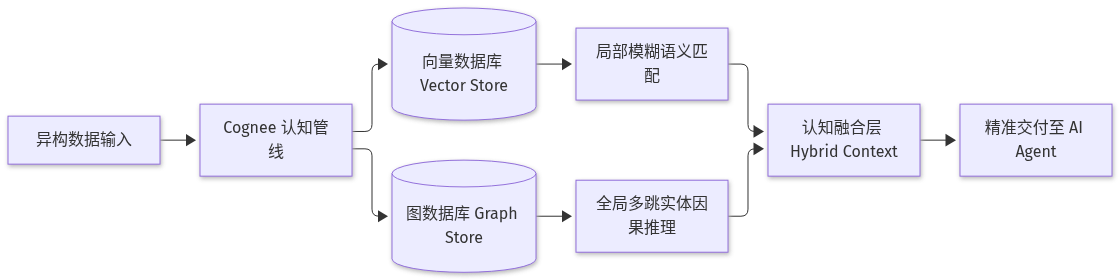
1. 双擎分工协同机制
在底层持久化层,Cognee 统一托管两种形态的数据库引擎:
- 向量数据库(Vector DB):如 LanceDB、Qdrant、Chroma 等,用于负责快速粗筛、模糊自然语言匹配与未结构化语段的语义召回;
- 图数据库(Graph DB):如 Kùzu、Neo4j、NetworkX 等,用于建立真正的节点连边(Edges),记录实体属性与关系(如 [张工] -承诺-> [迁移TiDB] -截止时间-> [2026-10-01])。
当检索发生时,Cognee 不是单纯执行余弦排序,而是以问题中的核心实体为起点,沿着图拓扑路径进行发散跳步(Multi-hop traversal),结合向量权重综合评分,把完整的逻辑网络打包为高质量 Context 交付给 Agent。
三、ECL 认知流水线:Extract、Cognify 与 Load
Cognee 将繁琐的知识工程解耦为三阶段标准流水线(ECL Pipeline),这也是其能够以几行代码嵌入现有系统的核心原因:
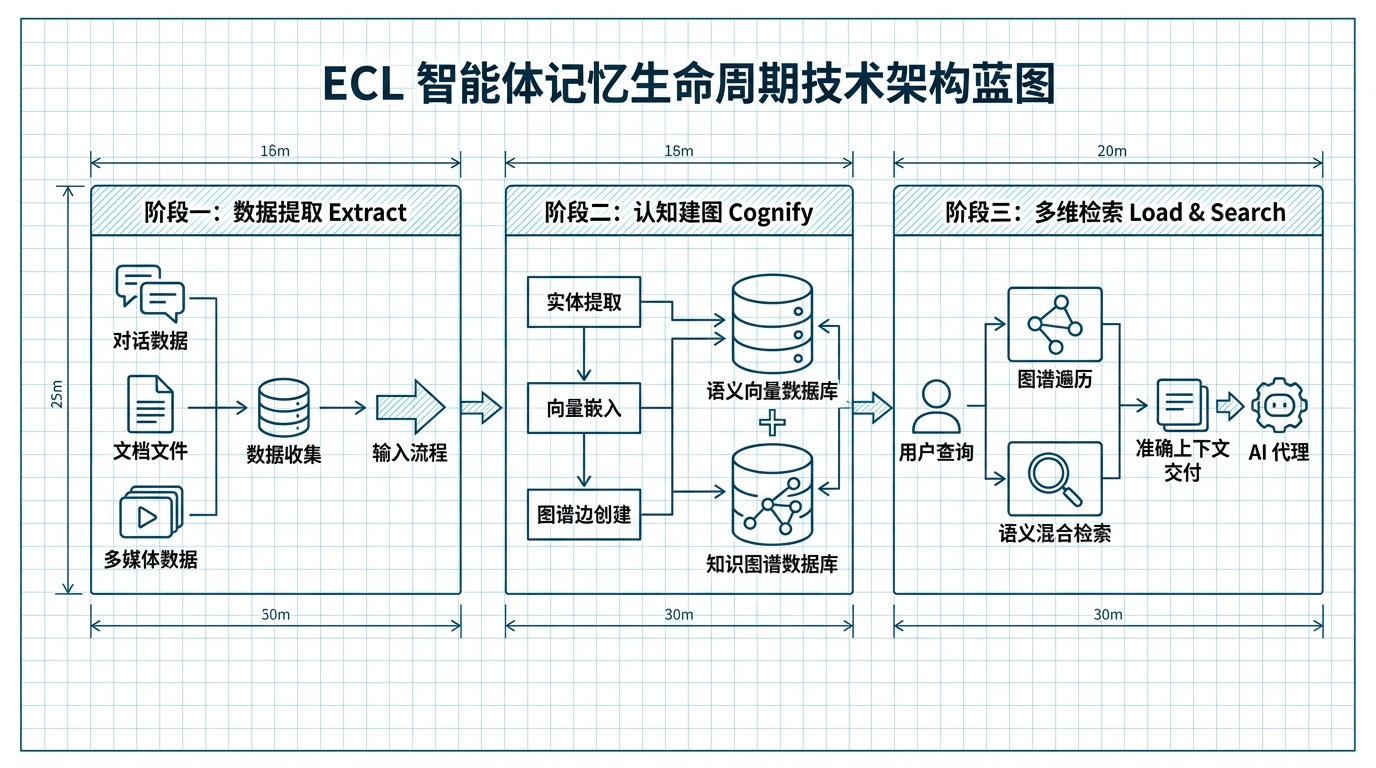
1. Extract(多源数据提取)
支持无缝摄取纯文本、Markdown、PDF 电子书、代码仓库、以及多轮对话历史记录,自动执行基础清洗并打上时间戳与元数据标识。
2. Cognify(认知建图与语义内化)
这是 Cognee 最关键的一步。在后台异步调度中,系统执行以下连贯操作: - 自适应语义分块(Smart Chunking):基于句子与段落语法边界拆分; - 向量嵌入计算(Embedding):调用预设的向量模型计算高维表征并存入向量引擎; - 实体与关系抽取(Ontology & Entity Extraction):利用轻量 LLM 识别文本中的主谓宾、专有名词、属性约束并构建三元组; - 拓扑建边与知识消歧(Graph Linking):将新节点与已有记忆图谱进行对齐,实现历史记忆的自动演进与修正。
3. Load & Search(多维检索与加载)
提供统一的高层查询接口,开发者无需手动编写复杂的 Cypher 图查询语句,通过自然语言调用 search() 即可自动完成图遍历与向量评分的混合融合输出。
四、极简工程落地:6 行代码为 Agent 补全长效记忆
Cognee 提供了极其清爽的 Python SDK,几乎可以在 5 分钟内接入现有的任何智能体项目(如 LangChain、LlamaIndex、CrewAI 或自建 Agent):
import asyncio
import cognee

async def main():
    # 1. 注入原始知识与对话上下文 (Extract)
    await cognee.add("张工上周承诺在10月前将订单库迁移至TiDB,李架构师要求保持双写。")

    # 2. 自动化执行语义嵌入、实体抽取与图谱建边 (Cognify)
    await cognee.cognify()

    # 3. 跨实体拓扑路径关联检索 (Search)
    results = await cognee.search("订单库迁移有什么要求?谁承诺的?")
    for item in results:
        print(item)

if __name__ == "__main__":
    asyncio.run(main())
1. 支持哪些存储与模型生态?
| 核心组件 | 支持的开源/云端技术栈 | 推荐本地离线组合 |
|---|---|---|
| LLM 推理引擎 | OpenAI, Anthropic, Ollama, vLLM, Azure | Ollama (Llama 3 / Qwen 2.5) |
| 向量存储 (Vector) | LanceDB, Qdrant, Chroma, Weaviate, PGVector | LanceDB (单文件内嵌,零网络开销) |
| 图存储 (Graph) | Kùzu, Neo4j, FalkorDB, NetworkX | Kùzu (极速内嵌图引擎,无需装服务) |
借助 Ollama + LanceDB + Kùzu 的全内嵌组合,开发者甚至可以在不联网、不启动任何 Docker 容器的情况下,直接在个人笔记本上跑通一套 100% 本地化且保护隐私的长效记忆中枢。
五、技术选型边界:什么时候该选 Cognee?
虽然图向量双擎大幅提升了召回的精准度,但开发者在工程选型时仍需看清边界:
- 典型适用场景:
- 多轮次长时间跨度 Agent:如虚拟助手、代码重构助手、项目管理智能体;
- 因果关系与实体密集型知识库:法律法规条文、医疗诊断指南、金融风控规程;
- 代码工程拓扑分析:跨微服务调用依赖、接口与实现类映射关系追踪。
- 不适用的场景:
- 海量非结构化文本快速全量粗排:如果只是数十万篇新闻文章做关键词粗搜,传统 Elasticsearch 或纯向量检索吞吐更高、计算开销更低;
- Cognify 阶段存在 LLM 开销:建图过程需要 LLM 解析三元组,初始建库耗时与 Token 消耗会高于普通切片。建议大批量入库时采用高吞吐量的小模型或离线批处理。
六、总结
Agent 从“玩具”迈向“工具”的核心门槛,正是能否拥有稳定、连贯、且不会随时间推移而退化的真实记忆。
Cognee 撕掉了传统 RAG“万物皆可余弦匹配”的遮羞布,用优雅的 ECL 流水线与图向量双擎,为智能体工程落地铺平了一条兼顾推理深度与开发效率的新路径。如果你的 Agent 还在因为切片断层而频频失忆,不妨在下一个版本中引入图谱记忆试试。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





