

告别空洞摘要与公式天书!开源 paper-craft-skills 实战:把复杂论文秒变出版级方法图与可编辑幻灯片
几乎每位算法工程师或科研人员都有过类似的痛苦经历:下载了一篇 20 页的顶会论文,不仅公式密密麻麻看不懂,读完之后还要抓耳挠腮去画技术汇报的方法图、做组会汇报的 PPT。
市面上所谓的“AI 论文阅读助手”早已泛滥成灾,但大部分工具往往只停留在表面:输入一篇 PDF,吐出一大段千篇一律的文本摘要,配上几张粗制滥造的模板插图。面对最消耗心力的“公式推导看不清、幻灯片牵一发而动全身、论文理论与 GitHub 开源代码完全脱节”等深层痛点,传统工具几乎全军覆没。
近期在开发者圈引发广泛热议的开源项目 paper-craft-skills,以其极其克制且直接的设计直击痛点。它无需繁琐的账号注册与中转平台,直接作为 Agent Skills 挂载进 Codex 或 Claude Code 中,仅凭三条核心斜杠命令,便将论文从纯文字推演全面升级为结构化、可视化、可复现的完整研读资产。本文将为你系统拆解其底层工程设计与落地实战技巧。
一、传统论文研读与现代化 Agent 研读流的降维对比
为什么说传统大模型论文摘要正在沦为“鸡肋”?根本原因在于工程落地的链路完全断裂。
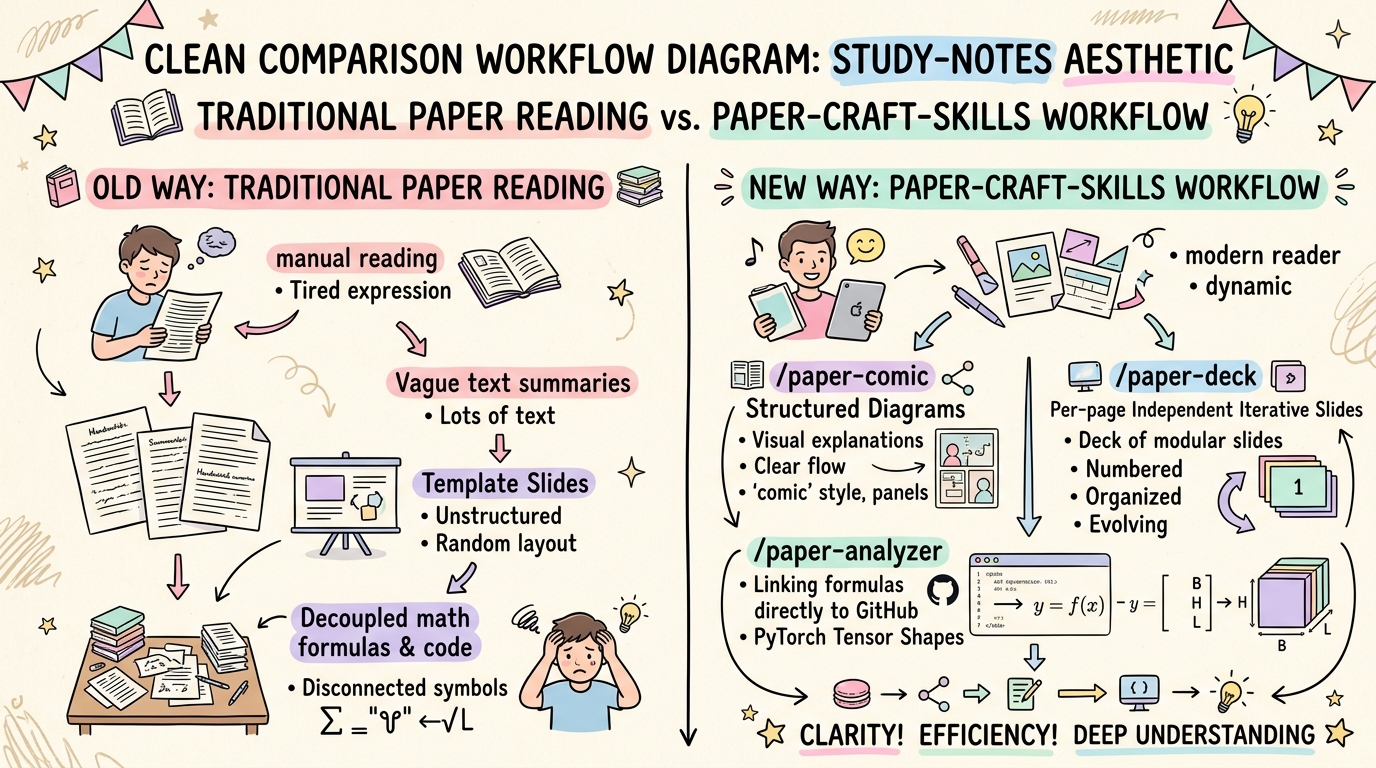
1.1 系统特性的多维度深层对比
我们可以通过下表系统梳理传统学术研读与 paper-craft-skills 带来的范式变革:
| 评估维度 | 传统 AI 论文阅读器 (Summary App) | paper-craft-skills 协同流 | 生产力突破价值 |
|---|---|---|---|
| 接入与使用门槛 | 需登录第三方 SaaS 平台,上传受大小限制 | 仅需 npx skills add,直接在本地 Agent 中原生运行 |
零隐私泄露隐患,本地未发表的 Draft PDF 亦可安全解析 |
| 视觉呈现能力 | 纯靠 Markdown 排版,缺乏高质量插图 | 提供出版级(Publication-grade)方法重绘指令 | 针对架构、机制自动生成高清矢量流程图与笔记手绘图 |
| 幻灯片生成机制 | 整体生成一个不可改或死板的 PDF | 遵循“Brief → Outline → Per-page Prompt”流程 | 导出原生可编辑 .pptx,单页修改无需全局重新推倒 |
| 公式与代码映射 | 公式被当作纯数学文本孤立翻译 | 自动检索 GitHub 开源库,将数学公式与张量代码对齐 | 彻底击碎“公式像玄学,代码接不上”的理解鸿沟 |
| 图表渲染格式 | 低分辨率位图截图 | 原生支持 KaTeX 复杂公式与 Mermaid 动态图表 | 完美兼容学术排版规范,方便直接嵌入研报与论文初稿 |
1.2 学术工作流中最耗时的“隐形脏活”
做过技术分享或论文答辩的同学都有深刻体会:阅读论文本身只占 40% 的时间,剩下的 60% 全在干“脏活”:
1. PPT 返工灾难:以往让大模型生成 PPT,若第 5 页的排版不满意,重新生成时前 4 页往往也被随机冲掉,缺乏局部确定的能力;
2. 方法图重画:作者原图太模糊、或者缺少细节分支,必须用 Visio / draw.io 手动画半天;
3. 符号与张量对应:论文里的上标、下标和投影矩阵到底对应 PyTorch 里的哪个 view() 或 transpose()?
paper-craft-skills 正是针对这三个重灾区,量身打造了模块化的功能闭环。
二、paper-craft-skills 三大核心引擎深度拆解
深入分析其 Skill 结构,该项目将复杂的学术转化链路清晰拆分为三个互相独立又可串联的子指令:
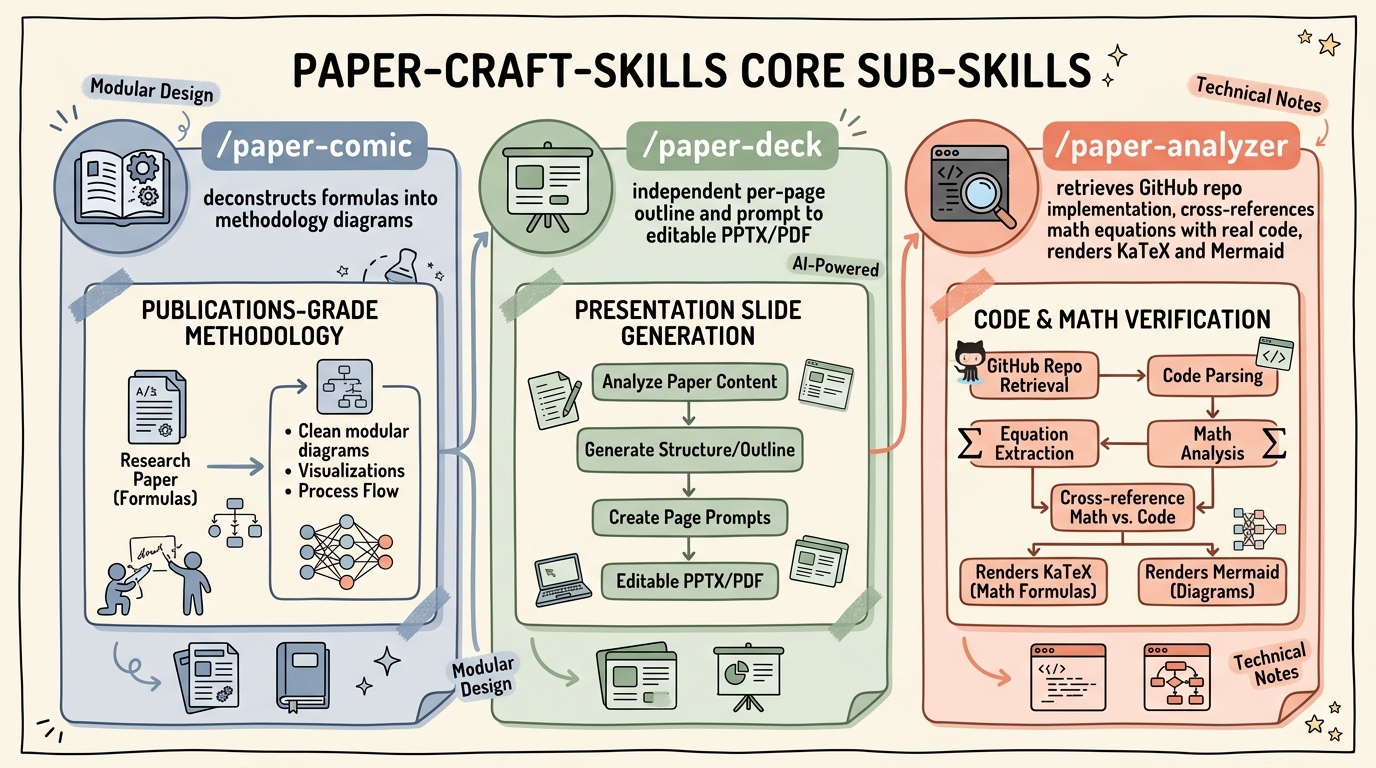
2.1 /paper-comic:将晦涩公式解构为出版级方法图
- 当用户指定一篇论文后,该指令首先通过 LLM 进行结构化语义抽取,自动提取论文中最核心的 2~3 个创新机制(例如 Transformer 中的 Scaled Dot-Product 与 Multi-Head Attention);
- 提供“出版级学术方法图”与“知识手绘笔记风”双重风格矩阵,帮助演讲者或创作者根据受众自由切换;
- 排坑警示:学术图表“好看”不等于“正确”。Agent 会生成详细的节点连接关系草案供人工审阅,避免因幻觉产生箭头的遗漏或多余。
2.2 /paper-deck:支持单页精准微调的可编辑幻灯片
- 绝不搞一揽子随机生成的“黑盒 PPT”,而是严格遵循自顶向下的三层递进:
- Deck Brief:梳理演讲目标、受众知识背景与核心结论;
- Page-by-page Outline:确定每页幻灯片的具体主题与信息密度(通常 8~12 页);
- Independent Per-page Prompt:为每一页单独生成视觉提示词与版式规则;
- 最终导出为完全兼容 Microsoft PowerPoint 的
.pptx与.pdf。如果你想微调第 7 页的消融实验对比,只需单独对第 7 页发出指令,其余页面保持绝对不变!
2.3 /paper-analyzer:数学公式与真实代码的跨模态对齐
- 很多时候论文公式抽象到极致,但看一眼 PyTorch 源码立刻顿悟。
/paper-analyzer会主动联网检索该论文对应的顶级 GitHub 开源实现; - 将论文中的方程(如 Loss 函数、注意分配权重)逐行对齐到开源仓库中的具体文件名与行号(如
models/attention.py#L45); - 全文支持 KaTeX 高清数学公式渲染与 Mermaid 流程图嵌入,直接输出结构严谨的高质量解读稿。
三、工程实战:5 分钟完成顶会论文全景解读
下面我们以经典的注意力机制论文《Attention Is All You Need》为例,展示完整的落地调用流。
3.1 技能挂载与环境准备
借助现代化 Agent 包管理器,安装仅需一行指令:
# 在 Claude Code 或 Codex 所在工作区挂载
npx skills add zsyggg/paper-craft-skills
3.2 驱动执行流水线
在 Agent 对话中依次键入核心指令:
"""
模拟 paper-craft-skills 调度流程
"""
import json

class PaperWorkflowExecutor:
    def __init__(self, arxiv_url: str):
        self.arxiv_url = arxiv_url

    def generate_presentation(self):
        print(f"[*] Analyzing arXiv structure: {self.arxiv_url}")
        # 1. 拆解逐页 Outline
        deck_plan = [
            {"slide": 1, "title": "Background & Bottlenecks in Recurrent Nets"},
            {"slide": 2, "title": "Scaled Dot-Product Attention Formulation"},
            {"slide": 3, "title": "Multi-Head Mechanism & Linear Projections"},
            {"slide": 4, "title": "Complexity Analysis: Self-Attention vs Recurrent"}
        ]
        return deck_plan

    def link_github_code(self):
        # 2. 对齐 GitHub 核心张量运算
        return {
            "Formula (Softmax Attention)": "torch.matmul(q, k.transpose(-2, -1)) / math.sqrt(d_k)",
            "Multi-Head Concat": "torch.cat(heads, dim=-1)"
        }

if __name__ == "__main__":
    executor = PaperWorkflowExecutor("https://arxiv.org/abs/1706.03762")
    plan = executor.generate_presentation()
    code_map = executor.link_github_code()
    print("Execution pipeline ready.")
控制台与 Agent 终端反馈:
[paper-deck] Extracted Paper Abstract & Claims successfully.
[paper-deck] Generated 10 slide cards outline.
[paper-deck] Slide 4 Prompt: "Split comparison table: Complexity per layer and Sequential operations across RNN vs Self-Attention"
[paper-deck] Exported: Attention_Is_All_You_Need_Deck.pptx (2.8MB, fully editable shapes).
[paper-analyzer] Cloning GitHub repository 'huggingface/transformers'...
[paper-analyzer] Mapped Eq. (1) to src/transformers/models/bert/modeling_bert.py:L240
四、科研与算法团队的落地避坑指南
尽管 paper-craft-skills 极大地削减了格式化脏活,但在严肃科研与工程落地中,请牢记以下边界防线:
4.1 警惕方法流程图的“过拟合美观”
- 模型生成的架构图往往具有极高的视觉质感,但极易在细节(如跳跃连接 Skip Connection、Norm 层在前还是在后)发生细微错位;
- 永远把生成的图作为初稿架构骨架,在正式发表或向主管答辩前,必须结合论文原著进行至少一次硬核人工校验。
4.2 公式符号上下文一致性
- 部分论文在不同章节可能存在符号混用的现象(例如 $d_k$ 与 $d_v$)。在使用
/paper-analyzer解析时,建议在 Prompt 中明确要求建立全局符号对照表(Symbol Glossary),确保张量维度的推导在整套 Slides 中完全自洽。
总结
AI 时代的技术演进,正在将知识工作者从大量枯燥、重复的格式排版与视觉拼凑中解放出来。paper-craft-skills 的成功不在于它使用了多么高深的模型,而在于它真正理解了学术与研发读者的真实困境。通过将论文研读工作流解构为模块化的图解、单页可编辑幻灯片以及公式代码联动,它让顶会论文不再是锁在 PDF 里的冷门天书,而是能以极快速度转化为工程师手中的可执行资产。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





