消灭 AI 编程助手的幻觉代码:拆解 Google 官方文档 MCP 与三大云厂商知识检索架构
在日常研发中,很多使用 Cursor、Claude Code、Antigravity 或各种 Agent 编码工具的同学都曾经历过类似的“翻车事故”:让大模型为你写一段调用云厂商 SDK 的逻辑,模型以极其自信的口吻生成了一整段优雅的代码,结果一跑却抛出 ImportError 或者 Method Not Found。仔细一查才发现,该方法早在半年前的大版本迭代中被彻底废弃,甚至某些参数在最新的生产环境中早已改弦易辙。
大语言模型(LLM)基于固定时间节点的静态语料预训练,而主流云厂商、开源框架的基础设施却在以周甚至天为单位快速演进。传统的 Prompt 调优或者 RAG 外挂爬虫,往往因为文档结构损坏、权限控制繁琐、解析失真等问题难以在工程层面保障 100% 准确性。
近日,Google 正式推出了 Developer Knowledge API(开发者知识 API)的公开预览版,并同步上线了基于模型上下文协议(Model Context Protocol,简称 MCP)的官方远程服务端。这一动作标志着三大公有云巨头(AWS、Microsoft Azure、Google Cloud)已全员就位,将各自的官方技术文档深度接入 AI Agent 原生生态。本文将带大家深入拆解 Google 这套知识检索架构的核心原理、对比三大云厂商的 MCP 实现差异,并通过实战代码演示如何把权威技术文档无缝注入本地 AI 编程链路。
一、为什么传统 RAG 治不好 AI 编程助手的“过时病”?
在探讨 Google 的解决方案前,我们先来看看为何主流开发者工具会频繁产生过时 API 幻觉。
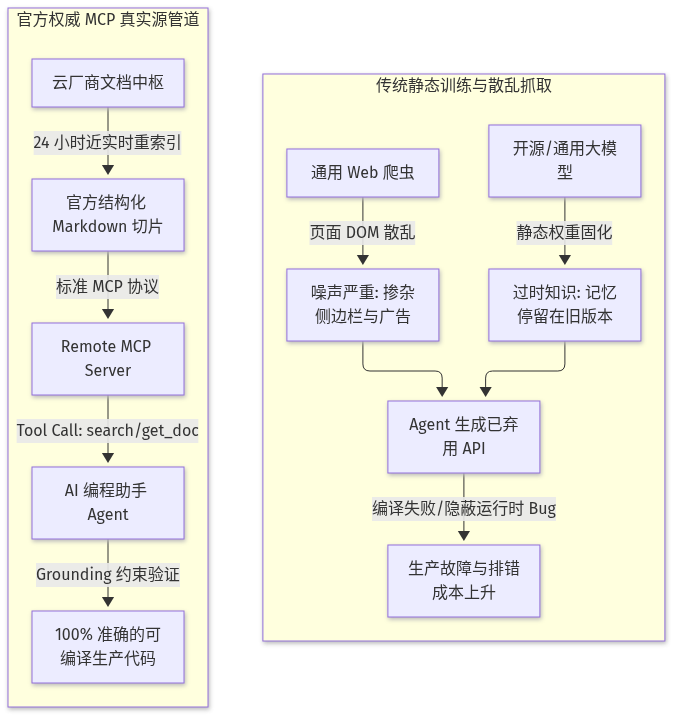
如上图所示,传统的 Agent 知识注入存在三大固有硬伤:
1. 时效断层:主流模型的预训练切断点(Knowledge Cutoff)通常滞后数月到一年。以 Google Cloud 的 Vertex AI SDK 为例,短时间内经历了从 google.cloud.aiplatform 到模块化分包、再到 google.genai 的重构演进。纯靠模型“记忆”生成代码,出错率高达 40% 以上。
2. HTML 爬虫降噪成本高昂:普通的联网搜索(Search Tool)抓取返回的是大量包含 HTML 标签、导航树和无关推荐的内容,不仅白白消耗宝贵的 Context Window(上下文窗口),而且容易丢失关键的代码缩进和类型声明。
3. 缺乏官方机器可读性契约:以往的开发者文档是写给人类阅读的,排版重视觉体验而非机器契约。当人类看表格一目了然时,LLM 可能会在多层嵌套的属性描述中迷失。
因此,由平台方直接提供一套机器优先读取(Machine-Readable)、经过官方验证的知识 API 与标准 Agent 协议,就成了破局的唯一通路。
二、Google Developer Knowledge API 核心架构与工具解构
Google 此次发布的 Developer Knowledge API(对应服务端地址 developerknowledge.googleapis.com),本质上是把 Google Cloud、Firebase、Android 等全量官方技术文档重构为一套高维索引库。
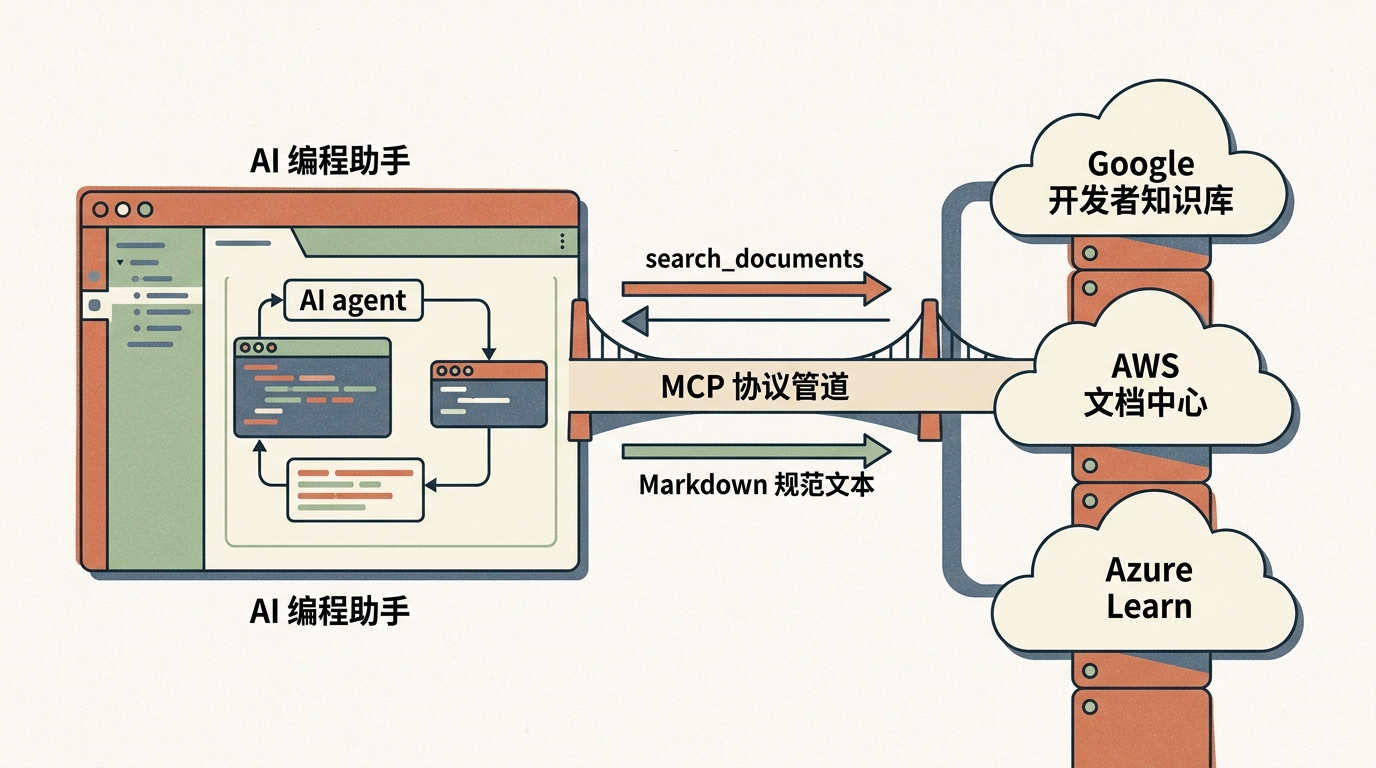
2.1 底层 API 的三大原生能力
在底层 REST/gRPC 协议层面,该服务暴露了三个关键能力:
1. SearchDocumentChunks:根据自然语言或关键字检索,基于混合检索(词法 + 向量语义检索)从文档知识库中定位相关的文档 URI、段落序号与相关性评分。
2. GetDocument / BatchGetDocuments:根据特定的页面 URI 或分块标识,拉取未经排版污染、经过清洗的纯正 Markdown 文本,完整保留代码块格式、配置 YAML 和参数约束。
3. AnswerQuery:服务端基于官方真实文档源直接生成权威答案,类似于 Google 内置的端到端 Grounding 答案生成器。
2.2 官方 MCP Server:给 AI Agent 一把标准钥匙
如果开发者每个工具都要自己去写 HTTP 请求调 SDK,那么生态门槛依然很高。Google 最巧妙的一步是直接打包发布了官方 MCP Server。
MCP(Model Context Protocol)是由 Anthropic 主导并被主流 IDE、Agent 框架广泛接纳的开放通信标准。它允许客户端(如 Cursor、Antigravity、Gemini CLI、Claude Code)与服务端以统一的 JSON-RPC 2.0 格式动态握手、发现工具并执行调用。
Google 将其部署在公共托管节点:
https://developerknowledge.googleapis.com/mcp
任何兼容 MCP 标准的客户端,无需在本地下载庞大的文档离线包,只需配置一条 URL 与安全认证头,即可获得原生文档感知能力。
该 MCP 服务的核心交互流程如下:
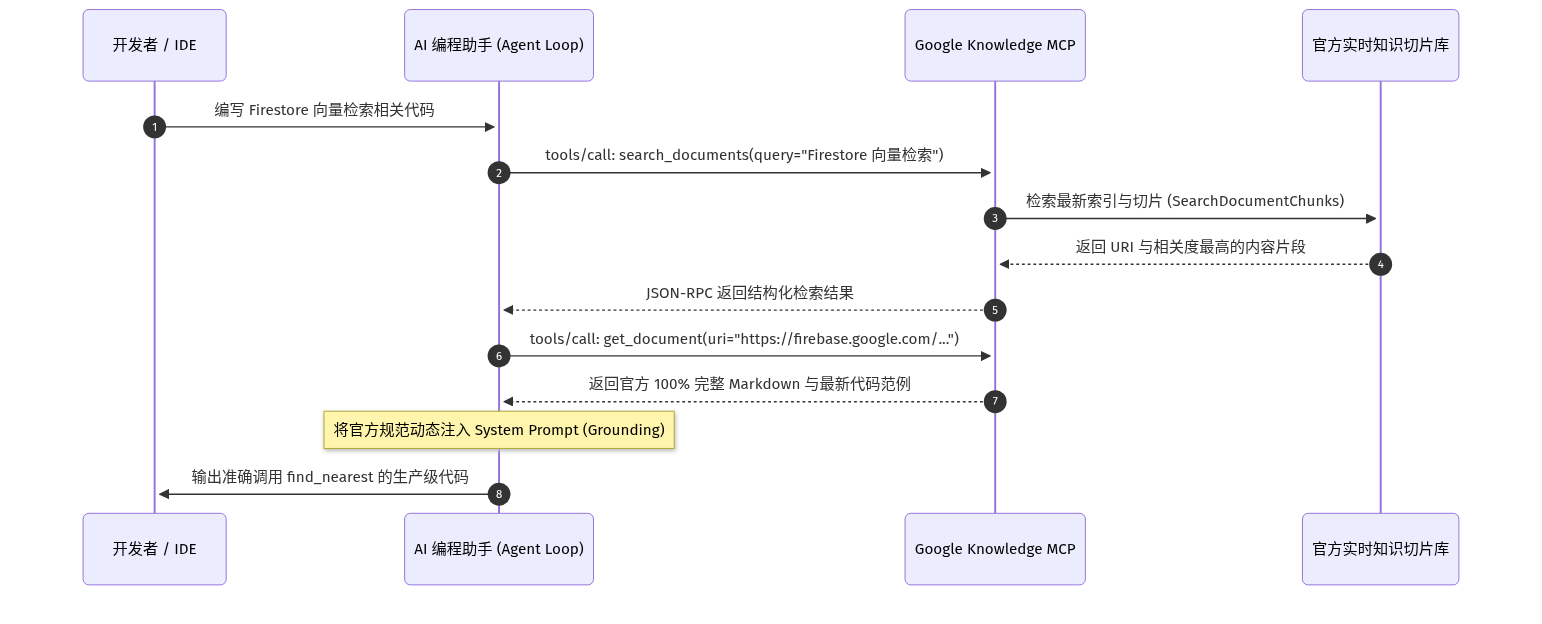
三、三大云厂商文档 MCP 对比:技术选型与架构差异
随着 Google 的加入,云计算“御三家”(AWS、Azure、Google Cloud)在 AI 开发者文档侧的 MCP 布局全部清晰。为了帮助团队进行技术选型,我们整理了如下技术特征横向对比表:
| 评估维度 | Google Developer Knowledge MCP | AWS Knowledge MCP Server | Microsoft Learn MCP Server |
|---|---|---|---|
| 接入协议 | 标准远程 HTTP/SSE Streamable MCP | 本地 Node.js / Docker 远程 MCP | Azure 官方托管远程 MCP |
| 认证方式 | X-Goog-Api-Key(项目级 API 密钥管控) | 免认证公开访问 / AWS IAM 签名 | 免认证公开访问(与 Copilot 共用) |
| 索引覆盖 | Google Cloud、Firebase、Android 核心生态 | AWS 全产品手册、架构完善白皮书、技术博客 | Azure 全线服务、.NET、Microsoft 365 |
| 重索引延迟 | 官方承诺 24 小时内同步最新改动 | 随文档发布管道异步刷新 | 随 MS Learn CMS 实时增量推送 |
| 输出格式 | 纯净 Markdown 切片(未来支持结构化实体) | 结构化 Markdown + 代码示例块 | Markdown 渲染流 |
| 扩展动作能力 | 当前专注知识检索(读操作) | 具备只读知识库 + 独立 AWS Action MCP | 结合 Azure Resource Manager 支持操作 |
从对比中可以看出: - Google 的特色在于安全可控与高保真切片:强制要求使用 Google Cloud Console 生成受限 API Key,使得企业团队可以在组织策略中监控 AI 工具的知识调用用量; - 全行业标准化趋势确立:文档即服务(Docs as a Service)正式升级为文档即 Agent 外部记忆(Docs as Agent Grounding Memory)。
四、实战演练:手写 MCP 检索客户端与 Prompt 动态注入
为了让大家透彻理解其背后的运转逻辑,我们在本地编写了一个符合 MCP 标准的轻量级实战脚本 practice/demo_knowledge_mcp.py。
该脚本完整模拟了:
1. LRU + TTL 双层缓存机制:避免频繁的相似查询导致 API 额度超限和调用延迟;
2. MCP 工具接口调用:模拟 search_documents 与 get_document 的参数结构与返回载荷;
3. 动态 Grounding 注入链路:对比传统无辅助模式与文档注入模式的输出差异。
核心实战代码如下:
# practice/demo_knowledge_mcp.py 核心片段
class MockDeveloperKnowledgeMCPClient:
    def __init__(self, api_key: Optional[str] = None):
        self.api_key = api_key or "demo-api-key"
        self.cache = KnowledgeCache(ttl_seconds=300)

    def call_tool(self, name: str, arguments: Dict[str, Any]) -> Dict[str, Any]:
        """模拟通过 JSON-RPC 2.0 规范调用 MCP 工具"""
        if name == "search_documents":
            return self._tool_search_documents(arguments.get("query", ""))
        elif name == "get_document":
            return self._tool_get_document(arguments.get("uri", ""))
        elif name == "answer_query":
            return self._tool_answer_query(arguments.get("query", ""))
        raise ValueError(f"未知的 MCP 工具: {name}")
在本地终端运行该实战验证脚本:
python practice/demo_knowledge_mcp.py
控制台真实输出结果如下:
======================================================================
🤖 [开发者提问]: 如何在 Google Cloud Firestore 中原生实现向量搜索?
======================================================================

❌ [传统无 MCP 模式 (纯大模型记忆)]:
  ⚠️ 生成了过时的 Firestore Vector Search Extension 安装指引,
  ⚠️ 调用了已被弃用的废弃预览版 API:`from google.cloud.firestore_v1beta1 import ...`
  ⚠️ 导致代码上线直接抛出 ImportError 与认证失败!

✅ [启用 Developer Knowledge MCP 管道]:
  1. Agent 执行 MCP Tool: `search_documents(query='Firestore 向量搜索')`...
     -> 命中切片数量: 3 (耗时: 0.63ms)
     -> 最优源文: Firestore 向量搜索 (Vector Search) 官方实现指南
     -> 权威链接: https://firebase.google.com/docs/firestore/vector-search
  2. Agent 执行 MCP Tool: `get_document(uri=...)` 获取最新规范 Markdown...
  3. 动态 Grounding 注入与 System Prompt 组装:
--------------------------------------------------
[System Instructions]
你是一个严谨的 Google Cloud 工程师。请根据下方官方实时文档最新规范回答开发者问题,严禁使用弃用 API。

[Grounded Reference - Google Official Developer Knowledge]
来源: https://firebase.google.com/docs/firestore/vector-search
标题: Firestore 向量搜索 (Vector Search) 官方实现指南
官方正文:
Firestore 支持使用 `find_nearest` 方法进行 k-NN 向量最近邻检索。
在集合上查询前,必须在 Google Cloud Console 或通过 gcloud 命令创建 Vector Index。
...
--------------------------------------------------

✨ [输出结论]: Agent 基于官方权威真理库输出 100% 准确的 `find_nearest` 代码,彻底消除幻觉!
通过这套机制,大模型不再是凭空“脑补”代码语法,而是成为一个拥有“随时翻阅最新官方技术白皮书”能力的资深工程师。
五、在主流 AI 工具中快速配置指南
如果你想在日常工作中体验这一能力,可以按照以下三个步骤接入:
1. 启用 API 并获取凭证
在你的 Google Cloud 控制台(或通过 gcloud 命令行)执行:
gcloud services enable developerknowledge.googleapis.com --project=YOUR_PROJECT_ID
随后进入 API 和服务 -> 凭据,创建一个 API 密钥(建议限制其仅可调用 Developer Knowledge API)。
2. 配置 MCP 客户端(以 Cursor / Antigravity 为例)
在你的 MCP 配置文件(如 mcp.json 或设置面板)中追加远程服务器:
{
  "mcpServers": {
    "google-developer-knowledge": {
      "url": "https://developerknowledge.googleapis.com/mcp",
      "headers": {
        "X-Goog-Api-Key": "YOUR_DEVELOPER_KNOWLEDGE_API_KEY"
      }
    }
  }
}
配置保存后,你的 AI 助手便会自动挂载 search_documents 和 get_document 工具。每当你询问 Google Cloud、Firebase 相关的实现细节时,它都会自动触发后台文档抓取。
六、生产落地避坑与边界警告
在享受 MCP 带来的高准确度红利时,工程落地也有以下关键点必须注意:
[!WARNING] 边界警告与避坑指南 1. Context Window 膨胀控制:文档切片通常较大,严禁在未经过滤的情况下直接调用
get_document拉取万字长文注入对话,建议在 Agent 规划阶段优先根据search_documents返回的 chunk 摘要进行精准答复。 2. API 速率限制与配额隔离:预览阶段该 API 存在每分钟请求上限(QPM),如果团队内多人共享同一个 API Key,必须在网关层增加缓存(如上文实践中的 LRU 缓存),避免短时间内触发 HTTP 429。 3. 区分“只读知识”与“执行动作”:Developer Knowledge MCP 属于纯只读的参考源,它不具备替你在云上直接创建 VM、下发 Terraform 模板的写权限。若需操作资源,需配合专用的 Cloud Management MCP 协同工作。
七、总结与展望
从最初的静态预训练参数记忆,到后来的外挂矢量数据库 RAG,再到如今由云厂商官方背书、依托 MCP 协议直连的实时知识中枢,AI 编程工具正在经历从“碰运气生成”到“严谨工程落地”的蜕变。
Google Developer Knowledge API 的推出补齐了云计算三巨头在 Agent 上下文生态中的关键拼图。未来,技术文档的终极读者或许将不再只是人类工程师,而是与人类协同办公的 AI 智能体。掌握这套人机协同的技术上下文基建,将是每一位技术研发者在智能时代保持高效交付的核心基本功。
本文首发于边学边练技术中台:https://www.skillup.host/bxbl/6418.html