狂揽9万Star的开源终端AI架构:深入拆解OpenCode的Client-Server双模执行内核与本地代码上下文管道
随着以 Claude Code、Cursor、Aider 为代表的 AI 研发智能体迅速风靡开发者生态,终端(Terminal)正在成为人机协同编程的核心战场。在这场终端革新浪潮中,GitHub 上狂揽 95k+ Star 的开源黑马项目 OpenCode 以极简的纯终端交互、极快的启动响应以及严密的执行沙盒引发了全球工程团队的广泛关注。本文将带你穿透其表面交互,深入其 Client-Server 架构内核、Plan/Build 双模沙盒机制与 AST 代码上下文管道。
1. 终端 AI 编程工具的范式转移:从单体 CLI 到 Client-Server 分层
在过去的 AI 编码工具设计中,绝大多数开源 CLI 项目都采用了最朴素的“单体单进程(Monolithic CLI)”架构:一个终端进程内既负责终端按键渲染(TUI)、又负责与 LLM API 建立长连接流式通信,同时直接对宿主机本地文件进行物理读写并调用 Bash 子进程。
然而,当开发场景从“单轮代码片段生成”迈向“长周期工程级重构”时,单体 CLI 暴露出了三大根本性架构缺陷:
1. 会话生命周期与终端窗口强耦合(Terminal Fragility):- 开发者在排错或调试时经常会切换窗口、甚至因网络颠簸或误触 Ctrl+C 中断终端;- 在单体模式下,CLI 进程崩溃或退出意味着整个运行中的上下文记忆、子任务执行树与 LLM 长调用直接夭折,无法实现会话的无感恢复与后台持续托管。
2. 安全隔离屏障缺失(Unrestricted Execution Risk):- 智能体被赋予了写文件与执行终端命令的权限。若没有独立的隔离保护层,模型一旦产生幻觉,可能直接执行 rm -rf、覆盖核心环境配置文件或越权访问敏感目录(Path Traversal);- 在同一进程空间内,难以对“只读规划(Plan)”与“受控修改(Build)”进行绝对的物理级权限隔离。
3. 高并发与多端接入扩展性差(Rigid Interface):- 现代软件工程往往需要终端 TUI、IDE 扩展插件(VS Code / JetBrains / Cursor)、甚至团队共享网页端同时观测或操作同一个任务;- 单体 CLI 无法对外暴露标准化的 IPC 或 WebSocket 协议,阻断了多客户端协同的可能性。
为了从根本上化解上述痛点,OpenCode 选择了彻底的 Client-Server 架构解耦。
2. OpenCode 核心架构解密:Daemon 守护进程、TUI 视图与事件总线
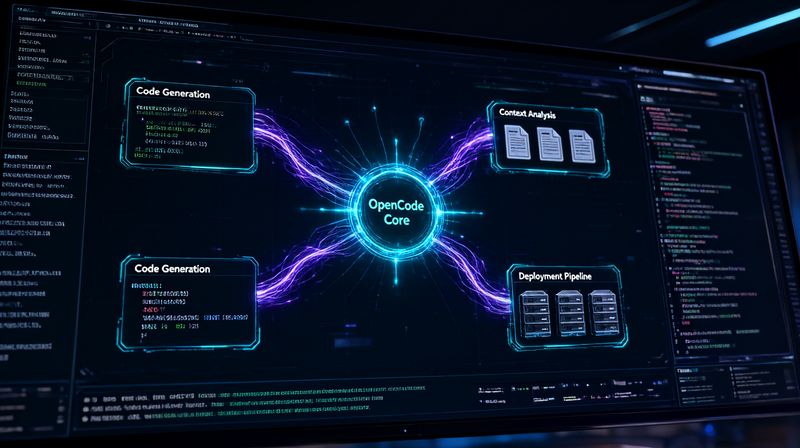
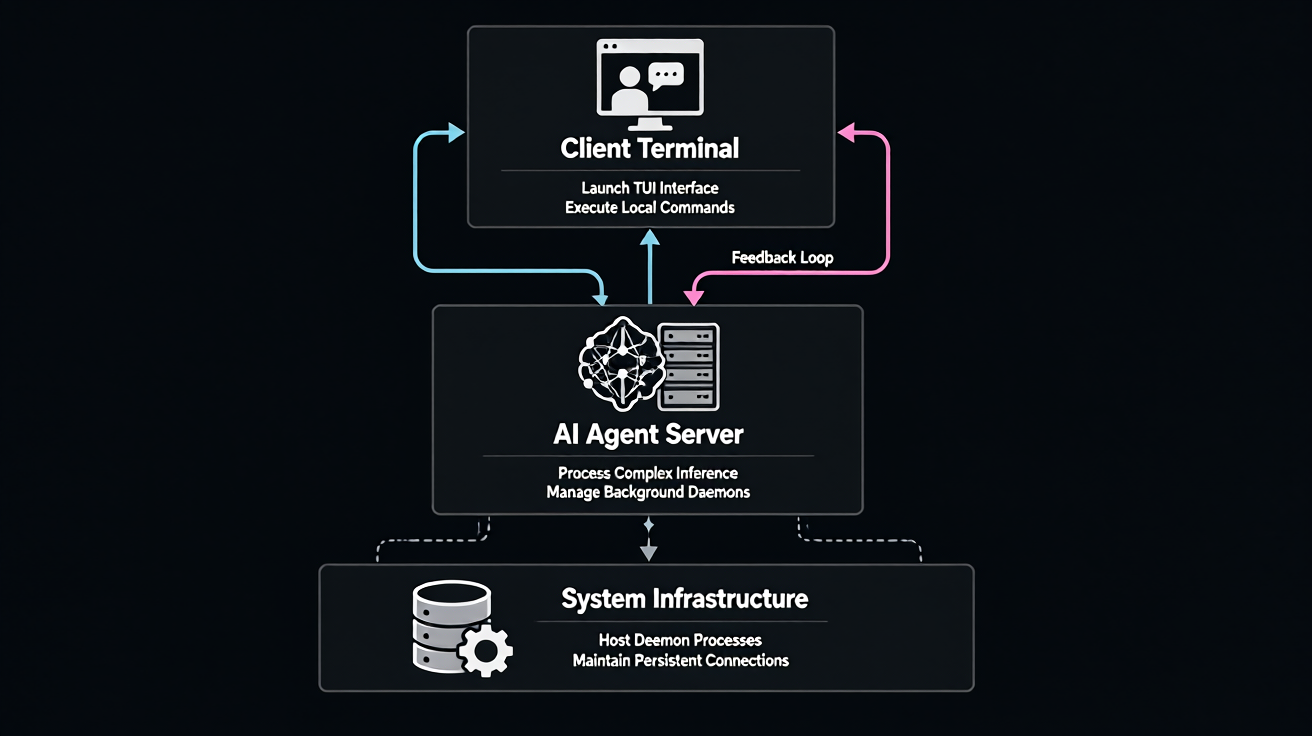
OpenCode 将整个系统的运转划分为三个清晰的正交层级:后台守护服务(Daemon Server)、轻量交互终端(TUI Client) 以及 事件驱动消息总线(Event Bus)。
2.1 后台守护服务(OpenCode Daemon)
守护进程是系统的唯一控制中枢,通常作为后台无头守护服务运行,负责管理:
- 工程级代码索引库:实时监控工作区目录变化(File Watcher),维护 AST 代码符号与项目依赖树;
- 任务状态机管理:跟踪每一个任务从 IDLE -> PLANNING -> AWAITING_APPROVAL -> EXECUTING -> COMPLETED 的生命周期;
- 事务日志与撤销栈(Undo / Rollback Journal):在执行真实文件修改前,自动落盘原子快照,支持任意时刻的一键无损回滚;
- 标准化 IPC 接口:通过本地 Unix Domain Socket 或高并发 HTTP/WebSocket 总线,向前端客户端提供标准 JSON-RPC 契约。
2.2 轻量终端界面(TUI Frontend)
前端客户端仅作为一个极轻量级的“纯渲染与按键采集器”:
- 采用高性能终端渲染引擎(如基于 Rust/Go 或轻量 Node.js 终端流),专注于极速按键捕获、Markdown 流式高亮排版与进度指示器展示;
- 无论终端意外关闭或重启,只需再次执行 opencode attach,客户端便能立刻重新连接到后台守护服务,100% 完整复原当前执行现场。
3. 双模执行沙盒:Plan Mode 与 Build Mode 的安全隔离
OpenCode 最受资深工程师称道的核心特性之一,在于其原生内置的 Plan(规划)与 Build(构建)双模沙盒隔离机制。
| 核心维度 | Plan Mode(只读规划模式) | Build Mode(构建执行模式) |
|---|---|---|
| 核心目标 | 调研上下文、评估方案、输出影响面分析与 Diff 预演 | 用户审批后,受控写入文件、运行测试与编译命令 |
| 磁盘写入权限 | 🚫 严禁落盘(物理拦截任何写入调用) | ✅ 受控落盘(仅允许修改已获批的目标文件) |
| 命令执行权限 | 仅允许只读探测命令(如 git status, tree, ls) |
允许指定测试脚本与构建脚本(如 pytest, cargo test) |
| 变更暂存形式 | 纯内存虚拟文件系统(In-Memory Stage Buffer) | 带有回滚快照保护的物理写入机制 |
| 适用阶段 | 需求理解、方案探讨、复杂架构变动前置审查 | 确认代码差异、执行增量变更与自动化回归验证 |
3.1 内存暂存缓冲与差异生成
在 Plan Mode 下,模型即便给出了修改代码的指令,底层的沙盒拦截器(Sandbox Barrier)也会强行剥离写权限。所有文件变动均被拦截并重定向至内存暂存字典 staged_changes 中。
随后,系统自动通过类似 diff-match-patch 算法生成色彩斑斓的 ANSI 差异比对卡片,向开发者呈现清晰明确的“准备变更清单”。只有当开发者主动敲下 Enter 或输入确认指令时,状态机才会被解锁并准许流转至 Build Mode,从根源上斩断了 AI “自作主张破坏代码”的风险。
4. 本地代码检索与上下文组装:AST 符号提取与 Token 预算截断
大模型终端工具的成败,70% 取决于其提供的上下文是否“精准且紧凑”。若一股脑将几十个源文件全量喂给大模型,不仅迅速耗尽上下文窗口、引发推理延迟暴涨,更会因为“注意力分散(Needle in a Haystack)”导致模型逻辑失准。
OpenCode 采用了基于 AST(抽象语法树)符号骨架 + Token 预算自适应截断 的上下文组装管道:
[ 项目源文件集合 (.py/.ts/.rs/.go) ]
               │
               ▼
   [ AST 解析与符号骨架抽取 ]
   ├── ClassDef: 类名与基类继承关系
   └── FunctionDef: 函数名与核心输入参数契约
               │
               ▼
   [ Token 预算自适应截断算法 ]
   ├── 优先保证关键入口文件与强相关模块
   └── 超出 Token 预算(Token Budget)自动安全截断
               │
               ▼
   [ 生成紧凑型上下文 Prompt 载荷 ]
通过这一管道,OpenCode 能够将原本需要消耗 50,000 Token 的庞大工程源码,浓缩为仅需 1,500 Token 的精准符号骨架,既保留了完整的函数拓扑与类型契约,又极大节省了推理算力。
5. 开源实训:基于 Python 模拟实现轻量级 OpenCode 守护服务与执行状态机
为了让开发者能够深入理解其内部机理,本项目已在开源实训库中归档了 Lab 61。我们使用真实可运行的代码,从零构建了包含 AST 符号提取、双模沙盒与事务回滚的核心仿真引擎。
5.1 核心实训代码片段
以下是实训库 labs/opencode-terminal-ai-agent-architecture/opencode_engine.py 中的关键实现:
import ast
import os
from enum import Enum
from typing import Dict, List, Any, Optional

class ExecutionMode(str, Enum):
    PLAN = "PLAN"    # 只读模式,仅生成变更计划与差异比对,严禁写入
    BUILD = "BUILD"  # 构建模式,可执行受控文件写入与命令调用

class TaskState(str, Enum):
    IDLE = "IDLE"
    PLANNING = "PLANNING"
    AWAITING_APPROVAL = "AWAITING_APPROVAL"
    EXECUTING = "EXECUTING"
    COMPLETED = "COMPLETED"
    ROLLED_BACK = "ROLLED_BACK"

class ASTContextRetriever:
    """基于 AST 抽象语法树的代码上下文提取器,支持预算自适应截断"""
    @staticmethod
    def extract_symbols(code: str) -> Dict[str, List[str]]:
        classes, functions = [], []
        try:
            tree = ast.parse(code)
            for node in ast.walk(tree):
                if isinstance(node, ast.ClassDef):
                    classes.append(node.name)
                elif isinstance(node, (ast.FunctionDef, ast.AsyncFunctionDef)):
                    functions.append(node.name)
        except SyntaxError:
            pass
        return {"classes": sorted(list(set(classes))), "functions": sorted(list(set(functions)))}
5.2 运行与断言自检
在控制台执行测试脚本,5 组核心断言全部通过:
python3 labs/opencode-terminal-ai-agent-architecture/opencode_engine.py
==================================================
🧪 正在启动 Lab 61: OpenCode 核心架构演练测试...
==================================================
✅ [断言 1 通过] AST 代码符号智能检索与 Token 预算裁剪验证成功!
✅ [断言 2 通过] Plan 模式只读沙盒隔离验证成功(磁盘零污染)!
✅ [断言 3 通过] Build 模式受控状态机驱动落地验证成功!
✅ [断言 4 通过] 沙盒路径穿越(Path Traversal)安全防御验证成功!
✅ [断言 5 通过] 事务异常状态自愈与原子回滚验证成功!
==================================================
🎉 [Lab 61 验证完成] 全部 5 组核心断言 100% 通过!
==================================================
实训体验入口:本练习代码与配套自包含环境已开源同步至 Skillup 边学边练实验库 (Lab 61),欢迎在线免安装实操演练。
6. 总结与未来演进
从 OpenCode 的爆火我们可以清晰地洞察到下一代 AI 编程工具的发展方向:
1. 界面向极简终端收敛,架构向高可用服务端延伸:开发者渴望干净、轻快、无干扰的终端体验,但这背后需要稳定可靠的后台服务与状态记忆机制来支撑;
2. 安全隔离不再是选配,而是生产级落地红线:Plan/Build 双模执行与严格的作用域边界,是保护企业生产代码资产免受 AI 意外损坏的核心防火墙;
3. 精准上下文重于盲目堆叠:通过 AST 语法分析与动态符号提取,以更低 Token 消耗达成更高推理质量,才是终端智能体的未来王道。
如果你正在构建自己的研发智能体或终端自动化工具,OpenCode 的 Client-Server 分层思想与沙盒控制状态机,无疑提供了极佳的工业级范本。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: