一个 ::BARCHART_STACKED 就是一张堆叠柱状图,Shaper 借 DuckDB 把数据看板变成可评审的代码
想给团队搭一个内部数据看板,很多后端开发的路径惊人地一致:用 SQL 客户端查数据,导出 CSV,再导入某个图表工具,配样式、配筛选器。大半个上午过去,得到的是一条脆弱的链路:数据一变就得重来一遍,看板配置也散落在某个工具的数据库里,没人能评审,也没法回滚。
公众号「终码一生」介绍的开源项目 Shaper 换了个思路:既然数据最终都是通过 SQL 取出来的,那为什么不直接用 SQL 定义整个仪表盘?Shaper 官方的一句话介绍是“开源、SQL 驱动、由 DuckDB 提供动力的数据看板”。它可以自行部署,后端用 Go 编写,前端基于 React,一个 Docker 容器就能跑起来。
本文先讲清楚 Shaper 最核心的设计——用类型转换声明图表,再用真实的 DuckDB 写一个迷你渲染器,把这套机制在本地跑一遍。
一、核心设计:类型转换就是渲染指令
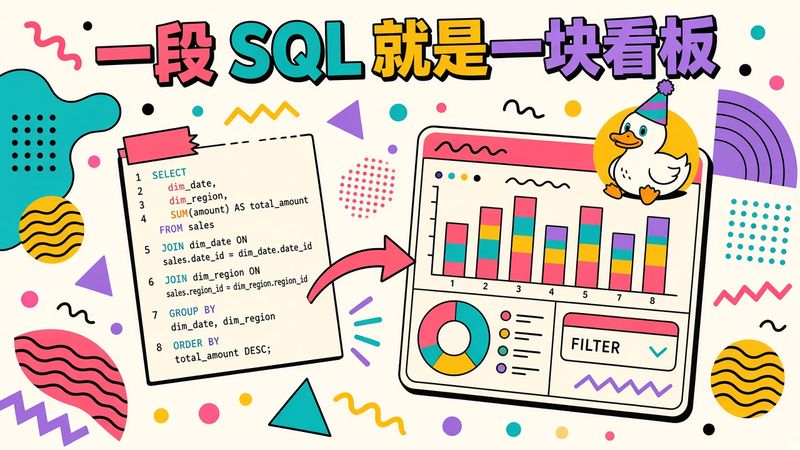
官方文档里的第一个示例是这样的:
SELECT 'Sessions per Week'::LABEL;
SELECT
  date_trunc('week', created_at)::XAXIS,
  category::CATEGORY,
  count()::BARCHART_STACKED,
FROM dataset
GROUP BY ALL ORDER BY ALL;
没有任何拖拽配置,第一条语句给出图表标题,第二条语句里每一列末尾的 ::类型 告诉 Shaper 这一列扮演什么角色:XAXIS 是横轴,CATEGORY 是分组,BARCHART_STACKED 是堆叠柱的数值。Shaper 文档的原话是:它创建了一批自定义 SQL 类型,把数据转换成这些类型,就能以不同方式渲染。
这套“类型即图表”的词汇表覆盖了常见的看板需求:
- 图表:
BARCHART、BARCHART_STACKED、LINECHART、SCATTERPLOT、PIECHART、DONUTCHART,以及BOXPLOT()箱线图、GAUGE仪表盘; - 单值与表格:
PERCENT、COMPARE(与上期对比)、TREND(趋势)、TEXT_SMALL到TEXT_LARGE; - 注解:
XLINE、YLINE在图上画出事件线和参考线,BAND_LOWER、BAND_UPPER画出置信区间带; - 样式:
COLOR直接用一列数据控制颜色。
这种设计的好处是看板逻辑和数据逻辑写在同一个地方。想换图表类型,改一个后缀就行;想加一个维度,加一列。看板本身就是一个纯文本 SQL 文件。
二、交互:筛选器也是一条 SELECT
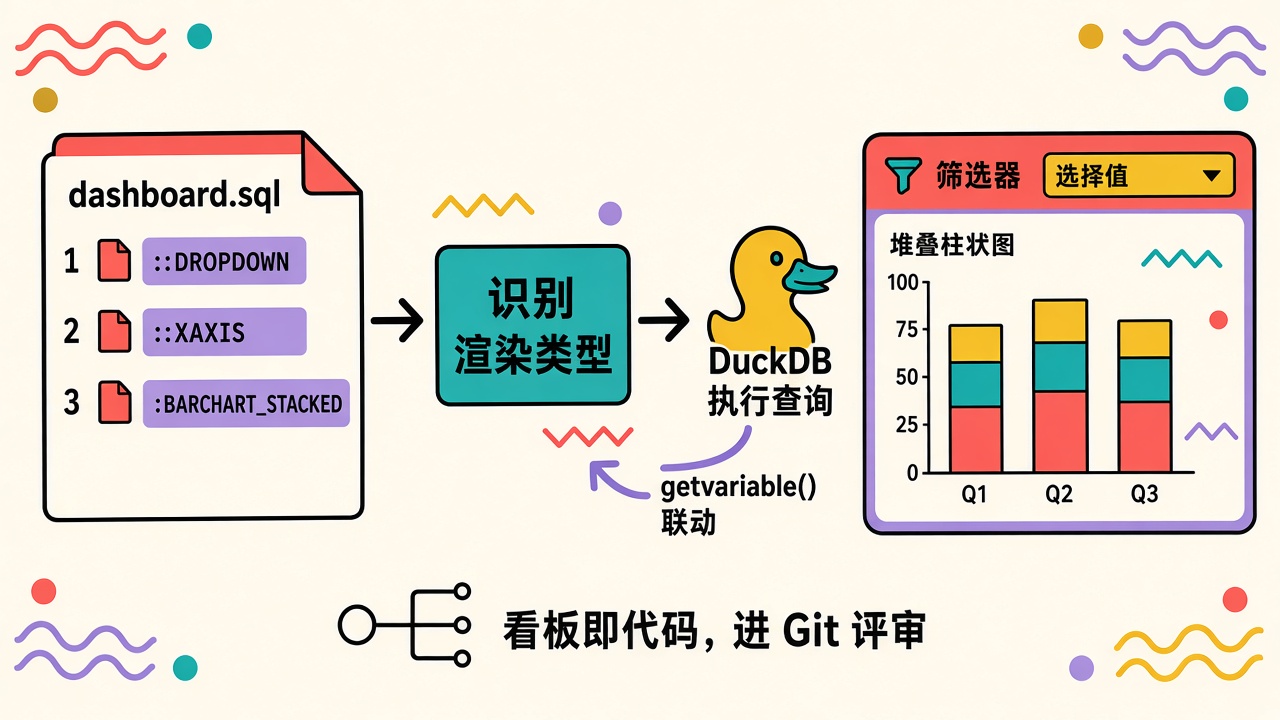
看板的交互同样用 SQL 声明。下拉框是一条返回候选值的查询:
SELECT type::DROPDOWN AS type
FROM my_table
GROUP BY type
ORDER BY type;
用户选中的值会成为一个变量,之后的所有查询都可以通过 DuckDB 内置的 getvariable('type') 引用它。日期选择用 DATEPICKER,日期区间用 DATEPICKER_FROM 和 DATEPICKER_TO,多选用 DROPDOWN_MULTI(得到的是列表,配合 IN getvariable('type') 使用)。文档还特别提醒:下拉框的选项顺序由 ORDER BY 决定,想加一个自定义默认值,就用 UNION ALL 把它作为第一行返回。
筛选器修改变量、变量驱动后续查询,整块看板的联动就这样用纯 SQL 串起来了:
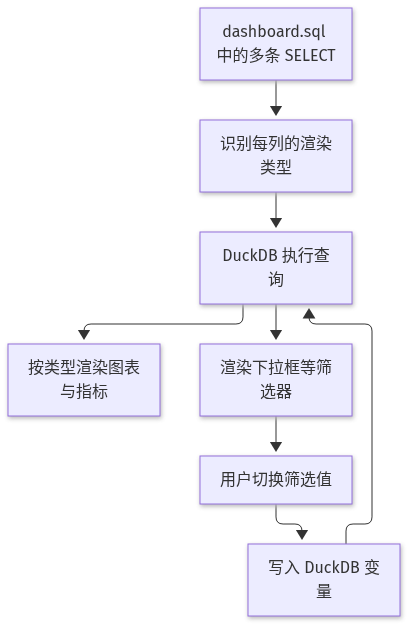
三、DuckDB 带来的数据源和算力
Shaper 选择 DuckDB 作为引擎,直接继承了它的数据接入能力。源文列举了可以直接查询的数据:本地的 CSV、JSON、Parquet、Excel 和文本文件,远程的 HTTP 文件和 Amazon S3,以及 PostgreSQL、SQLite、MySQL 等数据库;借助 DuckDB 的扩展生态,还能进一步连接更多数据源。官方文档的说法是“几乎任何数据源都有对应的 DuckDB 扩展”,可以跨数据源联合查询,还能把中间结果预先计算成临时表。
这带来一个很实际的定位:数据不用先搬家。已有的 Postgres 业务库、S3 上的 Parquet 文件、运营同学维护的 Google Sheets,都可以在一个看板里直接关联查询。数据量和复杂度上去之后,官方也给出了演进路径:定时任务里的 SQL 可以迁移到 dbt 或 SQLMesh,数据也可以直接存进 DuckDB,逐步建设成专门的数仓。
四、嵌入、分享与“BI 即代码”
面向产品集成,Shaper 提供 JavaScript 和 React SDK,可以把看板直接嵌入到自己的应用中,官方特别说明不依赖 iframe;配合按用户生成的 JWT Token,可以限制每个用户能看到的数据范围。
面向数据使用者,看板可以生成带密码保护的分享链接,可以自定义 CSV、Excel、JSON 下载,也可以导出 PDF 报告。
面向运维,Shaper 支持用纯 SQL 定义定时任务,用于定时拉取远程数据、执行 ETL 转换、清理历史数据;还提供实时写入数据的 HTTP 接口,会自动推断数据结构。
最值得后端团队关注的是“BI 即代码”:看板是 SQL 文件,可以用任何编辑器编写,用 Git 做版本控制、走代码评审、接入 CI/CD。官方还提到,可以让你习惯用的 AI 编程助手直接生成看板。SQL 本身就是大模型最擅长写的语言之一,这一点并不意外。
五、部署:一条命令起服务
官方推荐的启动方式是 Docker:
docker run --rm -it -p 5454:5454 -v ./mydata:/data taleshape/shaper
-p 5454:5454 映射 Web 端口,-v ./mydata:/data 把本地目录挂载为数据目录。启动后浏览器访问 http://localhost:5454,点击“+ New”即可开始创建看板。注意示例里的 --rm 只会删除容器,数据保存在挂载的 ./mydata 中;正式部署时去掉 -it,改用 -d 后台运行,并把数据目录纳入备份。
六、动手实验:用真实 DuckDB 复现“类型即图表”
配套脚本 practice/demo_sql_dashboard.py 用约 130 行 Python 实现了一个迷你渲染器(需要先 pip install duckdb)。看板定义沿用 Shaper 的写法,包含一个渠道下拉框、一张按设备堆叠的周会话柱状图和一个转化率指标:
SELECT channel::DROPDOWN AS channel FROM sessions GROUP BY channel ORDER BY channel;

SELECT '每周会话数(按设备)'::LABEL;
SELECT
  date_trunc('week', created_at)::XAXIS,
  device::CATEGORY,
  count()::BARCHART_STACKED,
FROM sessions
WHERE channel = getvariable('channel')
GROUP BY ALL ORDER BY ALL;

SELECT '转化率'::LABEL;
SELECT avg(converted::INT)::PERCENT AS "转化率" FROM sessions WHERE channel = getvariable('channel');
实验中有一个有意思的发现:用 DuckDB 的 CREATE TYPE XAXIS AS VARCHAR 创建类型别名后,查询结果的列类型会被还原成底层的 VARCHAR,类型名不会保留在结果里。所以脚本采用的做法是先从 SQL 文本中识别并剥离渲染类型,再把干净的 SQL 交给 DuckDB 执行:按顶层逗号切分 SELECT 列表(跳过括号和引号内部),识别每一项末尾的 ::类型,记下这一列的角色。converted::INT 这种普通类型转换不在渲染类型表里,会被原样保留。
筛选器的实现完全对应 Shaper 的语义:下拉框查询的第一个值作为默认值,选中值通过 SET VARIABLE 写入 DuckDB,后续查询里的 getvariable('channel') 自然就拿到了它。运行结果:
$ python3 demo_sql_dashboard.py
[0] DuckDB 1.5.6,生成示例表 sessions:240 行
[1] 解析第 3 条语句的渲染角色: ['XAXIS', 'CATEGORY', 'BARCHART_STACKED']
    交给 DuckDB 的 SQL: SELECT date_trunc('week', created_at), device, count() FROM sessions WHERE channel = getvariable('channel') GROUP BY ALL ORDER BY ALL
[2] 默认筛选值渲染:
[筛选 channel] (x) 搜索  ( ) 直接访问  ( ) 社交

== 每周会话数(按设备) ==
  2026-09-07 ######@@@@@@******* 19
  2026-09-14 ####@@@@@****** 15
  2026-09-21 ######@@@********* 18
  2026-09-28 ######@@@* 10
  图例:#=平板  @=手机  *=桌面

== 转化率 ==
  转化率:32.3%

[3] 切换筛选为「社交」后重新渲染:
[筛选 channel] ( ) 搜索  ( ) 直接访问  (x) 社交

== 每周会话数(按设备) ==
  2026-09-07 ######@@@@@@@@@@********* 25
  2026-09-14 #######@@@@@@@@@****** 22
  2026-09-21 ######@@***** 13
  2026-09-28 ########@@@@@@@@@@@@@***** 26
  图例:#=平板  @=手机  *=桌面

== 转化率 ==
  转化率:31.4%

全部校验通过:图表合计 86 与「社交」渠道总行数 86 一致,筛选联动生效
同一份 SQL 文本,只是切换了筛选值,柱状图和指标就跟着变了;脚本最后还校验了图表各柱合计与该渠道的总行数一致。真实的 Shaper 当然要复杂得多(交给浏览器渲染、处理多种图表和权限),但“类型标注决定渲染、变量驱动联动”这两根主干,在几十行代码里就能看得清清楚楚。
七、选型建议与注意事项
适合的场景:
- 团队以工程师为主,大家都会写 SQL,希望看板能走代码评审;
- 需要在自己的产品里嵌入分析功能,并按用户隔离数据;
- 数据分散在数据库、对象存储、表格文件里,不想先建数仓;
- 想要一个轻量的自托管方案,一个容器搞定。
需要权衡的地方:
- 面向业务人员的自助分析:拖拽式探索是 Metabase、Superset 这类工具的强项,纯 SQL 看板对不会写 SQL 的同事有门槛;
- SQL 方言:看板里写的是 DuckDB 方言(如
GROUP BY ALL、date_trunc、getvariable),迁移到其他引擎时需要改写; - 查询性能:直接查询远程数据源很方便,但大表频繁刷新时,建议用定时任务把结果预先计算并落到 DuckDB 中;
- 权限边界:分享链接的密码保护适合临时协作,面向外部用户的嵌入场景一定要用 JWT 做按用户的数据隔离,不要把筛选条件只放在前端。
八、总结
Shaper 的设计很克制:不发明新的配置语言,不做复杂的拖拽编辑器,而是在 SQL 上加一层类型标注,把“查什么”和“怎么画”写在同一行里。再加上 DuckDB 的数据接入能力和单容器部署,它给后端团队提供了一条很短的路径:从一条 SQL 到一个可以分享、可以嵌入、可以进 Git 评审的看板。
开源地址:https://github.com/taleshape-com/shaper
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。