百万行 Trace 交给 AI,方向和验证留给人,一套还原自定义 VMP 保护的分工方法
VMP(Virtual Machine Protection,虚拟机保护)是移动端 native 库保护的主流方案之一:关键算法被编译成自定义字节码,由嵌在 SO 里的解释器逐条执行。逆向者在 IDA 里看到的不再是算法本身,而是一个通用解释器在跑一串看不懂的字节码。传统静态分析在这里几乎失效。
看雪论坛作者「执着的猫」分享了一套 AI 辅助还原 VMP 的方法论,不针对具体目标,只讲为什么这么做、怎么做。本文按这套方法的主线重新梳理,并用一个自建的玩具虚拟机把其中最关键的几步完整跑一遍:opcode 语义推断、循环识别、差分依赖矩阵、查表碰撞求密钥差、独立实现比对。
说明:本文内容仅用于授权的安全测试、自有应用的加固评估、CTF 与教学研究。对他人软件进行逆向,须遵守相关法律法规和软件许可协议。
一、整体流程与人机分工
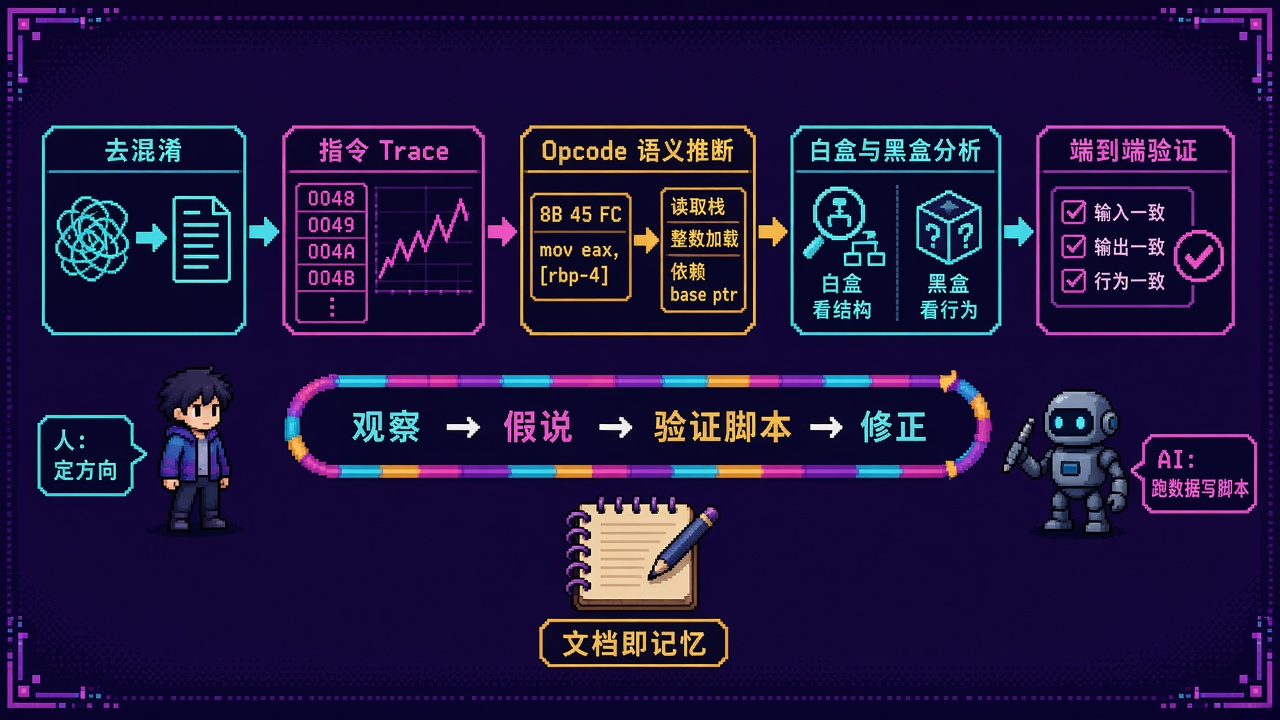
源文给出的完整链路是:SO 去混淆、IDA 批量导出、搭建动态调试环境并采集 Trace、Opcode 分析、字节码提取、黑盒与白盒分析、文档记录、参数还原、端到端验证。
贯穿始终的是一条分工原则:人类决定方向、设计实验、判断关键节点;AI 负责处理海量数据、编写脚本、维护文档。 换句话说,不要问 AI“这个算法是什么”,而要让它“写一个脚本验证这组数据是否符合 AES-128 CBC”。前者会得到一个自信但可能错误的结论,后者会得到一个能被运行和证伪的实验。
二、准备阶段:去混淆与批量导出
去混淆。 VMP 保护的 SO 通常还叠加了控制流平坦化(CFF),IDA 反编译出来是大量 switch-case 分发器,连解释器之外的辅助函数(参数编组、内存分配、类型分发)都读不懂。源文的做法是两条腿走路:用 angr 符号执行识别分发器变量、求解每个基本块的真实后继并 patch 回直接跳转,处理大部分函数;对 angr 失败的函数,在动态环境里实际执行一遍,记录走过的基本块序列,按 trace 直接 patch 条件跳转。AI 在这里的作用是辅助编写和调试 angr 脚本、分析失败案例。
批量导出,而不是交互式查询。 让 AI 通过 MCP 直接查询 IDA 数据库看起来很方便,但混淆后的函数动辄上千行伪代码,交互式看两三个函数就能把上下文窗口塞满。源文的选择是借助开源插件 ida-no-mcp,一次性把所有函数的伪代码、调用关系、交叉引用导出成本地文件,AI 需要哪个读哪个,同一份数据可以反复查阅。
这一点对所有“大代码库 + AI”的场景都适用:把数据预先整理成按需读取的文件,比让 AI 在对话里一点点查询要稳定得多。
三、动态环境:在 PC 上模拟执行 ARM 代码
移动端逆向不像 Web 端那样有现成的开发者工具:代码是 ARM 机器码,还叠加加壳、混淆、反调试,真机调试需要 root 且不稳定。常见的选择有几类:
- Unicorn:纯 CPU 指令模拟,所有系统调用和内存映射都要自己处理;
- unidbg:面向 Android/iOS 的模拟执行框架,内置 JNI 环境、系统调用和文件系统模拟,加载 SO 后可以直接调用 native 函数;
- Qiling:通用系统模拟框架,支持多平台,封装程度介于两者之间;
- Frida:在真机或模拟器上动态注入,环境最真实,但依赖设备。
对 VMP 分析来说,需要的核心能力是五项:可控执行(随时暂停、查看寄存器和内存)、Hook(拦截任意函数并 dump 输入输出)、指令级 Trace、注入(修改输入、覆写内存做差分实验)和确定性重放(固定随机数与时间)。源文以 unidbg 为例,补环境的过程就是“缺什么补什么”:执行到某个 JNI 调用报错就补一个返回值,读某个文件失败就模拟一个,AI 可以帮忙查常见 Android API 的返回值格式。
对解释器区域开启指令 trace 后,往往会得到百万行级别的记录,人工根本看不过来。但统计热点地址、识别重复出现的地址模式、提取特征函数的调用次数和参数,恰好是 AI 加脚本最擅长的事。
四、Opcode 语义推断:第一直觉经常是错的
所有字节码虚拟机的核心都是一个取指、译码、执行的循环。在分发器处下断点,就能建立 ARM 寄存器与虚拟机角色(字节码 PC、求值栈指针、当前 opcode)之间的映射。
接下来是推断每个 opcode 的语义。核心方法是在分发器断点处 dump 求值栈,对比每条字节码执行前后的栈变化。比如执行前栈顶是 0x02, 0x05,执行后变成 0x14,2 << 5 和 5 << 2 中只有后者等于 0x14,于是推测它是左移,且操作数顺序是“栈顶为位移量”。
源文特别强调:单组数据很容易误判。 他遇到过一个看起来像 XOR 的 opcode,实际是 ADD,因为在某些特定数值下两者的结果恰好相同。解决办法是对同一个 opcode 收集大量样本,把每个样本的候选运算集合求交集。
这种“候选集求交集”的做法,就是让 AI 去穷举所有可能的运算,再用大量数据交叉验证。
五、控制流与字节码:从回跳中读出密码学参数
循环是虚拟机里最关键的控制流结构。统计字节码 PC 的向后跳转(backjump),就能识别循环的嵌套结构和迭代次数。
源文举了一个很漂亮的例子:某个三层嵌套循环的迭代次数是 3 × 9 × 4 = 108,每次迭代做 16 次 GF(2^8) 乘法,总计 1728 次。这强烈暗示了 AES-128:3 个数据块、9 轮带 MixColumns 的常规轮(最后一轮不含 MixColumns)、每轮 4 列。迭代次数本身就是密码学参数的指纹。
有了 opcode 语义表,接下来通过 Hook 在虚拟机执行前 dump 两类数据:完整的字节码段,以及包含查找表、常量的虚拟机数据内存。编写反汇编器是机械性工作,可以交给 AI 生成,关键是处理好变长指令和操作数解析。反汇编结果能显示函数边界、循环骨架、查表模式和外部调用的分布,这是后续白盒分析的起点。
六、白盒分析:从查找表里把密钥“碰”出来
白盒分析的核心是在字节码和 trace 中识别已知的密码学原语。常见特征包括:
- GF(2^8) 乘法:循环 8 次,归约常量
0x1B,这是 AES 的标志; - S-box 查表:一张 256 字节的置换表;
- MixColumns 系数:
{2, 3, 1, 1}的循环模式; - CRC32 查表:1024 字节(256 × 4),多项式
0xEDB88320。
白盒密码的典型手法是把密钥融合进查找表:标准实现里的 SBOX[x ^ key] 被预先算成一张新表,代码里再也找不到显式的密钥。
还原它的方法叫碰撞验证:如果两张表来自同一个 S-box,只是融合的密钥不同,那么一定存在一个常量 delta,使得对所有 x 都有 T1[x] == T2[x ^ delta],而这个 delta 就是两个密钥的差值。
def find_key_delta(table1, table2):
    for delta in range(256):
        if all(table1[x] == table2[x ^ delta] for x in range(256)):
            return delta
    return None
把大量查表两两碰撞,就能还原出全部轮密钥之间的关系,而不必逆向密钥调度算法。
这一阶段的工作模式是一个循环:
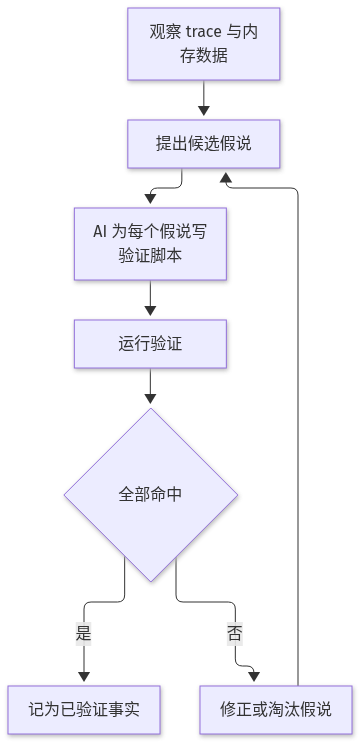
AI 的价值在于加速这个循环:一次生成十几个候选假说,各自配上独立的验证脚本。源文的说法是,一轮下来几分钟,人工可能要一整天。
七、黑盒差分:读不懂字节码时,只看输入输出
有些情况下白盒分析代价太高:字节码混淆严重、虚拟机存在寄存器与内存别名这类特殊机制,或者只是想快速确认某个子模块的行为。这时就切换到黑盒视角,只观察输入输出关系。
核心是差分探针:固定其他输入,只改变一个单位,观察输出的变化。源文推荐分层进行:先用 dword 粒度粗略定位哪些输入影响哪些输出区域,再精确到单字节,最后用 nibble(半字节)粒度区分高低 4 位是否独立,这是发现半字节级操作的关键。
把所有探针结果汇总成依赖矩阵,就能直接推断算法结构:某个输入字节影响全部输出,说明它参与了全局混合;只影响对应位置的输出,说明是逐字节变换(XOR、查表、置换)。对未知子函数,再枚举候选算法(CRC32、XOR 折叠、S-box 变换等),用多组探针数据逐一筛选,只有全部命中的才是正确答案。
八、动手实验:在自建玩具虚拟机上走一遍
配套脚本 practice/demo_toy_vm_analysis.py 只依赖 Python 标准库,分为“保护方”和“分析方”两部分。
保护方构造了一个栈式虚拟机:12 条指令,opcode 编号随机打乱;被保护的算法是“对 8 个输入字节交替用两张查找表变换,再计算一个 4 字节的滚动哈希”;两张表由同一个 S-box 分别融合两个密钥得到,代码里不出现显式密钥。
分析方只能做三件事:拿到执行 trace、dump 虚拟机数据内存、把整个函数当黑盒调用。运行结果如下:
$ python3 demo_toy_vm_analysis.py
[0] 字节码 15 字节:ac 00 ae 85 41 a3 ac 01 c4 ae ac 08 af 02 c6
[1] 指令级 trace 共 73 条,按 opcode 统计热点:
    0xac×17, 0xae×16, 0x85×8, 0x41×8, 0xa3×8, 0xc4×8, 0xaf×8
[2] 二元运算 opcode 语义推断(单样本可能有歧义,多样本求交集)
    0xa3 首个样本 [0, 139]→0 符合 ['AND', 'LSL', 'LSR', 'MUL']
         8 个样本求交集为空 → 不是纯运算,疑似带副作用的写内存指令(真实为 STORE)
    0xc4 首个样本 [0, 1]→1 符合 ['ADD', 'OR', 'XOR']
         8 个样本求交集 → ['ADD'](真实为 ADD)
[3] 回跳检测:7 次,从 pc=12 跳回 pc=2 → 单层循环,迭代 8 次
[4] 只用探针值 0x01:哈希区有 1 个格子显示“不受影响”,单组数据容易误判
    改用 4 个探针值取并集后的依赖矩阵(行=输入字节,列=输出字节,# 表示受影响):
    in[0] #.......####
    in[1] .#......####
    in[2] ..#.....####
    in[3] ...#....####
    in[4] ....#...####
    in[5] .....#..####
    in[6] ......#.####
    in[7] .......#####
    前 8 字节逐字节对应=True;末 4 字节受全部输入影响=True → 逐字节查表 + 全局哈希
[5] 从 VM 数据内存 dump 两张 256 字节表,碰撞得到密钥差 delta=0x99(真实 K1^K2=0x99)
[6] 独立 Python 实现与 VM 黑盒比对:500/500 一致
全部校验通过
这份输出里有三处正好对应源文反复强调的“只信事实,不信结论”:
- 第 2 步:
0xc4的第一个样本0 和 1 得到 1,同时符合 ADD、OR、XOR,只看这一组数据就是在猜;8 个样本求交集后才唯一确定为 ADD。0xa3的栈形状看起来像二元运算,但交集为空,说明它根本不是纯运算,而是一条有副作用的写内存指令; - 第 3 步:7 次回跳意味着循环体执行了 8 次,与输入长度一致;
- 第 4 步:只用
0x01一个探针值时,最后一个输入字节恰好“没有影响”哈希的某个字节,如果据此下结论就会把算法结构判断错;换用 4 个探针值取并集后,矩阵结构才清晰呈现出“前 8 字节逐字节查表、后 4 字节全局哈希”。
最后两步对应白盒和端到端验证:查表碰撞求出的密钥差与真实值一致,按推断结果独立实现的 Python 版本在 500 组随机输入上与虚拟机输出完全一致。
九、端到端验证与勘误:为什么一定会犯错
真实目标中通常有随机数参与(时间种子、/dev/urandom 等),做端到端验证前必须先 Hook 这些熵源让它们返回固定值。固定熵源后,相同输入必须产生完全相同的输出,任何不一致都说明还原有误。然后把全部算法用纯 Python 独立实现,与模拟执行框架的输出逐步比对,出现不一致时就能定位到具体的子步骤。
源文总结了四类必然会遇到的错误:
- 混淆因果:把动态参数当成固定常量,多次运行对比后才发现每次都不同;
- 过度泛化:观察到一种映射关系就当成全局规则,换一批数据就不匹配;
- 误判结构:把 N 轮独立加密误认为 M × K 轮 CBC,对中间块交叉验证时失败;
- AI 幻觉:AI 自信地推断出一个并不存在的模式,写出验证脚本一跑就被证伪。
十、文档即记忆:让多周的分析可以接力
VMP 还原往往持续好几周。AI 没有跨会话的记忆,人的记忆同样靠不住:上次分析到哪了、某个假说已验证还是已证伪、某组实验数据代表什么,很快就会忘。源文建议的组织方式是:
项目根目录/
├── CLAUDE.md      # 项目级指令:工作流规则、分析原则、禁止事项
├── docs/          # 分析文档:ANALYSIS.md 记总体进度,每个模块一份,archive/ 保留已证伪的假说
├── IDA 导出/      # 结构化伪代码
├── trace/         # 运行时数据
└── scripts/       # 验证脚本
每份文档都把信息分成三类:已验证事实(有 Hook 数据、trace 数据或 Python 验证通过作为支撑)、待验证假设、已证伪假说(保留记录,避免重复踩坑)。项目级指令文件里写清分析原则,比如“生成的脚本由用户自己运行”“遇到大函数立刻停下”,每次对话都会自动加载。
十一、总结
源文对 AI 能力边界的总结很清醒:AI 擅长海量数据处理、模式识别、批量生成代码、穷举假说和维护文档;不擅长大函数去混淆、创造性的关键突破,也不擅长自我纠错,上下文过长时还会遗忘早期的结论。
所以这套方法真正的核心不是“用 AI 逆向”,而是三条纪律:让 AI 写验证代码而不是直接给结论;每次只攻克一个子问题,验证通过再往前推;所有发现写进文档,下次会话从文档继续。这三条放在任何复杂的分析工作里同样成立。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。