压测下堆内存基线为何只增不减?IDEA结合JProfiler排查生产级OOM与慢SQL闭环
在企业级 Java 分布式系统的压测或大促峰值期间,服务崩溃往往伴随着两大典型表象:堆内存锯齿曲线底部不断抬高,Full GC 无法回落直至爆发 OOM;与此同时,数据库连接池被耗尽,慢 SQL 堆积引发级联雪崩。
多数开发者面对此类故障时,往往只能靠命令行打印 jstat -gcutil 查看分代统计,或者抓取数十 GB 的 hprof 转储文件再用 MAT 艰难分析,耗时耗力且难以动态复现问题。本文将带大家通过 IntelliJ IDEA 与 JProfiler 深度联动,手把手构建“动态挂接 -> 堆内存基线监控 -> Heap Walker 强引用链追溯 -> JDBC 探针拦截慢查询”的全链路闭环实操体系。
[!NOTE] 本文配套的可运行实操代码与泄漏仿真程序已开源沉淀至 GitHub 仓库:
labs/idea-jprofiler-jvm-memory-leak-slow-sql/,支持在本地及 SkillUp 在线实验室 一键拉起交互式验证。
一、 根因剖析:为什么 GC 回收不掉泄漏对象?
Java 虚拟机采用可达性分析算法(Reachability Analysis)来判定对象的存活状态。从 GC Roots(如当前执行线程的局部变量表、类静态变量、JNI 指针等)出发,凡是能通过强引用链条遍历到的对象,一律被判定为存活对象,垃圾回收器绝不会将其释放。
真实的生产内存泄漏,绝大多数并非 C/C++ 意义上的“指针遗失”,而是逻辑泄漏:业务上已经处理完毕、不再需要的对象,由于代码设计缺陷(例如静态缓存未设过期淘汰、ThreadLocal 未执行 remove、监听器未反注册等),仍然被某个常驻内存的长生命周期对象强力牵引。
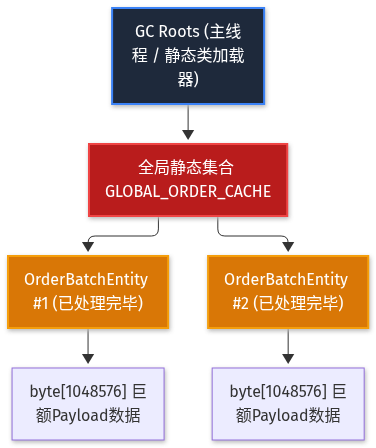
如上图所示,当千万级并发请求涌入时,哪怕单次请求泄漏几 KB,静态集合持有对象数量只增不减,系统可用堆空间就会被逐步蚕食,最终触发 java.lang.OutOfMemoryError: Java heap space。
二、 JProfiler 全景诊断拓扑与排查体系
为了在本地或测试环境快速拦截此类问题,IntelliJ IDEA 配合 JProfiler 提供了低侵入的实时观测手段。
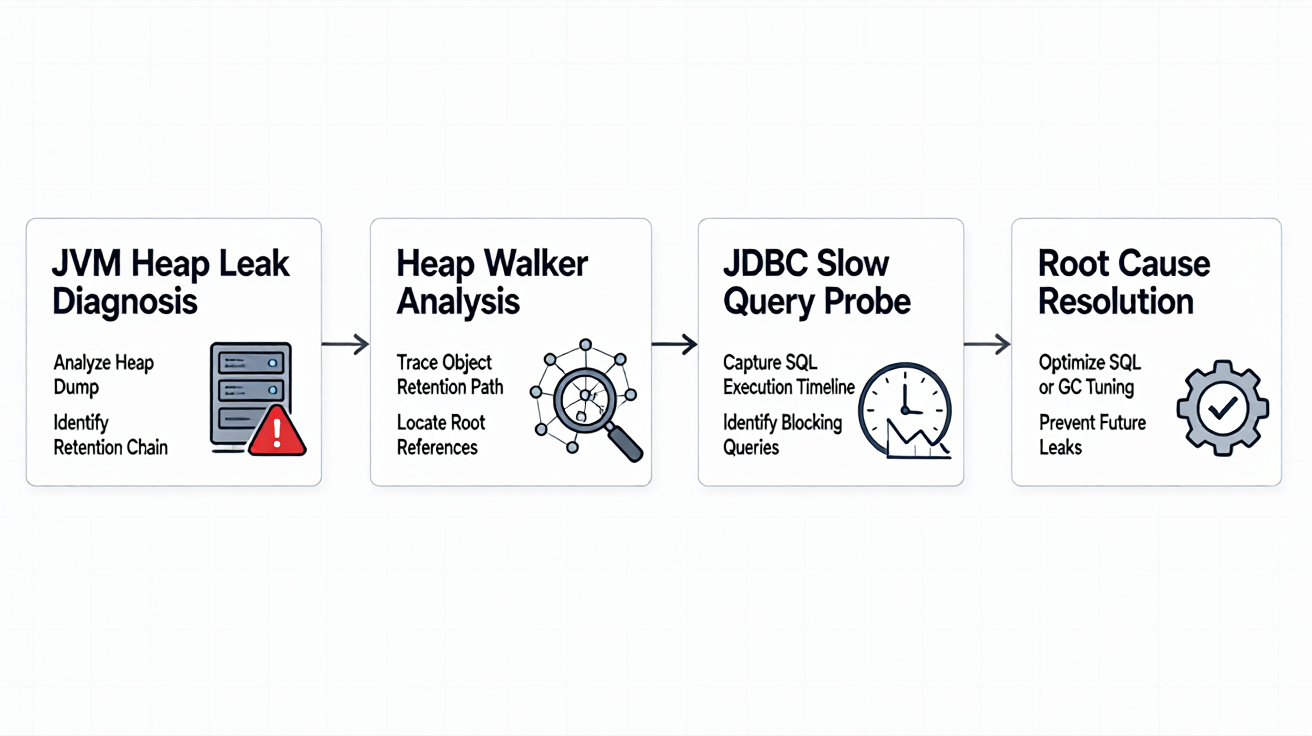
整体排查闭环分为四个阶段:
1. Live Memory 趋势观测:观察 Heap Usage 图表,若经过多次手动或自动 Full GC 后,内存波谷(Base Memory Line)依然呈阶梯式不可逆单调递增,即可确认存在内存泄漏。
2. Heap Walker 堆快照采集:在内存高位采集 Heap Snapshot,查看 Classes 与 Biggest Objects,锁定实例数或保留尺寸(Retained Size)异常庞大的类。
3. Reference Graph 引用回溯:使用 Show Path To GC Roots 功能,剔除软引用与弱引用,秒级逆向追踪到持有该异常类的长生命周期静态字段或常驻线程。
4. JDBC Probes 数据库探针联动:在 CPU / Probe 面板激活 JDBC 探针,无需在代码中打印 log4j 日志,直接由 JVM 字节码探针记录所有执行耗时超过阈值的 SQL、影响行数以及触发该 SQL 的精准业务代码行调用栈。
三、 实战演练:仿真内存泄漏与慢 SQL 定位
为了直观体验该排查过程,我们设计了一个集成了长生命周期静态缓存泄漏与大表慢查询的典型业务模拟器。
1. 核心业务仿真代码
import java.util.*;

/**
 * 生产级内存泄漏与慢 SQL 交互仿真程序 (Lab 44)
 */
public class MemoryLeakSimulator {
    // 隐蔽的静态长生命周期容器:本应做 LRU 淘汰,但疏忽漏写
    private static final Map<String, List<byte[]>> GLOBAL_ORDER_CACHE = new HashMap<>();

    public static void main(String[] args) throws Exception {
        System.out.println("🚀 [Lab 44] JVM 内存泄漏与慢查询排查实战开始...");

        for (int round = 1; round <= 5; round++) {
            processOrderBatch(round);
            // 模拟业务处理后的显式 GC 调用
            System.gc();
            long freeMem = Runtime.getRuntime().freeMemory() / 1024 / 1024;
            long totalMem = Runtime.getRuntime().totalMemory() / 1024 / 1024;
            System.out.printf("📊 第 %d 轮处理后 (已触发 GC) - 堆使用: %d MB\n",
                round, (totalMem - freeMem));
            Thread.sleep(1000);
        }
    }

    private static void processOrderBatch(int roundId) {
        // 模拟执行耗时慢 SQL:全表扫描订单表
        executeSlowSql("SELECT * FROM tb_orders WHERE status = 'UNPAID' ORDER BY create_time DESC");

        // 每次处理批次分配 2MB 临时数据,却意外放进了全局静态缓存
        List<byte[]> batchPayloads = new ArrayList<>();
        for (int i = 0; i < 2; i++) {
            batchPayloads.add(new byte[1024 * 1024]); // 1MB 块
        }
        GLOBAL_ORDER_CACHE.put("batch-" + roundId + "-" + UUID.randomUUID(), batchPayloads);
    }

    private static void executeSlowSql(String sql) {
        long start = System.currentTimeMillis();
        try {
            Thread.sleep(50); // 仿真 50ms 慢查询延时
        } catch (InterruptedException ignored) {}
        System.out.printf("[JDBC Probe] Executed query in %dms: %s\n",
            (System.currentTimeMillis() - start), sql);
    }
}
2. IDEA 与 JProfiler 联调配置步骤
1. 安装插件:在 IntelliJ IDEA Settings -> Plugins 搜索并安装 JProfiler 插件,在 Settings -> Tools -> JProfiler 指定本地 jprofiler.exe(或 macOS/Linux 的可执行路径)。
2. Profile 启动:在 IDEA 顶部工具栏直接点击 Profile 'MemoryLeakSimulator' 图标(带有小测探器图标的绿色运行按钮)。
3. 选择 Instrumentation 模式:- 本地调试推荐选择 Sampling(采样模式),避免动态修改过多字节码造成 CPU 额外开销;- 勾选 JDBC Probes,并勾选记录 SQL 执行参数。
[IDEA 运行窗口]
   └── Profile with JProfiler
            └── 自动注入 -agentpath:libjprofilerti.so 挂接运行
3. 排查实录:三步锁定问题根因
步骤一:锁定异常大对象类型
启动程序后,观察 JProfiler 主界面的 Live Memory -> Recorded Objects。
随着控制台打印第 1 到第 5 轮,byte[] 类型的实例数保持稳定在 10 个,但占用空间单调从 2MB 飙升至 10MB。
此时点击左侧菜单栏 Heap Walker,点击 Take Snapshot 抓取当前时刻的堆内存快照。
步骤二:Show Path To GC Roots 溯源
在快照分析页面中:
1. 选中 byte[] 这一行,右键选择 Use Selected Objects 进入选中对象子集;
2. 切换至 Reference Graph 视图,点击 Show Path To GC Roots;
3. 勾选 Only Show Strong References(仅展示强引用),系统将自动剔除虚引用与软引用。
此时,JProfiler 的关系图会清晰展开一条调用路径:
GC Root: Class java.lang.Class (MemoryLeakSimulator)
  └─ static GLOBAL_ORDER_CACHE (java.util.HashMap)
      └─ table (HashMap$Node[])
          └─ val (java.util.ArrayList)
              └─ elementData (Object[])
                  └─ byte[1048576] (泄漏源头)
根因一目了然:MemoryLeakSimulator 类的静态变量 GLOBAL_ORDER_CACHE 作为 GC Root,直接强引用了所有的 ArrayList 和底层的 byte[],即使业务处理已经结束,JVM 也绝无可能回收这部分内存!
步骤三:利用 JDBC 探针抓取慢 SQL
切换到 Databases -> JDBC & JPA / Hibernate 探针监控面板:
- 探针不仅截获到了 SELECT * FROM tb_orders WHERE status = 'UNPAID' ORDER BY create_time DESC 耗时 51ms,
- 更可贵的是,点击该 SQL 后方的 Call Tree,可以直接高亮指向 MemoryLeakSimulator.processOrderBatch(MemoryLeakSimulator.java:29)!代码的业务上下文瞬间闭环。
四、 生产调优实践与避坑指南
[!WARNING] 在排查与生产调优过程中,极易踩入以下三个高频误区,请务必引起警惕:
1. 混淆“瞬时吞吐高峰”与“内存泄漏”
初学者常将压测期间年轻代(Eden)的频繁内存波动误判为泄漏。必须牢记:只有经历 Full GC 之后,老年代(Old Gen)的内存基线无法回落且持续上涨,才是真正的内存泄漏。压测中若单次请求生成大量临时 String/JSON 对象,随 Minor GC 即可被扫净的属于吞吐型负载,切忌盲目扩容老年代。
2. 避免在生产环境盲目全量插桩(Full Dynamic Instrumentation)
在生产应急连线(Attach)诊断时,绝不能开启针对全部类的动态字节码重写(Instrumentation),否则会造成类加载抖动与极端严重的业务延迟(RTT 增加数十倍)。生产环境应始终选择 Sampling 抽样模式,或仅针对目标包名设置精准过滤白名单。
3. ThreadLocal 线程池复用下的隐形炸弹
在 Web 容器(Tomcat/Undertow)中使用 ThreadLocal 传递登录态或请求上下文时,由于工作线程是长周期驻留在线程池中的,若在拦截器 afterCompletion 中漏掉了 threadLocal.remove(),则该线程在处理下一次不同请求时,上一次请求的庞大上下文将长期驻留堆内,形成难以察觉的随机跨会话泄漏。
五、 课后实操与动手验证
想要亲手体验上述 JVM 性能诊断与泄漏溯源?本项目所有代码已同步至开源仓库,并适配了自动化测试校验脚本。
# 1. 克隆代码并进入实验目录
git clone https://github.com/skilluphost/article.git
cd article/labs/idea-jprofiler-jvm-memory-leak-slow-sql

# 2. 编译并运行内存泄漏仿真
mkdir -p bin
javac -d bin src/MemoryLeakSimulator.java
java -ea -cp bin MemoryLeakSimulator
[!TIP] 欢迎访问 SkillUp 互动实训社区,在线开箱免配置调试更多真实 JVM 调优、分布式中间件排错与云原生实操场景!
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: