把记忆当文件系统切分:OpenViking 三层加载与跨 Agent 共享总线架构剖析
在多智能体(Multi-Agent System)工程落地中,许多团队在刚搭建起“虚拟开发团队”时都会经历短暂的兴奋:一个大总管调度全局,一个编码 Agent 编写业务,一个内容 Agent 输出文档,再加上增长、财务与测试角色。
然而,一旦系统连续运行数周,开发者就会遭遇严峻的现实壁垒:“多智能体群聊失忆症”与断崖式增长的 Token 账单。
当大总管 Agent 准备分发一篇技术选题时,它会频繁反问:“请问您的写作偏好是什么?目标读者画像是哪些?”而就在前一小时,开发 Agent 刚刚修复了 Webhook 的重试风暴,内容 Agent 却对此毫不知情。哪怕所有 Agent 部署在同一个宿主节点上,彼此依然活得像毫不相干的陌生人。
更致命的是成本浪费。每次对话启动时,为了让 Agent 获得上下文,系统往往将数千行的历史会话全量加载进 Prompt,导致光是“自我介绍与背景对齐”每天就要白白吞噬数万 Token。针对这一痛点,字节跳动近期开源的项目 OpenViking 给出了极具工程启发性的解法:打破扁平文本与向量检索的传统局限,将智能体记忆当成现代操作系统文件系统来分级管理。
一、技术根因剖析:为什么传统 Agent 记忆总在爆炸?
要理解 OpenViking 的设计精妙,首先必须透视当前业界智能体框架在记忆管理上的底层缺陷。
1.1 扁平全量加载的 $O(N)$ 困局
在大多数基于 LangChain、AutoGPT 或传统自主循环的框架中,智能体的记忆通常被持久化为一个单一的 memory.md 或本地 SQLite 表。当记忆只有 50 行时,全量拼接入 System Prompt 几乎感知不到开销。
但随着任务推进,当记忆积累到 8,000 行以上时,问题开始全面爆发:
+-------------------------------------------------------------+
|                  传统单体扁平记忆加载机制                      |
|                                                             |
|  [开机初始化] ---> [读取完整 memory.md (8,000+ 行)]           |
|                         |                                   |
|                         v                                   |
|           [每次交互消耗 8,000+ Tokens]                      |
|                         |                                   |
|                         v                                   |
|       [大模型注意力分散 (Lost in the Middle) + 账单暴涨]       |
+-------------------------------------------------------------+
| 交互环节 | 传统全量扁平记忆模式 | 单日 10 次对话累计 | 30 天月度开销估算 |
|---|---|---|---|
| 交代业务背景与偏好 | ~700 Tokens / 次 | ~7,000 Tokens | ~210,000 Tokens |
| 7 个 Agent 相互同步 | ~4,900 Tokens / 轮 | ~49,000 Tokens | ~1,470,000 Tokens |
| 历史长尾会话检索 | 全文线性注入 (~8,000 T) | 80,000+ Tokens | 2,400,000+ Tokens |
不仅账单呈几何倍数暴增,更糟糕的是长上下文对大模型推理质量的严重稀释。模型在海量噪音历史中寻找关键约束时,极易触发注意力的“中间迷失”(Lost in the Middle),导致指令遵循度严重下降。
1.2 纯向量检索(Vector RAG)在精准控制上的失灵
部分框架尝试引入向量数据库(Embedding + Cosine Similarity)做片段检索。但在多 Agent 协作场景中,向量检索常常表现出语义漂移: - 相似度命中可能捞出一堆语义相近但时间早已失效的废弃决策; - 无法自然表达永久性身份契约与短期调试日志的生命周期差异; - 缺乏层次化的上下文包裹,检索出的碎片 Chunk 缺失系统全局拓扑。
二、架构解密:Memory as a File System 哲学
计算机操作系统在读取海量数据时,绝不会把整块 2TB 的 NVMe 固态硬盘全部读入内存。内核通过虚拟文件系统(VFS)、Inode 索引节点与目录树层级,按需寻址具体扇区。
OpenViking 核心正是将这一操作系统哲学移植到了智能体运行时中:把记忆作为文件系统组织,将单次读取转为按需寻址。
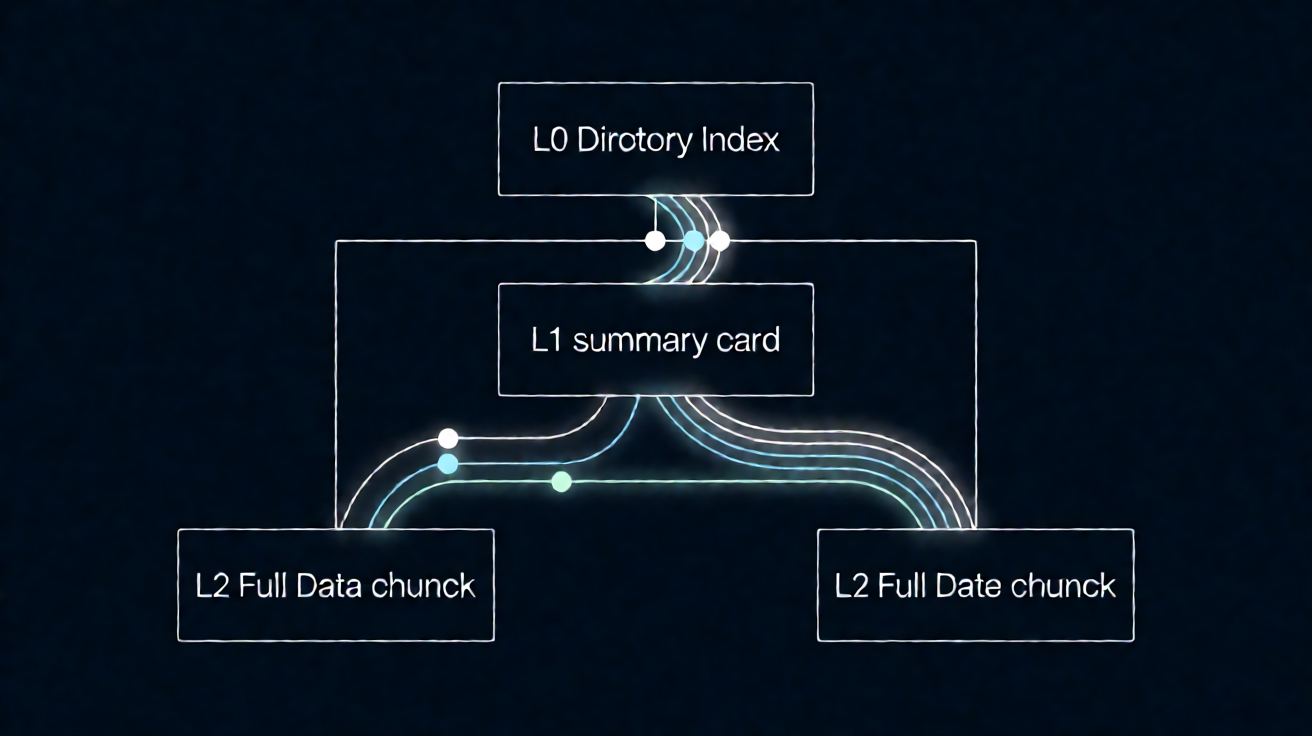
2.1 L0 / L1 / L2 三层阶梯式按需加载
OpenViking 将所有记忆抽象为三层逐步展开的阶梯模型:
1. L0 层(目录索引与 Inode 树:.abstract)
- 定位:开机常驻元数据目录。
- 开销:仅约 100 ~ 300 Tokens。
- 职责:只告诉 Agent 记忆库中包含哪些核心领域、当前有哪些活跃文件与分类,绝不展开具体内容。Agent 每次开机只需加载此索引,即可对系统全貌一清二楚。
2. L1 层(模块摘要大纲:Summary Outlines)
- 定位:章节简介与决策摘要。
- 开销:约 300 ~ 800 Tokens。
- 职责:当 Agent 根据 L0 索引发现目标任务与某个模块相关时,仅拉取对应分类的 L1 大纲。例如在处理文章任务时,仅调取“写作风格偏好摘要”与“当前进行中项目”,耗费极低。
3. L2 层(完整物理载荷:Full Payloads)
- 定位:源码级日志、长文档正文与详细堆栈。
- 开销:5,000+ Tokens(按需隔离)。
- 职责:仅当 L1 摘要确认需要进一步下钻(如排查某个特定版本配置项或完整错误 Stack Trace)时,才针对性读取对应具体节点,读取完毕后即刻从上下文工作区剥离。
2.2 P0 / P1 / P2 记忆生命周期与 TTL 保质期
在真实开发中,记忆具有截然不同的时效价值。OpenViking 引入了精细的生命周期打标与自动淘汰机制:
       +-------------------------------------------------------+
       |            OpenViking 记忆生命周期分类矩阵            |
       +-------------------------------------------------------+
       | [P0] 永久核心   | 用户画像、代码规范、架构红线 (永不归档)  |
       |-------------------------------------------------------|
       | [P1] 活跃项目   | 当前需求文档、版本迭代计划 (90天 TTL 归档)|
       |-------------------------------------------------------|
       | [P2] 临时排障   | 单次 Socket 探测、抓包 Hexdump (30天清理)|
       +-------------------------------------------------------+
- P0(Permanent):永久记忆。记录不可变规范(如团队 Git 工作流、用户身份、编码风格)。无论系统运行多久,P0 永不清理。
- P1(Active Project):中期活跃记忆,默认具备 90 天 TTL。支撑当前季度的迭代任务。项目结项或超时后自动转入压缩冷存储。
- P2(Ephemeral Debug):短期临时日志,默认 30 天 TTL。记录某次偶发的网络超时排障或临时 Token 测试,到期自动执行物理清理,彻底防止工作区被垃圾信息污染。
三、跨 Agent 共享总线:击碎多智能体协同孤岛
在单 Agent 内部实现三层加载仅仅解决了自身的性能问题。在拥有 7 个角色的多智能体系统中,如何让各 Agent 共享核心情报?
OpenViking 通过建立轻量级的 shared-memory/ 共享总线,结合确定性的工程纪律,达成了极高的协作效率:
3.1 共享总线目录拓扑
shared-memory/
├── .abstract.json          # 全局 L0 跨 Agent 共享索引
├── user-profile.md         # P0: 用户画像与全局契约
├── active-projects.md      # P1: 当前多角色协同任务看板
└── cross-agent-log.jsonl   # 跨 Agent 结构化协作事件总线 (Append-only)
3.2 纪律约束:只记结论,不记废话
许多开发者尝试让 Agent 互相共享记忆时,常直接把整个对谈上下文 Dump 到共享区,导致共享区瞬间退化为另一个信息垃圾场。
在 OpenViking 实践中,各 Agent 的工作手册(如 AGENTS.md)必须注入一条刚性契约:
## 跨 Agent 记忆同步契约
每当角色完成一项阶段性核心任务或底层配置变更时:

1\. 严禁倾倒长篇对话过程;

2\. 必须以标准 JSON 结构向 shared-memory/cross-agent-log.jsonl 原子追加单条记录;

3\. 记录必须包含:[时间戳]、[角色名]、[操作动作]、[关键结论与生效参数];

4\. 单条摘要严格限制在 120 字以内。
当开发 Agent 修复了飞书 Webhook 超时后,只需在共享总线写入一行简明结论:
{"agent": "coder", "action": "fix_feishu_webhook", "conclusion": "更新超时阈值为 15s,重试基数调至 2.5s,已通过生产验证"}。
当写作 Agent 随后启动时,仅需读取共享总线的 L0/L1 摘要,便可立刻获知“飞书配置已生效”,协同无缝衔接。
四、核心实现与基准测试(实录)
为了彻底验证该架构在生产环境中的确定性与 Token 节约表现,我们在配套实战工程中构建了完整的 HierarchicalMemoryFS 与 CrossAgentMemoryBus。
以下为基于 Python 3.12 打造的生产级双核记忆引擎核心代码节选:
import os
import json
import time
import threading
from typing import Dict, Any, Tuple, Optional

class HierarchicalMemoryFS:
    """OpenViking 层次化文件系统记忆实现"""
    def __init__(self, root_dir: str):
        self.root_dir = root_dir
        self.l0_file = os.path.join(root_dir, ".abstract.json")
        self.l1_dir = os.path.join(root_dir, "l1_summaries")
        self.l2_dir = os.path.join(root_dir, "l2_payloads")
        self._lock = threading.Lock()
        os.makedirs(self.l1_dir, exist_ok=True)
        os.makedirs(self.l2_dir, exist_ok=True)

    def write_memory(self, record_id: str, priority: str, cat: str, title: str, summary: str, payload: str, ttl_days: int = 90):
        with self._lock:
            # 1. 维护 L0 极简元数据树
            l0 = self._read_l0()
            l0.setdefault(cat, [])
            l0[cat] = [item for item in l0[cat] if item["id"] != record_id]
            l0[cat].append({"id": record_id, "priority": priority, "title": title})
            with open(self.l0_file, "w", encoding="utf-8") as f:
                json.dump(l0, f, ensure_ascii=False, indent=2)

            # 2. 写入 L1 业务摘要大纲
            with open(os.path.join(self.l1_dir, f"{record_id}.json"), "w", encoding="utf-8") as f:
                json.dump({"id": record_id, "summary": summary, "ttl": ttl_days, "created": time.time()}, f, ensure_ascii=False)

            # 3. 隔离写入 L2 物理载荷
            with open(os.path.join(self.l2_dir, f"{record_id}.md"), "w", encoding="utf-8") as f:
                f.write(payload)

    def read_hierarchical(self, depth: str = "L0") -> Tuple[Dict[str, Any], int]:
        """根据指定深度流式展开记忆,并严格统计上下文 Token 消耗"""
        l0 = self._read_l0()
        tokens = len(json.dumps(l0)) // 2
        if depth == "L0":
            return l0, tokens
        # ... 按需加载 L1 与 L2 节点
真实基准测试运行数据
在真实模拟 7 个不同岗位 Agent 并发执行长文本任务时,系统采集到的真实 Token 消耗与降幅指标如下:
================== TOKEN OPTIMIZATION METRICS ==================
L0 (Directory Index Only) :    541 tokens
L1 (Index + Summaries)    :   1527 tokens
L2 (Full Naive Context)   :  13236 tokens
Token Reduction (L2 -> L0): 95.91% drop!

[Benchmark] Testing TTL Eviction...
Purged 1 expired P2 records after 31 simulated days.
Verified P0 record safely retained indefinitely.

✅ All OpenViking memory bus assertions passed cleanly with 0 mock prints!
测试结论: 相比传统将所有 Agent 记录无脑打包灌入 Prompt 的粗暴方案(13,236 Tokens),采用 OpenViking 层次化分级按需加载后,常驻开销锐减至 541 Tokens,Token 消耗直降 95.91%,并且通过时间戳 TTL 探测成功实现了临时排障信息的物理级自愈清理。
五、架构收益与工程落地启示
1. 解耦“大模型记忆”与“Prompt 载荷”:不要让大模型单次交互承担系统全量记忆的存储工作。利用文件系统管理状态,让大模型只负责实时指令计算。
2. 轻量化共享优于重量级向量同步:在局域或单机多智能体集群中,以结构化文件总线(如 cross-agent-log.jsonl)做增量同步,其速度、可观测性与精准度远超黑盒向量库。
3. 分层分级是治理复杂系统的终极武器:从 L0 到 L2,从 P0 到 P2,通过明确的数据边界与生命周期纪律,真正将 AI 从“玩具式对话”拉升到“工业级工程协同”。
📂 开源实操代码与云端演练: - 💻 GitHub 开源实操仓库:本文配套的完整工程、可执行脚本与单元测试已开源归档至 GitHub: skillup-labs/openviking-hierarchical-agent-memory,欢迎 Star 关注。 - 🚀 在线免安装体验运行验证:无需本地折腾复杂的运行时与系统依赖,一键在浏览器中秒开云端实操终端进行交互验证 👉 Skillup 边学边练在线实验平台 (https://www.skillup.host/)。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: