激活率从 20% 暴力拉升到 84%:Agent Skills 渐进式加载与防装死工程拦截实战
在当今 AI Coding 席卷开发圈的浪潮下,Vibe Coding(氛围感编程) 成了许多工程师日常开发的全新范式。在本地 localhost 里,AI 几分钟就能刷出一个界面精美、交互流畅的原型,开发者如履平地。
然而,这套“魔法”往往在项目准备推向生产环境的一瞬间戛然而止:
- 安全防线全线崩溃:AI 为了省事,直接让前端把 userId 作为参数明文传给后端接口进行数据过滤,攻击者随意改个数字就能横向越权拖库;
- 凭据裸奔与密钥硬编码:大模型调用与数据库鉴权 Key 被直接写死在前端静态打包产物中;
- 代码“只能活在本地”:AI 脑子里只有本地单机全栈的旧范式,根本无法感知真实的云端底座、函数运行时与容器环境边界;
- 最折磨人的“装死”:为了解决上述问题,工程团队花了数周时间精心编写了完整的 SOP 与规范插件(Skills),结果 AI 根本视而不见,依然凭直觉在上下文里盲目裸奔!
在没有工程干预的回归测试中,AI 对配好的 Agent Skills 主动调用率仅有惨淡的 20% 左右。明明把“岗位操作手册”递到了它手边,它宁愿信口胡诌,也不愿意翻书看一眼。
腾讯云开发(CloudBase)团队在将 8 年服务 330 万开发者、日均百亿次调用的云端实践沉淀为 Agent Skills 开放规范的过程中,对这套“AI 驯服困局”进行了系统性破局。
本文将深度复盘:如何通过渐进式加载(Progressive Disclosure)化解上下文负荷,利用端物理隔离杜绝语义污染,并借助Forced Eval Hook(强制评估拦截)将技能激活率从 20% 硬生生拉升到 84% 以上。
一、为什么配好的 Agent Skills,AI 总是“装死”?
很多工程师直觉上认为:只要把规范 Prompt 塞进系统的上下文窗口,或者配好 Skill 目录,强大的大模型就会严格执行。实测证明,这完全忽视了大语言模型(LLM)的底层运行机制。
AI 不爱翻书,本质上是由两个底层逻辑决定的:
+-------------------------------------------------------------------------+
|                  大模型决策惰性与上下文注意力稀释机理                   |
+-------------------------------------------------------------------------+
| [ 用户持续深入的业务对话上下文 ]                                         |
|      │                                                                  |
|      ├── 注意力稀释 (Attention Bias):                                   |
|      │   随着对话轮次加深,业务细节权重上升,外部静态配置被模型当做背景板稀释  |
|      │                                                                  |
|      └── 决策惰性 (Inference Laziness):                                 |
|          模型判定预训练数据(Localhost 模式)能凑出一串“看起来合理”的代码时,   |
|          为节省推理计算路径,会主动规避外部 Tool Use 调用,直接“盲跑裸写”   |
+-------------------------------------------------------------------------+
1. 注意力权重(Attention Bias)的稀释:在 Transformer 架构中,注意力权重在生成时是根据当前 Prompt 动态计算的。随着开发者与 AI 就具体业务细节探讨得越深,业务参数的权重越来越高,而静态注入在系统背景中的技能描述,迅速被推到边缘遭到遗忘;
2. 决策惰性(Inference Laziness):调用 Skill 本质是一次工具调用(Tool Use)。模型在内部做路径评估时,如果觉得靠自己预训练数据里的“通用写法”(通常是 Demo 级的单机代码)就能拼凑出一段逻辑,它就会出于极小化推理消耗的本能,跳过繁琐的外部技能检索;
3. 环境混淆导致的语义污染:当把 Web、微信小程序、Node.js 放在同一个全能单体 Skill 包时,由于它们在各端的 SDK 方法名极其相似(例如都有 init、callFunction、login),AI 经常在写小程序代码时,随手把 Web 端的 DOM 或 Storage 逻辑带进来,导致代码根本无法上线。
二、渐进式加载(Progressive Disclosure)架构解密
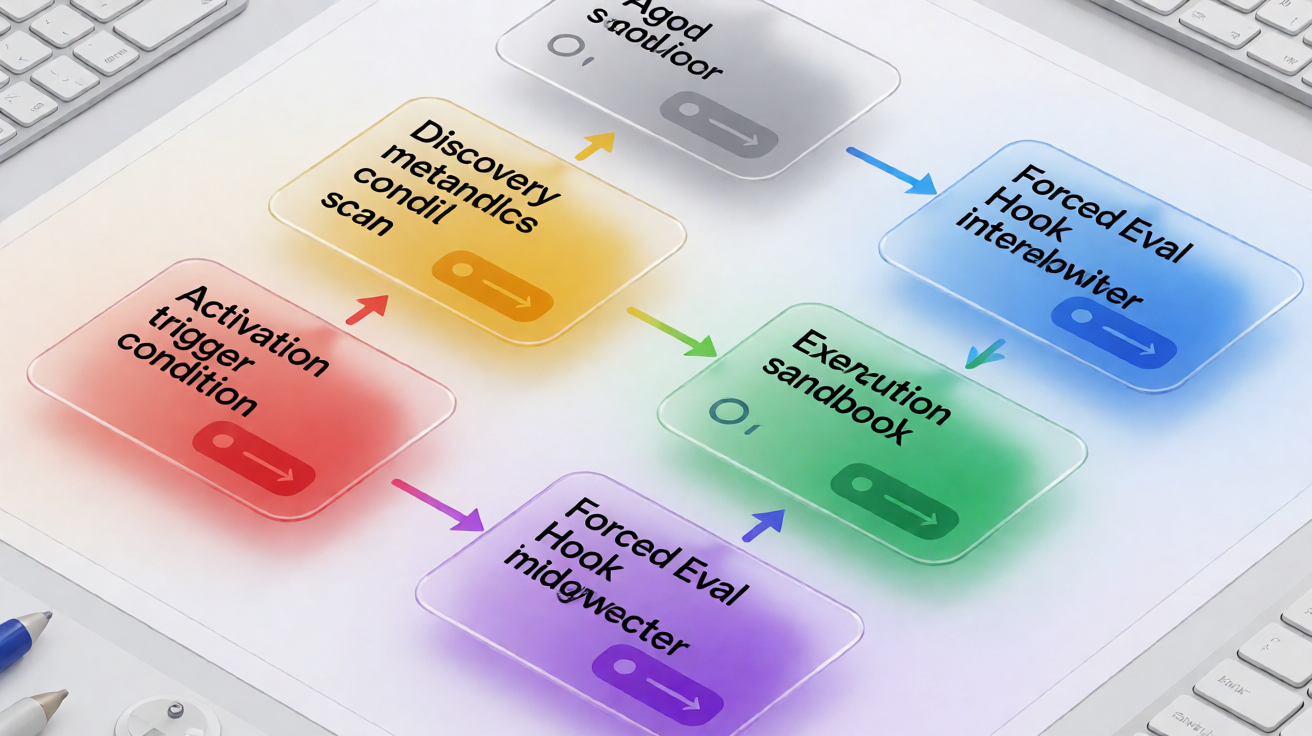
为了让 AI 在成百上千个复杂的工程规范中保持敏锐,Anthropic 提出、各大工具(Claude Code、Cursor、CodeBuddy 等)兼容的 Agent Skills 规范确立了渐进式三阶段加载范式:
阶段 1:Discovery(轻量发现)
启动时,Agent 绝不全量加载 所有技能的 SKILL.md 正文,而是仅仅将各个 Skill 的 name、description 和环境元数据作为候选工具挂载。这一步只占用极微小的上下文(通常不到几百 Token),彻底解决了单体手册挤爆上下文窗口的瓶颈。
阶段 2:Activation(按需激活)
当用户的任务特征命中特定 Skill 的触发描述,或者匹配到强制路由规则时,Agent 才将该技能的完整 SKILL.md 正文动态注入当前会话。
阶段 3:Execution(沙盒执行)
Agent 严格按照操作规程(SOP)生成生产级标准代码,并在需要时调用捆绑的校验脚本进行语法与权限审查。
三、总纲路由与端物理隔离:杜绝跨端语义污染
面对 Web、小程序与 Node.js 混合的大型全栈项目,腾讯云开发团队放弃了“全家桶单体包”的构想,采用了 “1 个总纲 (Guidelines) + 21 个原子插件” 的分布式拓扑:
                           [ 用户请求进入 ]
                                  │
                                  ▼
                   +─────────────────────────────+
                   |  必读总纲: cloudbase-guidelines  |  <── 环境判定与架构总控
                   +─────────────────────────────+
                                  │
             ┌────────────────────┼────────────────────┐
             ▼                    ▼                    ▼
     [ Web 运行环境 ]     [ 小程序运行环境 ]    [ 服务端 / Node.js ]
    ├── auth-web         ├── auth-wechat       ├── auth-nodejs
    ├── no-sql-web-sdk   ├── no-sql-wx-mp-sdk  ├── ai-model-nodejs
    └── cloud-storage    └── miniprogram-rule  └── cloud-functions
- 物理隔离:Web 端与小程序端的方法被拆分进完全独立的子目录中,在加载阶段互不可见,从根本上斩断了 AI “在小程序里写 Web DOM”的错误链路;
- 总纲路由:
cloudbase-guidelines承担语义路由器角色。它首先命令 AI 扫描当前目录树(如是否存在app.json或package.json),精准识别工程环境,再指引 AI 挂载对应端的专项子技能,使得推理搜索空间瞬间缩窄 90%。
四、Forced Eval Hook:把激活率暴力拉到 84% 的关键钥匙
单纯依靠规范引导,AI 依然可能因为决策惰性偷懒。技术专家与云开发工程团队实测发现,最有效的手段是在工程层利用 Hook(钩子)实施物理拦截。
拦截器运作机制:
1. 输入拦截:当开发者在终端或编辑器按下回车发起请求时,Hook 脚本在请求被送到大模型前进行中间件拦截;
2. 强制表态(Pre-flight Self-Evaluation):Hook 会在用户请求前注入一段强约束指令,强制要求模型在输出任何代码前,必须先在回答开头生成一段评估块:- 当前有哪些可用技能?- 针对当前环境(Web / 小程序),我应该调用哪个技能?- 为什么需要调用?还是确认跳过?
3. 消除决策惰性:在 Transformer 生成逻辑中,一旦模型在回答的前半段“白纸黑字”输出了“我要调用 auth-wechat 与 cloudbase-guidelines”,由于前后文一致性与注意力约束,后面的代码生成逻辑就会 100% 严格遵守该技能的所有安全规约!
这一简单的工程拦截,直接将主动调用率从 20% 暴力提升至 84% 以上。
五、边学边练:配套高质量实操演练
为了帮助开发者亲手掌握 Agent Skills 渐进式注册、端环境隔离路由器与 Forced Eval Hook 拦截中间件的完整实现,本项目在开源实战库上线了可运行闭环:
👉 Lab 24:Agent Skills 渐进式加载架构与 Forced Eval Hook 拦截实战 (https://www.skillup.host/)
核心演练代码剖析(无三方依赖开箱即用)
在配套 Lab 24 中,我们实现了一个纯原生 Python 编写的演练引擎 agent_skills_engine.py:
# 代码节选自 labs/agent-skills-hook-evaluator/agent_skills_engine.py
class ForcedEvalHookMiddleware:
    """Forced Eval Hook 拦截中间件:消除大模型决策惰性,提升技能激活率"""

    def __init__(self, registry: AgentSkillsRegistry):
        self.registry = registry

    def intercept_and_evaluate(self, user_prompt: str, current_env: str) -> Tuple[str, List[EvaluationDecision]]:
        discovery_list = self.registry.get_discovery_payload()
        evaluations: List[EvaluationDecision] = []

        for item in discovery_list:
            s_name, s_env = item["name"], item["environment"]

            # 1. 物理环境边界隔离:防止跨端语义污染
            if s_env != "universal" and s_env != current_env:
                evaluations.append(EvaluationDecision(s_name, "SKIP", f"环境不匹配 (当前: {current_env})", 1.0))
                continue

            # 2. 意图特征提取与安全约束命中
            if any(k in user_prompt.lower() for k in ["auth", "login", "登录", "数据库"]):
                evaluations.append(EvaluationDecision(s_name, "ACTIVATE", "命中安全底座边界", 0.95))
            else:
                evaluations.append(EvaluationDecision(s_name, "SKIP", "无业务关联", 0.85))

        # 3. 构造注入模型的预检评估块,消除生成惰性
        eval_block = ["<!-- FORCED_EVALUATION_REPORT -->", f"🎯 当前环境: [{current_env.upper()}]"]
        for e in evaluations:
            eval_block.append(f"  [{e.decision}] {e.skill_name}: {e.reason}")
        eval_block.append("<!-- END_EVALUATION_REPORT -->\n")

        return "\n".join(eval_block) + user_prompt, evaluations
在 Skillup 边学边练云端控制台 (https://www.skillup.host/) 中,你可以免安装环境实时运行该演练,直观对比: - 全量单体装载 vs 渐进式发现的上下文节约实测; - 小程序环境下精准屏蔽 Web DOM 污染的隔离拦截; - Forced Hook 强约束下技能激活决策与按需规程注入。
六、总结:从“代码生成”迈向“生产级交付”
AI Coding 的进化,正在经历从单纯追求代码生成速度的“氛围感编程”,向强调确定性、合规性与安全性的“生产级工程交付”蜕变:
- MCP(模型上下文协议) 赋予了 AI 探向外部世界的“手与脚”;
- Agent Skills 则是为 AI 注入了特定技术栈数十年来沉淀的“工程直觉与岗位手册”;
- CloudBase 等云端底座 则是承载代码真正走出
localhost、提供原生安全信任链的“物理基石”。
给你的 AI 立规矩,配好 Skills,加上 Forced Hook 拦截,让它真正从一个高智商却缺乏敬畏的“实习生”,成长为能独当一面的可靠合伙人。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: