给 OpenClaw 装技能前先过一道 installPolicy,7 个热门技能有 3 个没能落盘
网上流传着不少“OpenClaw 新手必装技能”清单,其中一份很有代表性:安全卫士 skill-vetter、联网搜索 tavily-search、谷歌办公 gog、github、summarize、自我改进 self-improving-agent、主动管家 proactive-agent、find-skills、长效记忆 ontology / agent-memory,最后用 weather 建立信心,安装方式是一句“clawhub install <技能名>”。清单本身挺实用,问题在于“先装 skill-vetter 保安全”这一步给人的安全感,和技能实际拿到的权限并不匹配。
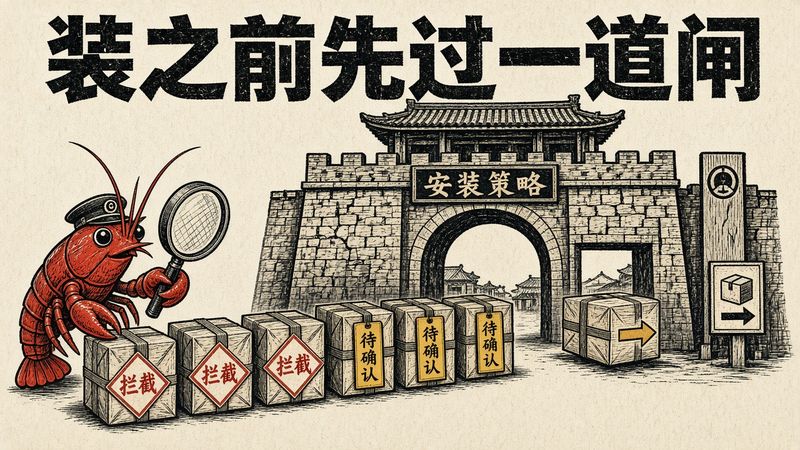
本文把这份清单在 OpenClaw 2026.10.3 上逐个装了一遍,没有停留在“好不好用”,而是沿着一条技能从搜索到落盘的路径做检查:名字会不会搜错、ClawHub 的安全结论是什么、装完能不能加载、包里到底带了什么。最后把这些判断写成一个 security.installPolicy 策略程序,让同一批技能重新安装一遍:7 个第三方技能里 1 个直接放行、3 个要求人工确认、3 个被拦在落盘之前。所有脚本和原始输出都放在页面包的 practice/ 目录里。
清单拆开看:4 个内置技能,7 个来自 ClawHub 的第三方技能
清单号称 10 个,实际涉及 11 个名字(第 9 项写的是 ontology 和 agent-memory 二选一)。按来源分成两组,风险等级完全不同。
内置技能 4 个:github、gog、summarize、weather 随 OpenClaw 安装包分发,位于 node_modules/openclaw/skills/,各自只有一个 SKILL.md,没有可执行代码,本质上是“教模型怎么调用某个命令行工具”的说明书。它们的风险在于依赖的那个命令行工具本身:github 需要 gh,gog 需要 gog,summarize 需要 summarize,weather 需要 curl。命令不存在时技能不会出现在模型面前,openclaw skills check 会标成缺依赖。
第三方技能 7 个:skill-vetter、tavily-search、self-improving-agent、proactive-agent、find-skills、ontology、agent-memory 都要从 ClawHub 下载。它们由个人作者发布,包里可能带脚本、钩子和模板文件,安装后放进 Agent 工作区的 skills/ 目录,下一次会话起就对模型可见。这一组才是本文的检查对象。另外,2026.10 的 skills 子命令在多 Agent 配置下必须带 --agent <id> 指定装给谁,原文的单行命令已经跑不通了。
第一道坎:同一个名字,ClawHub 上能搜出五六个
原文的安装命令只写了技能名。但 ClawHub 是开放注册表,名字不唯一,真正的标识是 @作者/slug。我对清单里每个名字执行了 openclaw skills search <名称> --json,前几条结果如下(节选,下载量为 2026-10-14 实测):
| 搜索词 | 下载量最高的结果 | 其他同名或近名结果 |
|---|---|---|
| self-improving-agent | @pskoett/self-improving-agent,48 万 |
gasgangrene、thcjp、jianghg01 等 4 个同名,各几百次 |
| skill-vetter | @spclaudehome/skill-vetter,27.7 万 |
xtdnpl、sophia-amadeus、thcjp 等同名 |
| proactive-agent | @halthelobster/proactive-agent,17.7 万 |
排在它前面的是 proactive-agent-lite,另有 3 个同名 |
| tavily-search | @jacky1n7/openclaw-tavily-search,10.8 万 |
slug 根本不叫 tavily-search;另有 2 个近 5 万下载的同类 |
| agent-memory | @dennis-da-menace/agent-memory,3.5 万 |
搜索第一名是 proactive-agent-lite,还有 3 个同名 |
这张表有两个信号。一是搜索排序不等于下载量排序:搜 agent-memory 和 proactive-agent,第一条都是另一个技能。二是名字和 slug 可能对不上:清单写的 tavily-search,下载量最高的那个实际叫 openclaw-tavily-search。照着清单敲名字,装到哪个作者的版本全凭运气。所以第一条规矩是:只用 @作者/slug 加 --version 安装,例如 openclaw skills install @pskoett/self-improving-agent --version 4.0.3 --agent skills。
ClawHub 的 verify 结论:pass、fail 和互相打架的扫描器
ClawHub 为每个版本提供信任记录,可以用 openclaw skills verify @作者/slug --agent skills --json 提前查看。7 个技能的结果:
| 技能 | verify 结论 | 安全判定 | skillspector 扫描 | 签名 |
|---|---|---|---|---|
| skill-vetter | pass | benign | — | 未签名 |
| openclaw-tavily-search | pass | benign | CRITICAL 86 分 | 未签名 |
| self-improving-agent | pass | benign | CRITICAL 100 分 | 未签名 |
| proactive-agent | fail | suspicious | — | 未签名 |
| find-skills-skill | pass | benign | — | 未签名 |
| ontology | fail | suspicious | — | 未签名 |
| agent-memory | pass | benign | — | 未签名 |
有三点值得注意。第一,全部未签名,也都没有来源溯源信息,“作者是谁”只能信注册表账号。第二,扫描器之间会冲突:tavily-search 和 self-improving-agent 的总判定是 benign(良性),但其中 skillspector 扫描器分别给出 CRITICAL 86 分和 100 分,只看总结论会漏掉这条信号。第三,也是最关键的一点:verify 判 fail 并不会阻止安装。proactive-agent 安装时终端会打印一个“ClawHub Security Audit / Outcome: Review”面板,写明“给了 Agent 过宽的自动记忆、自我修改、引导文件、后台任务和清理权限”,然后照常下载、照常落盘。官方文档对此也写得很直白:Review 结论只是提示,安装会继续。
装上了不等于能用:skills check 揭出的三种状态
装完后跑 openclaw skills check --agent skills --json,看每个技能对模型是否真的可见。结果分成三种状态:
- 可用且模型可见:skill-vetter、self-improving-agent、proactive-agent、find-skills、ontology,以及内置的 github、weather。注意,两个被 ClawHub 判为 suspicious 的技能都在这一栏,
blocked计数是 0。 - 缺依赖、不会出现:tavily-search 缺环境变量
TAVILY_API_KEY;gog、summarize 缺同名命令行工具。这是正常的门控,补齐依赖后自动生效。 - 安装成功但被静默跳过:agent-memory。它的
SKILL.md前置元数据里没有description字段,OpenClaw 加载时只在日志里打印一行Skipping invalid skill … description is required,skills check的列表里干脆没有它。
最后一种最容易误判:安装命令返回成功,技能目录也在,但模型永远看不到它。如果你按原文第 9 项选了 agent-memory,然后觉得“长效记忆好像没什么用”,原因不是技能效果差,而是它根本没被加载。检查技能是否生效,看 skills check 的 eligible 列表,而不是看安装命令的退出码。
静态审计:逐个打开技能包看里面带了什么
verify 只给结论,不告诉你为什么。我写了一个静态审计脚本 audit_skills.py,读取每个技能的前置元数据(需要的环境变量、命令),扫描命令执行、管道安装、未锁版本的 npx、写入工作区注入文件等模式,列出代码里出现的外部域名和钩子文件:
python audit_skills.py ws-skills/skills node_modules/openclaw/skills \
  --verify-dir skill-audit --only skill-vetter,openclaw-tavily-search,self-improving-agent,proactive-agent,find-skills-skill,ontology,agent-memory
逐个核对命中项后,结论如下:
- proactive-agent:
assets/下自带AGENTS.md、SOUL.md、MEMORY.md、HEARTBEAT.md、TOOLS.md、USER.md六个模板,和 OpenClaw 自动注入的引导文件同名;SKILL.md里还有一整节教 Agent 创建“自主执行”的定时任务。包里残留SKILL-v2.3-backup.md和SKILL-v3-draft.md两个旧版本草稿,说明发布流程比较随意。 - self-improving-agent:带一个 OpenClaw 钩子
hooks/openclaw/HOOK.md及handler.js,监听agent:bootstrap、command:new、command:reset三个事件:会话启动时往上下文里插入提醒块,会话结束时读取刚结束会话的完整记录,按错误模式提取片段追加到.learnings/ERRORS.md。功能本身是公开的,但它意味着一个第三方脚本能读你的全部会话记录。 - find-skills-skill:没有代码,但
SKILL.md里有 10 处未锁版本的npx示例,模型照做时每次拉取的都是最新版。 - openclaw-tavily-search:需要
TAVILY_API_KEY和python3,代码只访问api.tavily.com,和声明一致。 - agent-memory:代码里出现的外部域名
datadeck-preview.vercel.app只在examples/basic_usage.py示例中,属于无害;真正的问题是前面说的缺少 description。 - skill-vetter:扫描命中的两处“命令执行”是它检查清单里的示例文字(“Uses eval() or exec() with external input”),属于误报。
把判断写成 installPolicy:落盘前的最后一道闸
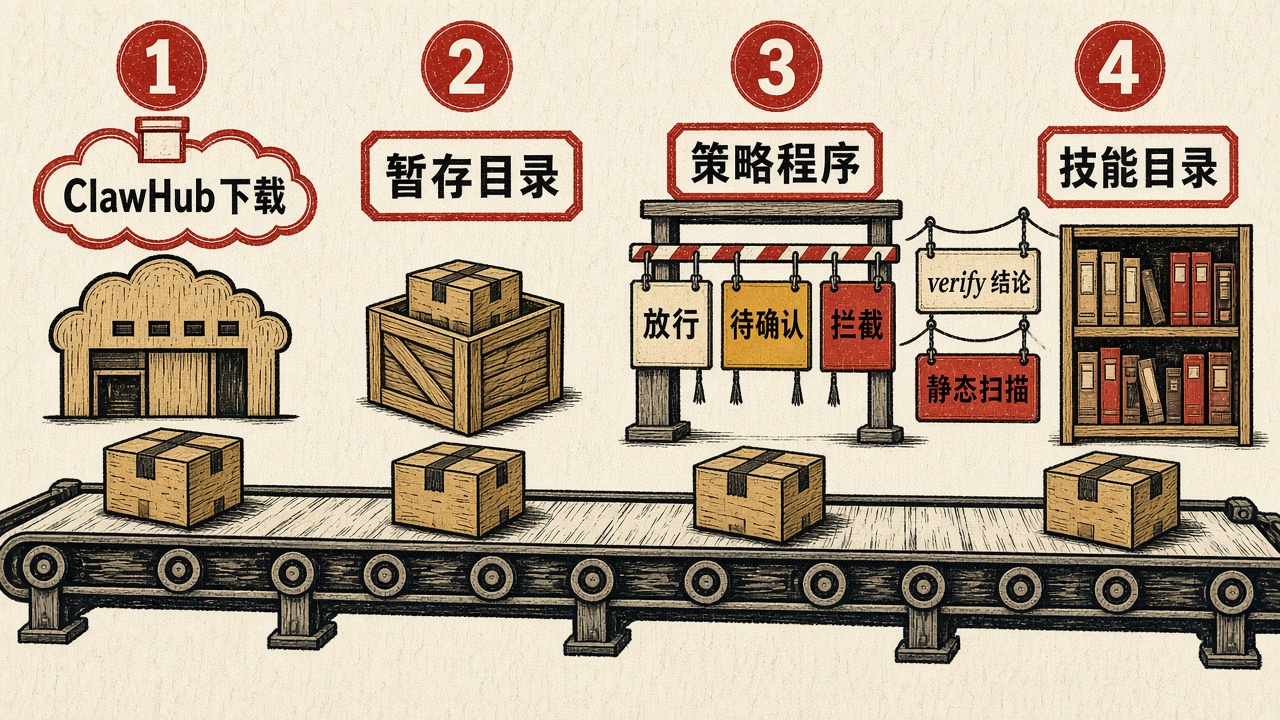
2026.10 提供了 security.installPolicy:启用后,每次安装或更新技能、插件,OpenClaw 会先把包下载到暂存目录,再调用你指定的本地程序做判断。程序从标准输入读到一个 JSON(含 targetName、暂存路径 sourcePath、来源 origin 里的作者和版本),在标准输出返回 allow、warn 或 block,可以附带 findings 明细。返回 block、超时、非零退出或输出不合法,一律拒绝安装。
我的策略程序 install_policy.py 直接复用审计脚本的规则,核心判定只有十几行:
if v.get("decision") != "pass":                      # ClawHub verify 不通过
    block.append(finding("clawhub.verify-fail", ...))
if r["no_desc"]:                                     # 缺 description,装了也不加载
    block.append(finding("skill.no-description", ...))
for f in r["bootstrap_files"]:                       # 自带 AGENTS/SOUL 等同名模板
    block.append(finding("skill.ships-bootstrap", ...))
for f in r["hooks"]:                                 # 带事件钩子
    warn.append(finding("skill.hook", ...))
# 管道安装、未锁版本 npx -> warn;需要密钥类环境变量 -> 提示
配置写进 openclaw.json 顶层。程序路径必须是绝对路径,文件权限要收紧,父目录要可验证,软链接会被拒绝:
{
  security: {
    installPolicy: {
      enabled: true,
      targets: ["skill"],
      exec: {
        source: "exec",
        command: "/opt/openclaw-policy/install_policy.py",
        timeoutMs: 15000,
        passEnv: ["PATH"],
        env: { VERIFY_DIR: "/opt/openclaw-policy/verify", POLICY_LOG: "/opt/openclaw-policy/policy_log.jsonl" },
        trustedDirs: ["/opt/openclaw-policy"],
      },
    },
  },
}
然后把同样 7 个技能按锁定版本装进另一个 Agent,结果如下:
| 技能 | 策略判定 | 命中规则 |
|---|---|---|
| skill-vetter | allow | — |
| openclaw-tavily-search | warn | 需要密钥环境变量 |
| self-improving-agent | warn | 带事件钩子 |
| find-skills-skill | warn | 未锁版本 npx |
| proactive-agent | block | verify 不通过、自带 6 个引导文件同名模板 |
| ontology | block | verify 不通过 |
| agent-memory | block | 缺少 description |
warn 在非交互终端里会停在提交前,审阅后加 --acknowledge-install-policy-warning 可以放行:tavily-search 加上这个参数后退出码为 0,正常安装。block 则没有后门:给 ontology 加 --force 重试,退出码仍是 1,策略理由原样打印。值得一提的是,第一版策略只有静态规则,ontology 被放行了;把 ClawHub 的 verify 结果接进来后才拦住,说明静态扫描和注册表判定需要互补,单靠哪一个都不够。
给原清单的安装路线打个补丁
原文的路线是“先装 skill-vetter 打基础,再装搜索、再装进化和主动性技能”。结合实测,我会这样调整:
1. 把 skill-vetter 当清单,不当防火墙。它是一份给模型看的审查清单,没有任何可执行代码,装了它不会阻止任何东西被安装。真正的闸门是 security.installPolicy,应该在装第一个第三方技能之前配好。
2. 永远用 @作者/slug 加 --version,安装前先 skills verify --json 存档,策略程序据此判定;结论为 fail 的版本不要装,哪怕下载量很高。
3. 装完看 skills check,以 eligible 列表为准,及时发现 agent-memory 这类“装上但被跳过”的技能。
4. self-improving-agent 和 proactive-agent 先在独立 Agent 里试。前者的钩子会读取会话记录,后者会引导 Agent 改写引导文件、创建自主定时任务。用 --agent 装进一个专门的试验 Agent,工作区纳入 git 管理,观察一周的 diff 再决定是否给主力 Agent 用。
5. 密钥只给需要的技能。tavily-search 的 TAVILY_API_KEY 用 skills.entries.<技能名>.apiKey 或 .env 按技能注入(注意这两项只对宿主机运行生效,沙箱运行需另配),不要放进全局环境变量让所有技能都能读到。
技能生态的便利和风险来自同一个地方:一个 Markdown 文件就能改变模型的行为。把“装之前先想一想”写成一段可执行的策略,比在每篇推荐清单里加一句“注意安全”可靠得多。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。