KPI 不该交给 Agent 心算:OpenClaw 跨层汇报边界实测
“12 个 AI 下属每天自己干活、自己复盘,人只看报告”听起来很诱人。真正落到系统里,首先要回答的是:报告里的数字究竟由谁负责。如果阅读量、完成率、日均增量都由模型临场计算,模型既是记账员,又是分析师,还是自己的绩效裁判;只要一次除法口径变了,后面的复盘、建议和资源调度都会跟着偏。
本文换一个更工程化的切入点,在 OpenClaw 2026.10.3 上搭一条最小 KPI 链路:原始计数先交给 Python 脚本计算,生成不可随意改写的 JSON 快照;平台 Agent 只能解释快照和提出建议;媒体总监 Agent 只能验收、批准或驳回,不能替平台 Agent 执行。实测还故意保留了一次自由文本交接,观察两个 Agent 如何在没有恶意的情况下各自“补全”不存在的口径。
说明:文中粉丝、阅读和收藏数字均为构造数据,只用于验证计算权与汇报边界,不代表真实账号表现。完整输入、脚本、快照与两次 Agent 原始回答都保存在页面包的
practice/目录。
先别给 12 个 Agent 画组织架构,先决定谁有计算权
多 Agent 团队常见的分层是:平台 Agent 负责公众号、知乎、掘金等具体渠道,媒体总监 Agent 负责汇总和分配优先级,人类只做最终拍板。这个组织图没有错,但它混淆了三种完全不同的权力:计算事实、解释事实、执行动作。计算事实应该是可重复、可测试、相同输入必得相同输出的确定性工作;解释事实允许有上下文和判断;执行动作则会改变外部世界,例如发文、删稿、调整目标或调用预算。
本次实测把三者拆开。平台采集层只提供原始计数,例如目标粉丝 1800、当前 1474、上期 1427、已过 3 天、剩余 30 天,两篇文章分别有多少阅读和收藏。calculate_kpi.py 负责完成率、缺口、实际日增、所需日增与收藏率,并统一用 Decimal 做舍入。平台 Agent 拿到的是计算后的快照,不允许重算;它只能回答“为什么可能领先”“下一步建议什么”。媒体总监收到的也必须是同一份快照,只能对建议盖“批准”或“驳回”章。这样,即使模型解释错了,原始事实仍能被脚本和人复核,不会悄悄变成另一套数字。
确定性脚本输出什么,Agent 就只能解释什么
实测环境按固定方式加载:进入 .runtime/oc 的环境配置,设置 XDG_CACHE_HOME=$PWD/cache,运行的是 OpenClaw 2026.10.3。输入文件 kpi_input.json 只有原始计数,计算命令如下:
source .runtime/oc/env.sh
export XDG_CACHE_HOME=$PWD/cache
python practice/calculate_kpi.py \
  practice/kpi_input.json \
  practice/kpi_snapshot.json
脚本给出的关键结果是:目标 1800,当前 1474,本期增加 47,完成度 81.9%,距离目标还差 326;按剩余 30 天计算,每天需要增加 10.9,而最近 3 天实际日均增加 15.7,速度比为 1.44。两篇内容合计阅读 9545、收藏 307,收藏率 3.22%。这些字段都带明确路径,例如 followers.actual_daily_gain,并标记 source: deterministic-script。
这里有两个刻意的设计。第一,脚本输出“事实”,但不输出“应该继续什么选题”这类判断;第二,脚本保留 schema_version,以后若把“完成度”从累计目标改成月度目标,必须升级契约,不能静默换公式。偶发算错尚能复核,真正棘手的是团队里的 Agent 各自采用一套看似合理、实际不同的公式。把公式收进代码后,测试、代码审查和历史重放才有抓手。
两次自由文本交接,数字就开始变形
我先故意不用结构化信封,把完整快照塞进平台 Agent 的消息,并要求它“三行输出:事实、解释、建议;不得重算”。平台 Agent 大部分数字引用正确,却补了一句:“收藏率高于一般基准。”问题在于输入里根本没有行业基准,也没有本账号历史基线。模型没有伪造具体百分比,但它把一个观察包装成了比较结论。
随后把这段原话交给媒体总监 Agent,并明确要求找出无证据主张。它成功指出“高于一般基准”缺证据并驳回建议,却又在验收结论里写成“日增 47”。原快照中 47 是三天累计增量,真正的日均值是 15.7。也就是说,汇总 Agent 一边纠正上游,一边制造了新的口径错误。两个回答都流畅、都像业务报告,若只扫一眼很容易放过。
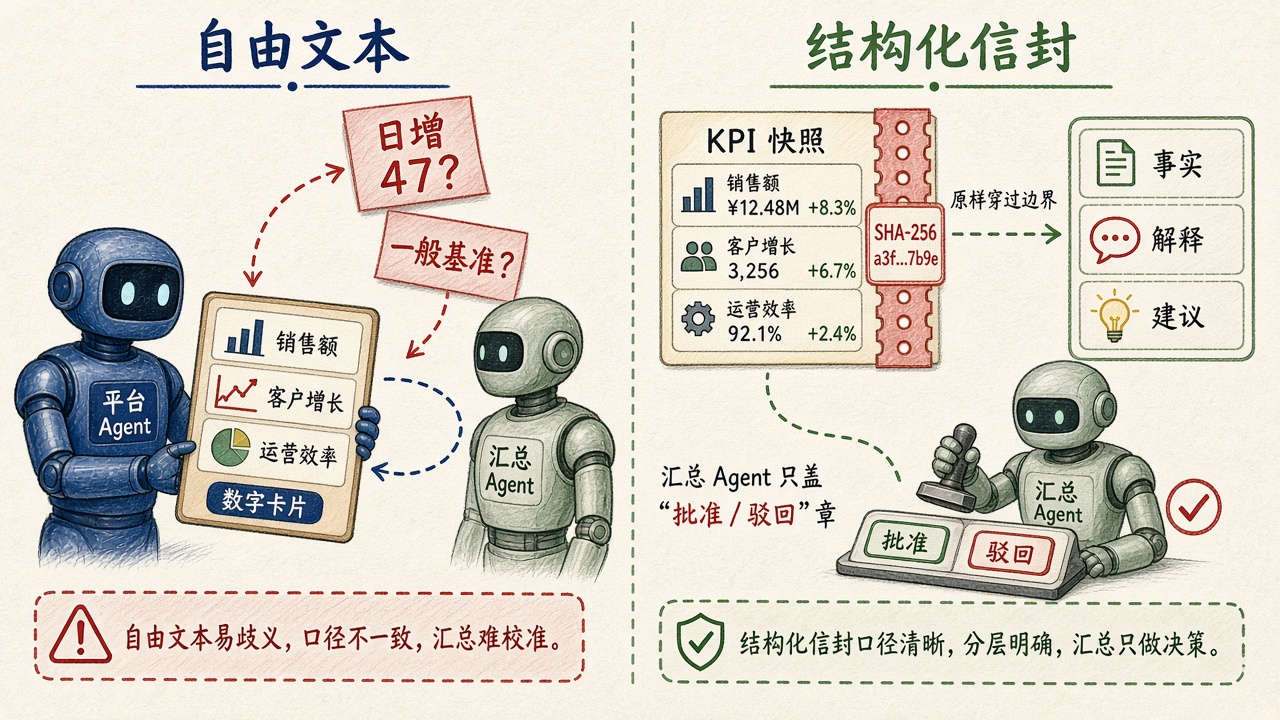
这次结果说明,提示词里的“不要重算”只是行为建议,不是数据边界。自由文本把字段名、单位和时间窗口压扁成一句话,接收方只能重新理解。层级越多,发生“累计增量被说成日增”“本账号表现被说成行业基准”的机会越多。更危险的是,这类错误通常不会触发异常:命令退出码仍是 0,Agent 也会自信地给出下一步动作。
跨 Agent 汇报要传信封,不要传作文
继续加长提示词解决不了字段在传递中变形的问题,因此汇报需要一个机器可验的信封。页面包中的 build_handoff.py 把原始 KPI 快照完整嵌入 handoff.json,按规范化 JSON 计算 SHA-256,并把模型可写内容隔离到 agent_interpretation。解释必须列出 evidence_paths,例如“当前增速领先”只能引用 followers.actual_daily_gain 与 followers.required_daily_gain;建议放在 requested_decision;平台 Agent 的 executed_actions 必须为空。
汇总层在调用模型之前先运行 verify_handoff.py。它检查四件事:快照哈希是否一致、发送方与接收方是否不同、平台 Agent 是否越权执行动作、快照来源是否为确定性脚本。本次信封校验返回 pass: true,哈希为 fb262498...9ab9c1。这一步不判断建议好不好,只保证接收方看到的还是发送方看到的那组事实。
{
  "from_agent": "zhihu",
  "to_agent": "media",
  "snapshot_sha256": "fb262498...9ab9c1",
  "agent_interpretation": {
    "status": "ahead_of_required_pace",
    "evidence_paths": [
      "followers.actual_daily_gain",
      "followers.required_daily_gain"
    ]
  },
  "requested_decision": "keep_current_topic_mix",
  "executed_actions": []
}
信封让事实、解释、建议和动作各自留在固定字段中,并不限制 Agent 展开分析。媒体总监可以反对解释,也可以驳回建议,但不能改写 snapshot;如果确实发现输入错误,应退回采集或计算层重新生成新版本,不能在汇报里手工修数字。
平台 Agent 和汇总 Agent 的边界要写成能力清单
只写“你是媒体总监”并不能自动产生管理边界。更稳妥的做法是同时写允许项和禁止项。平台 Agent 的允许项是读取自己的平台快照、解释异常、提出一个可审批建议、上报自己的阻塞;禁止项是修改 KPI 目标、替其他平台写结论、直接调度其他 Agent、把建议描述成已执行。汇总 Agent 的允许项是验收信封、比较各平台同口径指标、批准或驳回建议、把冲突升级给人;禁止项是代替平台 Agent 发布、补写缺失数据、重算数字、把一个平台的经验直接写进另一个平台的操作规则。
跨 Agent 汇报还要遵守最小披露:知乎 Agent 不需要拿到公众号 Cookie,媒体总监也不需要读取各平台完整浏览器会话;它只需要快照、证据路径、建议和阻塞状态。若必须下发动作,应该生成新的任务 ID,由目标 Agent 接单并回执,而不是让汇总 Agent越过边界直接操作。这样审计日志可以回答三个问题:谁提出的、谁批准的、谁实际执行的。
原文强调“一个通用 Agent 管不过来,就逐步拆成多个专业 Agent”,这是合理的组织演进。系统能否保持可控,取决于每条边界上有没有契约,而非拆出了多少角色。没有契约时,12 个 Agent 只是 12 个都能改数字、都能替别人做决定的聊天窗口;有了契约,即使先从“一个平台 Agent + 一个汇总 Agent”开始,也已经具备扩容所需的治理骨架。
晚间复盘应该由验证器收尾,而不是由 Agent 自证成功
一条可上线的晚间链路可以拆成六步。第一步,采集器保存原始平台计数,并记录采集时间与来源;第二步,确定性脚本生成带版本号的 KPI 快照;第三步,验证器检查必填字段、非负数、分母不为零和时间窗口;第四步,平台 Agent 只根据字段路径写解释与建议;第五步,信封验证通过后交给汇总 Agent审批;第六步,执行 Agent 根据批准后的任务 ID 操作外部平台,并把结果写回独立的动作日志。
每一步失败都应停止向后传播。例如收藏数大于阅读数,不应该让模型“合理解释”,而应由输入校验直接拒绝;平台 Agent 写了“已发布”,validate_agent_report.py 应视为越权;快照哈希变化,汇总 Agent 根本不应启动。本次自由文本报告经过检查器时被判定失败,因为出现了快照不存在的“一般基准”主张。机器门禁不必理解所有中文,只需先拦截最危险的数字漂移、越权动词和数据源不明。
这也改变了人类管理者的工作:逐项拿计算器核对让位于检查异常信封、被驳回建议、重复失败的任务和需要调整的目标。Agent 可以写出很好的解释,但“它说自己算对了”不应成为验收依据。可靠的闭环需要脚本计算、验证器验收、Agent 解释、负责人决策,最后由执行端留痕。
从两个 Agent 起步时,照这张清单落地
第一,先定义 KPI 字段和公式,再写 Agent 人设。至少写清楚目标值、当前值、统计窗口、分母、舍入规则和数据源;同一个“日增”不能有时指当天变化,有时指三天累计。第二,把计算脚本放进版本控制,输出 JSON 而不是自然语言,让任意一天都能用原始输入重放。第三,平台 Agent 的解释必须引用字段路径,禁止引入快照之外的比较基准;想用行业基准,就把基准作为有来源、有日期的输入字段。
第四,跨 Agent 只传结构化信封,快照部分加哈希,解释、建议和执行结果分槽。第五,汇总 Agent 只做审批,不持有平台执行凭据;真正的发布动作回到对应平台 Agent,并要求任务 ID 与结果回执。第六,先做失败演练:篡改一个数字、删掉一个字段、让平台 Agent 声称“已发布”,确认验证器都能拦住。最后再增加第三、第四个平台,而不是先复制 12 份人格文件。
多 Agent 运营能否形成杠杆,取决于分工是否可验证。KPI 数字让脚本负责,Agent 承担它擅长的解释和推理;平台层只上报自己的事实与建议,汇总层只审批,不越权代办。守住这两条边界,“AI 团队每天自己复盘”才能从演示效果变成一条可审计、可回放、出错后能定位责任的生产链路。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。
本文首发于边学边练技术中台:https://www.skillup.host/bxbl/6447.html