两个 KWOK 集群塞进一个 Kite:扩容、YAML 与权限边界实测
轻量级 Kubernetes 面板最容易陷入两种误判:一是看到漂亮首页,就把“能列资源”当成“能承担运维”;二是看到功能清单很长,就默认日志、终端、监控和权限天然可用。真正决定工具是否适合团队的,是它怎样保存 kubeconfig、如何隔离多个集群、写操作会不会越权,以及没有 Prometheus 或真实容器运行时的时候会怎样失败。
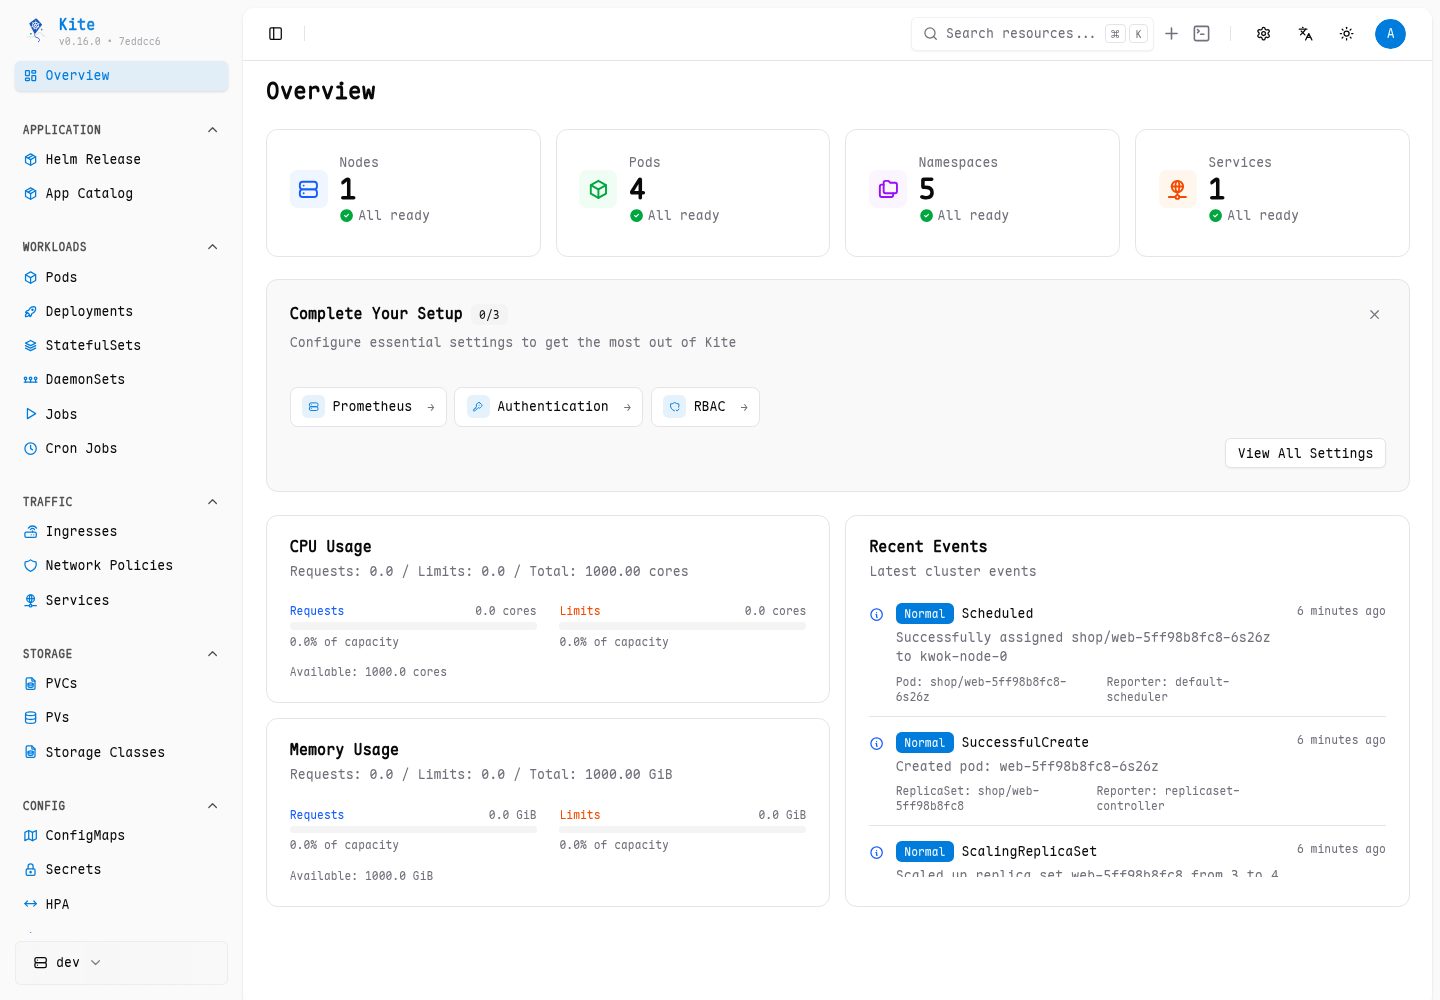
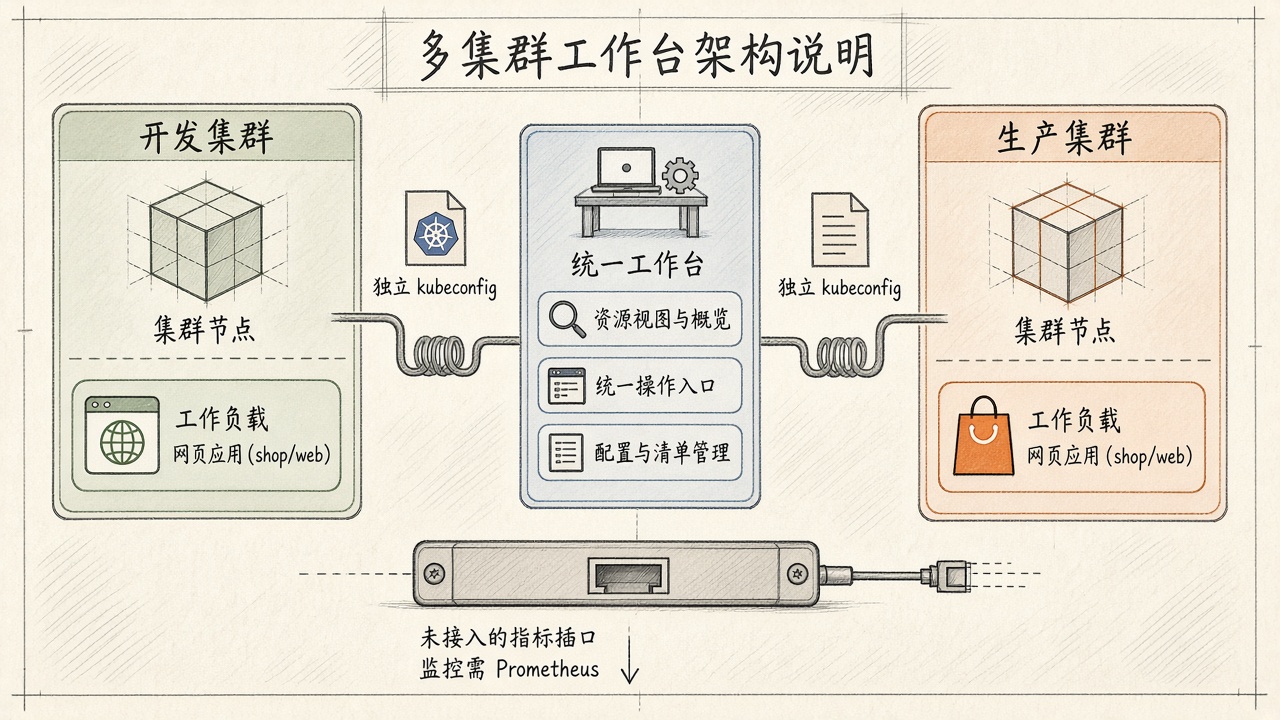
这次我没有停在项目截图和功能介绍上,而是用 Kite v0.16.0 接入两套独立的 KWOK 集群。dev 与 prod 都有一个 kwok-node-0,shop 命名空间里各运行一套 web Deployment 和 3 个 Pod。测试覆盖多集群切换、Deployment → ReplicaSet → Pod 关系、扩容、YAML Apply、配置文件托管 RBAC,以及监控、日志、终端的边界。结论先放在前面:Kite 很适合作为中小团队的统一工作台,但它不是一个“装上就拥有可观测性”的魔法盒子。
轻量面板的分水岭,在控制面的边界
Kubernetes Dashboard、Lens、Kuboard 与 Kite 看上去都在解决“不要总敲 kubectl”的问题,但产品边界并不相同。原生 Dashboard 更接近一个集群内的 Web 管理入口;Lens 偏向桌面客户端和个人工作站;Kuboard 更强调中文化与集群管理体验;Kite 则把自己定位为一个可自托管、支持多集群、权限治理和可观测性接入的 Web 工作空间。团队采用 Web 入口,实际是在同一处收敛集群入口、身份、审计和日常操作,少敲几条命令只是附带收益。
评估这类产品时,我建议先问四个问题。第一,集群凭据是明文落库,还是经过可靠加密?第二,多集群只是下拉框切换,还是每次 API 请求都明确绑定集群上下文?第三,RBAC 是界面装饰,还是写接口真的会拒绝不该发生的修改?第四,日志、exec 与监控依赖哪些集群基础设施?这四项比“支持多少种资源”更能预测生产风险。
| 观察维度 | Kite v0.16.0 的表现 | 落地判断 |
|---|---|---|
| 多集群 | 每个集群独立保存 kubeconfig,可设置默认集群 | 适合 dev/staging/prod 统一入口 |
| 资源操作 | 列表、详情、YAML、扩缩容、重启、关系资源 | 覆盖常见日常运维 |
| 权限 | 自带角色模型,并叠加 Kubernetes 端权限 | 需要同时设计两层权限 |
| 监控 | 对接每个集群的 Prometheus | 不会替代 Prometheus |
| 终端与日志 | 依赖真实 kubelet、容器运行时及对应 RBAC | KWOK 假 Pod 无法完整验证 |
两套 KWOK 集群如何接入:配置文件比手工导入更适合复现
为了把变量压到最少,我使用 KWOK 创建 dev、prod 两套 Kubernetes v1.36.1 控制面。KWOK 会让 Node 和 Pod 呈现为正常状态,却不启动真实容器,因此非常适合验证控制器、资源关系和 API 行为,也能清楚暴露“资源状态正常”和“工作负载真的在运行”之间的差别。两套集群都准备了 shop/web Deployment,初始副本数为 3。
Kite 支持通过 KITE_CONFIG_FILE 在启动时声明超级管理员、集群和 RBAC。配置文件中的区块会在每次启动时同步到数据库,并在 UI 中进入只读托管状态。这比手工点击导入更适合 GitOps,也便于把环境差异变成显式配置。下面是经过脱敏和精简的结构,真实 kubeconfig 应通过 Secret 或环境变量注入,不能直接提交到仓库。
superUser:
  username: admin
  password: "${KITE_ADMIN_PASSWORD}"

clusters:
  - name: dev
    description: "KWOK development cluster"
    config: "${DEV_KUBECONFIG}"
    default: true
  - name: prod
    description: "KWOK production cluster"
    config: "${PROD_KUBECONFIG}"

rbac:
  roles:
    - name: admin
      clusters: ["*"]
      namespaces: ["*"]
      resources: ["*"]
      verbs: ["*"]
    - name: viewer
      clusters: ["*"]
      namespaces: ["*"]
      resources: ["*"]
      verbs: ["get", "log"]
启动时还应显式设置独立的 KITE_ENCRYPT_KEY、数据库路径和配置文件路径。实测日志显示 Kite 成功应用 2 个集群、2 个角色和 1 条角色映射,随后分别为 dev、prod 建立客户端,两边版本都识别为 v1.36.1。启动成功只是基线;能否重复部署、敏感值是否避开公开文件、生产密钥是否替换默认值,才决定这份配置能不能继续进入生产环境。
从资源列表到关系图:Deployment、ReplicaSet 与 Pod 能否对得上
多集群面板最危险的操作失误,是操作者以为自己在开发环境,实际请求却发到了生产环境。Kite 的前端会把当前集群写入本地状态,API 请求通过 x-cluster-name 指定目标;路由也可以使用 /_clusters/dev/... 这样的集群作用域。实测中,dev 和 prod 都能独立列出 kwok-node-0,两边 shop/web 的资源对象不会混在一起。
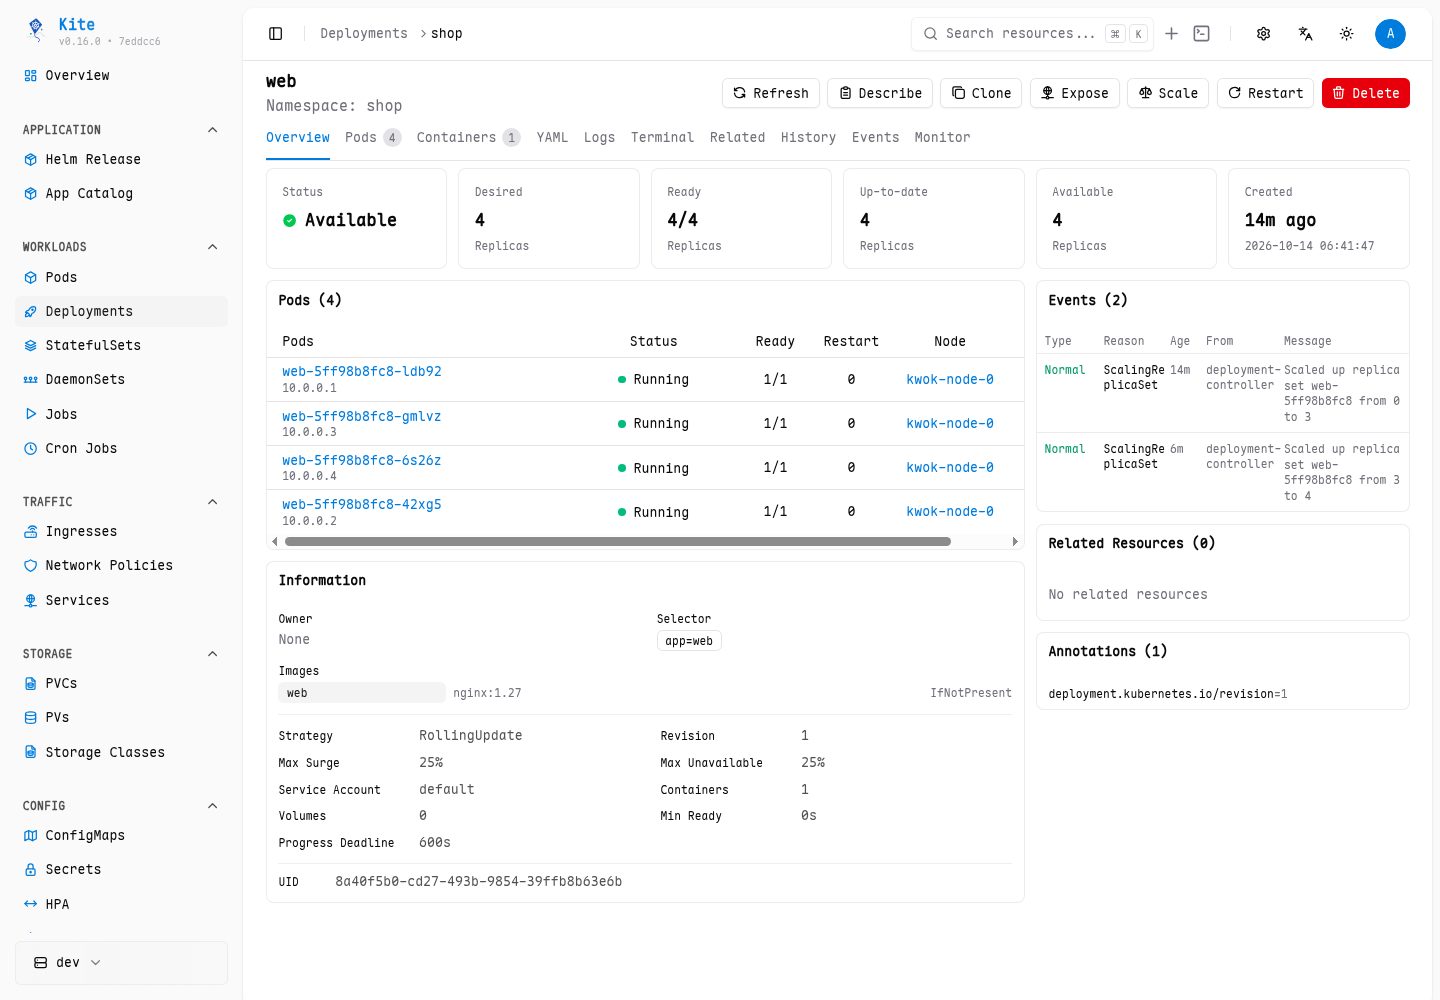
关系链也通过 Kubernetes 原生 ownerReferences 得到了验证:Deployment web 拥有 ReplicaSet web-5ff98b8fc8,ReplicaSet 再拥有 3 个 Running Pod。滚动更新卡住时,这个关系视图可以直接充当排障索引:操作者从 Deployment 进入新旧 ReplicaSet,再检查 Pod 数量、状态和事件,无需在多个 kubectl get 与 label selector 之间来回拼接上下文。
dev / shop
Deployment web (replicas=3)
└── ReplicaSet web-5ff98b8fc8
    ├── Pod web-5ff98b8fc8-42xg5  Running
    ├── Pod web-5ff98b8fc8-gmlvz  Running
    └── Pod web-5ff98b8fc8-ldb92  Running
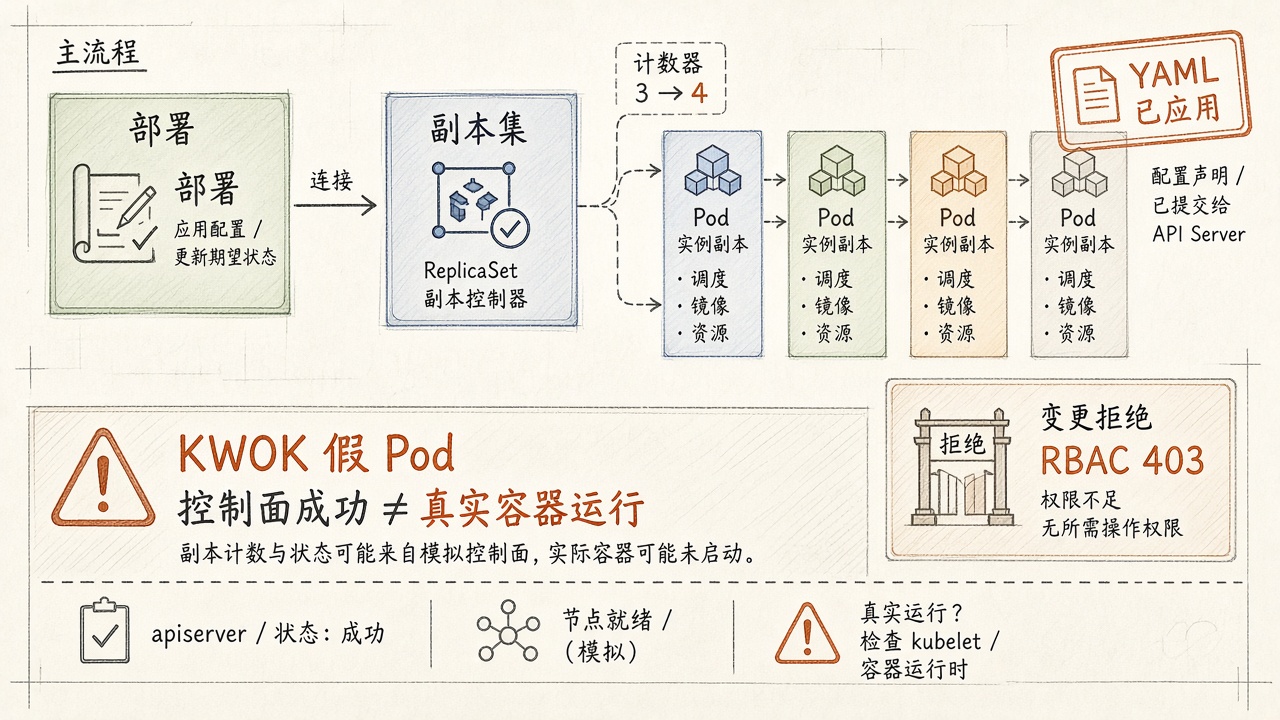
关系图仍然不能替代故障判断。ownerReferences 只说明对象归属,容器进程是否健康、请求链路是否正常,还要结合 readiness、事件、容器日志、Service Endpoints 和 Prometheus 指标判断。拓扑适合作为导航入口;若把它当成健康证明,排障方向很容易走偏。
扩容与 YAML Apply 实测:控制器写入成功不等于业务成功
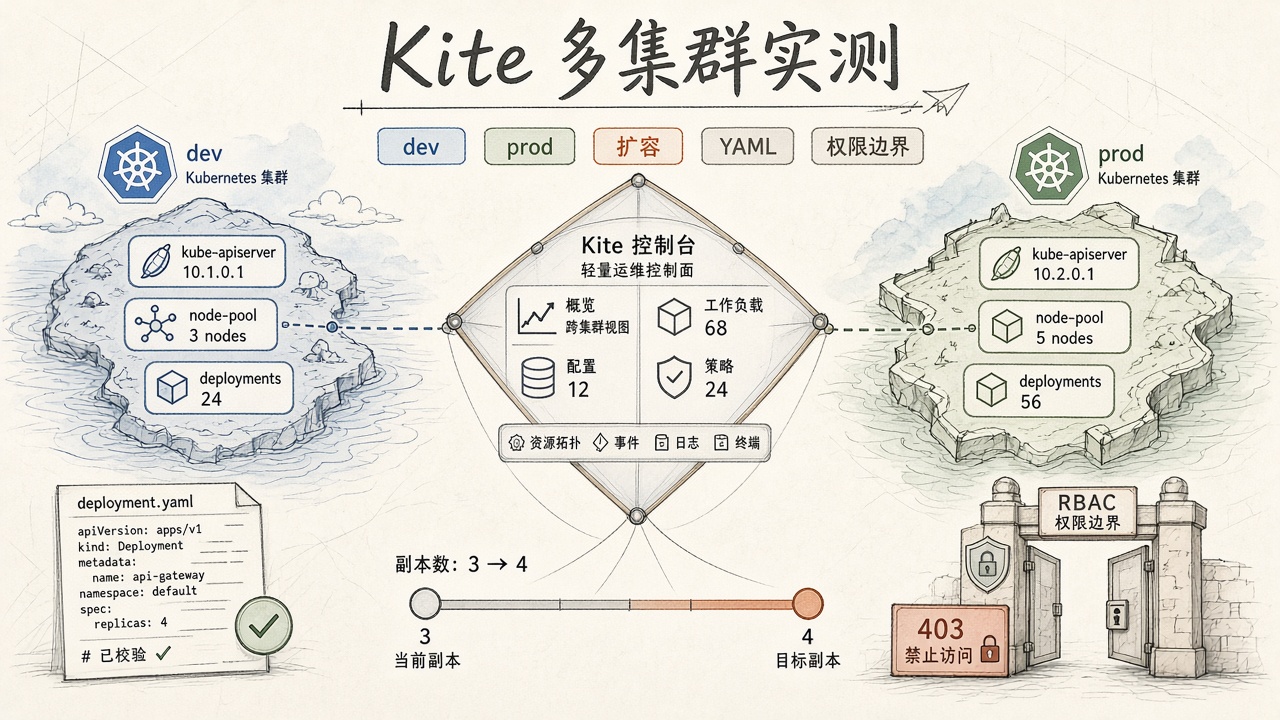
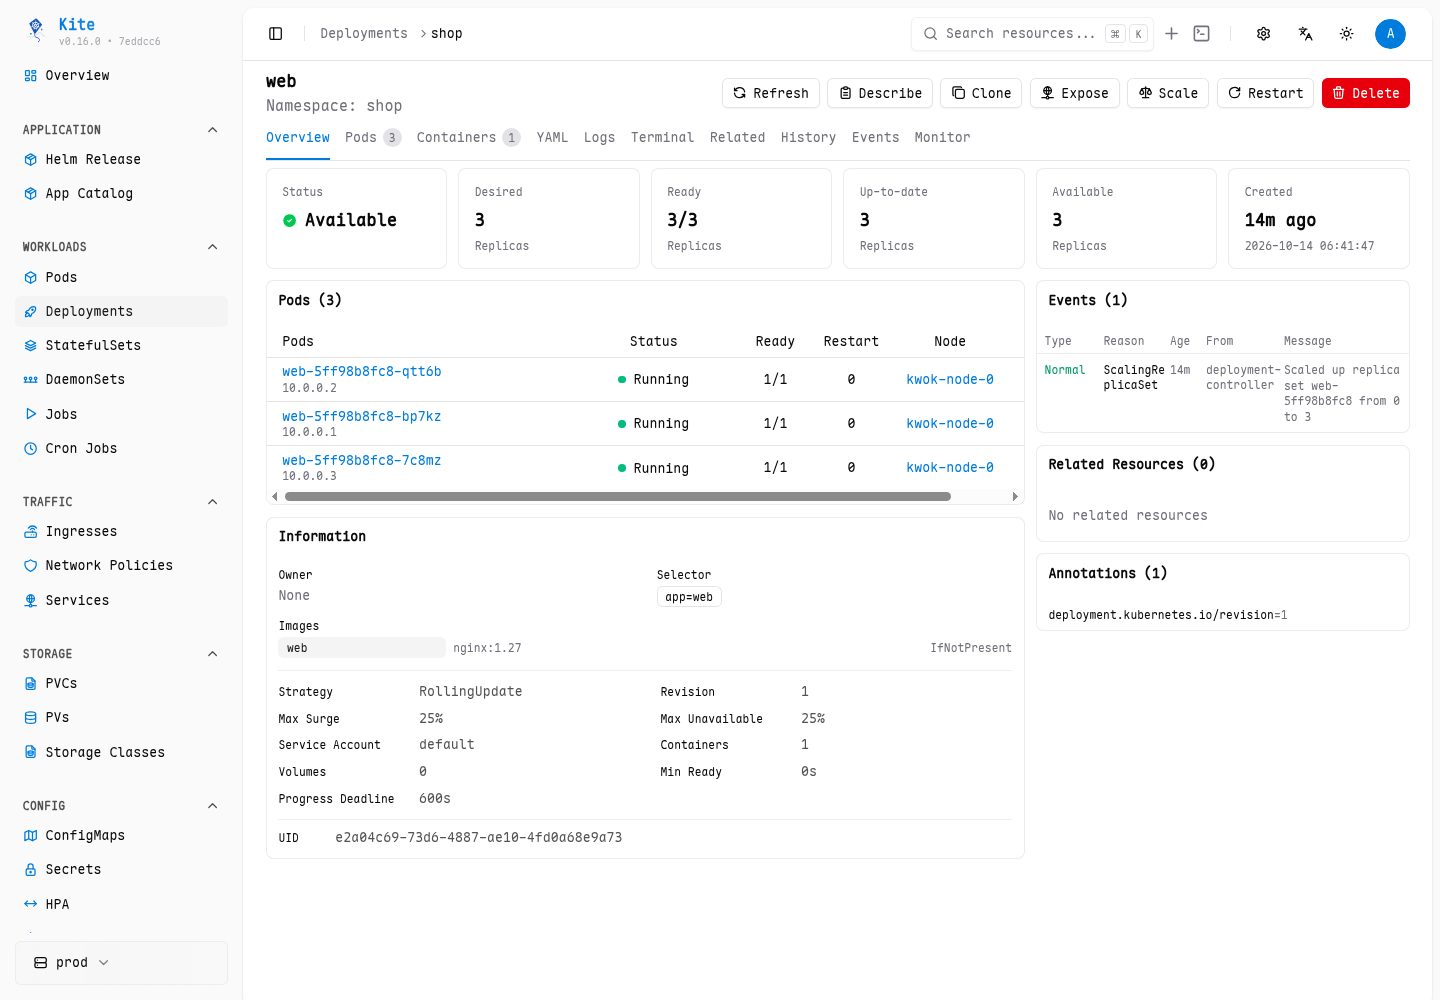
我先通过 Kite 的资源 API 将 dev/shop/web 从 3 个副本改为 4 个。PATCH 返回的 Deployment spec.replicas 为 4,随后 Pod 列表出现第四个 Running 对象。由于 prod 使用独立集群上下文,它仍保持 3 个副本。这个对照说明,多集群切换不仅体现在页面标题上,请求确实落到了指定的 API Server。
{
  "cluster": "dev",
  "namespace": "shop",
  "deployment": "web",
  "before": 3,
  "after": 4,
  "runningPods": 4
}
第二个写操作是 YAML Apply。我在在线 YAML 能力对应的 /api/v1/resources/apply 接口提交一个 ConfigMap,服务端返回 Resource applied successfully,再次读取时可以看到 mode: article-verified。这条链路比单纯编辑现有对象更值得测试,因为它会经过 YAML 解码、资源映射、Kite RBAC 判断、Kubernetes Create/Update,以及操作历史写入。
apiVersion: v1
kind: ConfigMap
metadata:
  name: kite-demo-settings
  namespace: shop
data:
  mode: article-verified
需要强调的是,KWOK 只模拟 API 对象与控制器状态。第四个 Pod 显示 Running,并不代表 nginx 进程真的启动,也不能据此判断扩容后吞吐提升了 33%。生产扩容必须继续观察 readiness、错误率、延迟、资源使用量与流量分布。面板把写操作做得更方便,也就更需要在团队流程中加入审批、审计和回滚约束。
下图是同一个 shop/web 在两个集群中的对照:dev 已扩到 4 副本,并记录了从 3 到 4 的 ScalingReplicaSet 事件;prod 仍保持 3 副本。两张图的资源名相同,但左下角集群上下文和副本状态不同,可以直观看到操作没有串到生产环境。
RBAC 403 为什么比“能创建角色”更有说服力
当 rbac 区块由 KITE_CONFIG_FILE 管理时,界面应该只展示配置,不允许临时手改。我使用管理员会话向角色创建接口提交新角色,服务端返回 HTTP 403,响应为 This section is managed by configuration file and cannot be modified through the UI。这不是 Kubernetes RBAC 拒绝,而是 Kite 的配置托管边界在应用层生效,避免运行时改动覆盖声明式配置。
POST /api/v1/admin/roles/
HTTP/1.1 403 Forbidden

This section is managed by configuration file and cannot be modified through the UI
不过,Kite 自身 RBAC 与 Kubernetes RBAC 是两层不同的控制。前者决定某个 Kite 用户能否对某集群、命名空间和资源执行 get/create/update/delete/log;后者由 kubeconfig 中的身份或 Cluster Agent 的 ServiceAccount 决定 API Server 最终是否接受请求。如果给 Kite 接入的是 cluster-admin 凭据,再把 Kite 角色配得过宽,风险仍然很高。生产上应为 Kite 创建最小权限身份,按团队拆分集群与命名空间范围,并保留审计日志。
配置文件也不应被误解为“天然安全”。它只是让变更来源更清晰。管理员密码、OAuth client secret、LDAP bind password 与 kubeconfig 仍是敏感信息,应存入 Kubernetes Secret、External Secrets、Sealed Secrets 或可靠的密钥系统,通过环境变量占位符注入,而不是把真实内容留在普通 YAML。
kubeconfig 怎样落库:SecretString 背后是 AES-GCM,但默认密钥必须换
源码中的 Cluster.Config 类型不是普通字符串,而是 model.SecretString。GORM 写数据库时会调用它的 Value():明文先进入 utils.EncryptString,再把结果保存到数据库;读取时 Scan() 调用 DecryptString 还原。具体算法是先对 KITE_ENCRYPT_KEY 做 SHA-256,得到 AES 密钥,然后使用 AES-GCM 和随机 nonce 加密,最终以 Base64 文本落库。GCM 同时提供机密性和完整性校验,比简单编码或固定 IV 的 CBC 更可靠。
keyHash := sha256.Sum256([]byte(common.KiteEncryptKey))
block, _ := aes.NewCipher(keyHash[:])
gcm, _ := cipher.NewGCM(block)
nonce := make([]byte, gcm.NonceSize())
io.ReadFull(rand.Reader, nonce)
ciphertext := gcm.Seal(nonce, nonce, []byte(input), nil)
这套设计有一个明确前提:KITE_ENCRYPT_KEY 必须由部署者提供并妥善保管。源码在环境变量缺失时会使用默认值,并打印“not secure for production”的警告。默认密钥意味着任何拿到数据库且知道项目默认配置的人,都可能尝试解密敏感字段。生产部署应生成足够长的随机密钥,放入 Secret 管理系统,限制读取权限,并把备份、恢复与密钥轮换纳入运维方案。更换密钥前还要考虑旧数据如何解密和迁移,不能直接替换环境变量后重启。
日志、终端与监控的边界:KWOK 和 Prometheus 分别缺了什么
本次环境中,Pod、ReplicaSet、Deployment、Node 与 ConfigMap 都能正常读写,但日志和 Web Terminal 不能被当作有效功能验证。原因不在 Kite,而在 KWOK:它创建的是“假 Pod”,没有真实容器进程、容器日志流和可供 exec 的运行时。因此,针对这些 Pod 发起 logs 或 exec,即使对象状态显示 Running,也不会得到真实 nginx 容器的输出。要验证这两项,应换用 kind、k3d、minikube 或实际 Kubernetes 集群。
监控也是同样的依赖关系。Kite 不会自己采集 CPU、内存、磁盘 I/O 与网络时序数据,它查询的是每个集群配置的 Prometheus。当前两套集群没有设置 prometheusURL,访问查询接口得到 HTTP 503 和 Prometheus client not available;同时,Node/Pod 列表会提示集群里不存在 metrics.k8s.io/v1beta1。这正是合理的失败方式:没有数据源就明确报不可用,而不是填充看似真实的零值图表。
若要在生产中启用完整观测链路,至少需要部署 Prometheus 或兼容 API 的时序系统,配置正确的集群级访问地址,并确保指标标签与 Kite 查询匹配。若还要使用日志和终端,则需为 kubeconfig 身份授予 pods/log、pods/exec 等必要权限,同时控制谁能够调用这些高风险能力。终端入口尤其不应对所有只读用户开放。
选型结论:Kite 适合做统一入口,但不要让便利掩盖权限
经过两套集群的写读对照,Kite v0.16.0 的优势很清晰:单二进制即可提供现代 Web UI,多集群上下文确实隔离,资源关系能帮助排障,YAML Apply 与扩缩容覆盖常用操作,配置文件托管还能把角色与集群声明纳入 GitOps。对于没有大型平台团队、又不希望每位成员都直接保管多份 kubeconfig 的团队,它比单纯的 Dashboard 更接近一个共享工作台。
Kite 的边界同样明确:它不能替代 Rancher、完整可观测平台或企业级策略引擎。Prometheus、真实容器运行时、Kubernetes RBAC、密钥管理和审计留存仍要由部署者补齐。尤其要避免三个快捷但危险的做法:使用默认 KITE_ENCRYPT_KEY、把 cluster-admin kubeconfig 直接交给所有用户、看到 KWOK Pod 为 Running 就宣称日志和终端已验证。
我的建议是先在非生产集群接入,只给最小权限身份;用配置文件管理集群与 RBAC;接入 Prometheus 后再开放监控;用真实测试 Pod 验证日志、exec 和 Kube Proxy;最后才逐步纳入生产集群。轻量工具的正确价值,是减少重复操作和上下文切换,而不是绕过 Kubernetes 原本就需要认真设计的安全边界。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。
本文首发于边学边练技术中台:https://www.skillup.host/bxbl/6449.html