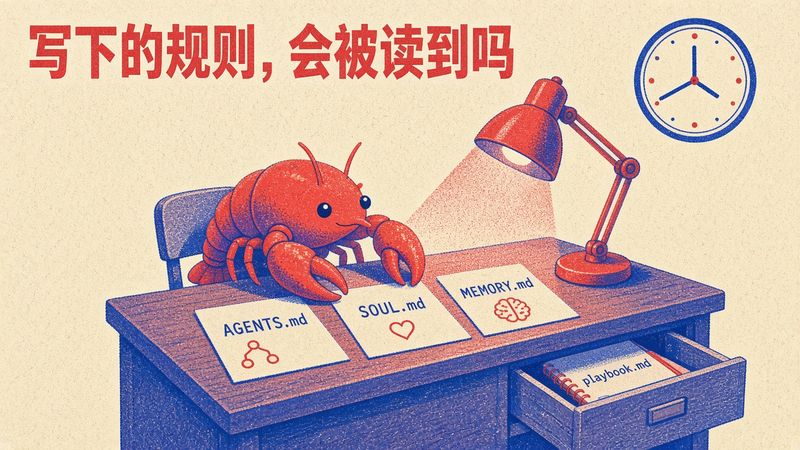
经验写进 playbook.md 不等于被记住,OpenClaw 自动注入的只有 AGENTS、SOUL 和 MEMORY
有一类 OpenClaw 玩法最近传得很广:给每个内容平台配一个 Agent,每晚定时复盘当天数据,把有效的打法写进自己的 playbook.md,第二天再按新规则干活,号称“Agent 学会了自我进化”。思路本身没问题,“文件是唯一的真相来源”也是对的。但这个闭环能不能转起来,取决于一个经常被跳过的前提:第二天的 Agent 到底有没有读到前一晚写下的规则。
本文在 OpenClaw 2026.10.3 上按原方案搭了一个最小复现:一个知乎运营 Agent、两天的模拟数据、一份带版本号的 playbook。先跑一次晚间复盘,用脚本验收它改了什么;再做三组对照,直接从会话库里查每个会话注入了哪些文件、调了哪些工具。结论先放这里:自定义的 playbook.md 不在自动注入清单里,Agent 读不读全看它当时“想不想起来”;要让规则稳定生效,得把读取动作写进 AGENTS.md,或者把关键规则沉淀进 MEMORY.md。
说明:文中的平台阅读、收藏数据均为构造的模拟数据,只用于验证闭环,不代表任何真实账号表现。模型使用 DeepSeek-V3(经硅基流动 OpenAI 兼容接口),换成更强的模型后具体比例会变,但注入机制不变。
原方案的进化闭环由哪几块拼成
原方案里有 11 个平台 Agent,外加一个汇总用的“媒体总监”。拆开来看,支撑“自我进化”的只有四样东西,和 Agent 数量无关。
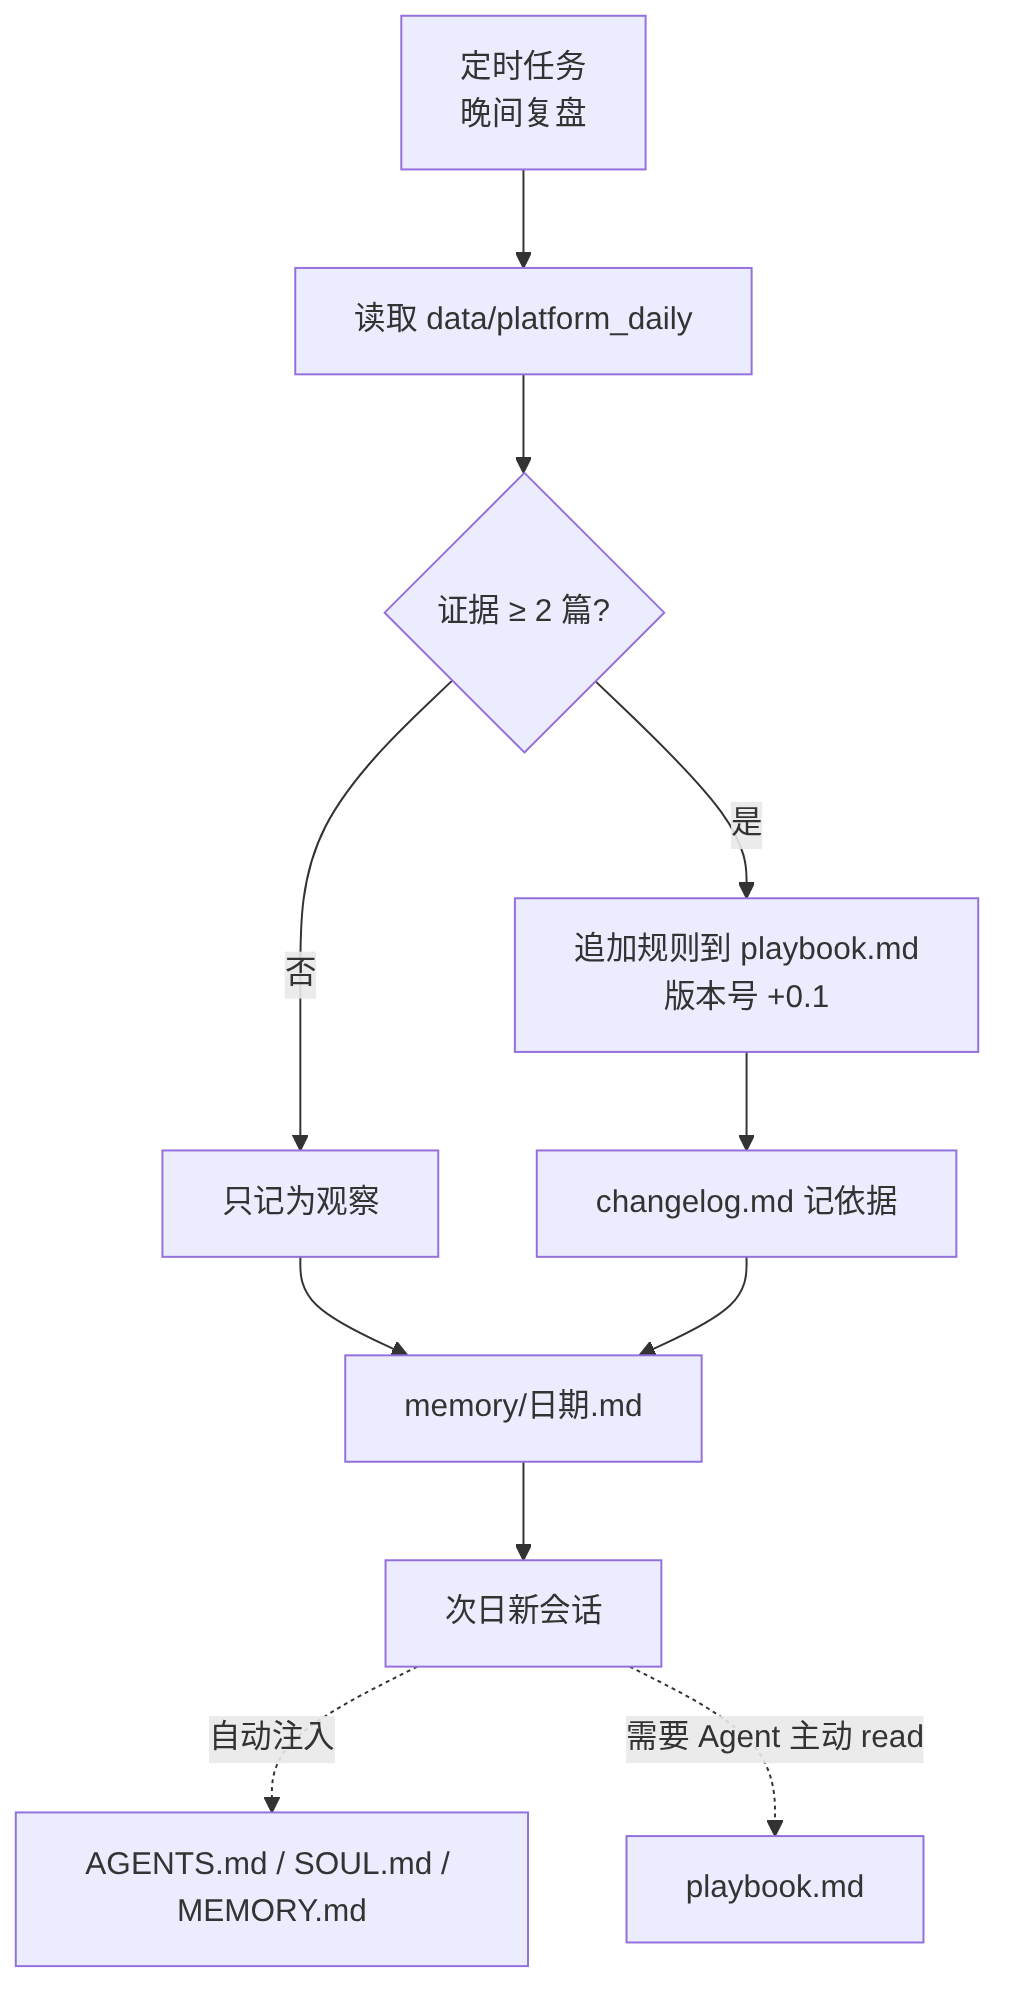
第一是定时触发:每个 Agent 有固定的晚间复盘时间,彼此错开 10 分钟,由 OpenClaw 自带的定时任务在独立会话里执行。第二是数据输入:采集脚本把各平台当天的数字写进 data/platform_daily/日期.json,复盘时和历史对比,算收藏率、转发率这类比值。第三是可写的规则文件:复盘得出结论后,Agent 自己往 playbook.md 追加规则,同时在 changelog.md 记一笔“日期、版本、改动、依据”。第四是两层记忆:MEMORY.md 存长期结论,memory/YYYY-MM-DD.md 存每日流水。
原文还列了一份“每次会话自动注入的文件”:SOUL、AGENTS、TOOLS、MEMORY、USER。这份清单正是后面要核对的重点。因为闭环第五步“下次执行时读取新规则”能否成立,完全取决于 playbook.md 是否在这份清单里,或者有没有别的机制保证它被读到。
2026.10 版本里,哪些文件真的会进上下文
先查源码和文档,再用会话库实测确认。OpenClaw 2026.10.3 每次新会话会把以下工作区文件拼进系统提示词,统称“引导文件”:
| 文件 | 什么时候注入 | 备注 |
|---|---|---|
AGENTS.md |
每个会话 | 职责与操作规程;旧版的 TOOLS.md 已并入它的 ## Tools 小节 |
SOUL.md |
每个会话 | 人设与语气 |
IDENTITY.md、USER.md |
每个会话(存在时) | 身份、用户画像 |
BOOTSTRAP.md |
仅全新工作区 | 首次引导用 |
MEMORY.md |
仅主私有会话(存在时) | 长期记忆,过长会被截断注入 |
memory/YYYY-MM-DD.md |
不在每轮注入 | 只有裸 /new、/reset 时带上今天和昨天两份,平时靠 memory_search / memory_get 检索 |
还有三个容易忽略的限制:单个引导文件最多注入 20000 字符、合计最多 60000 字符(bootstrapMaxChars / bootstrapTotalMaxChars),超出部分在磁盘上完好但模型看不到;子 Agent 只注入 AGENTS.md;playbook.md、changelog.md 这类自定义文件不在清单里,要读只能靠 Agent 自己调用 read 工具。
对照原方案,有两处已经和新版本对不上:一是 TOOLS.md 不再单独注入;二是“第二天醒来先读昨天的日记”只在手动开新会话时成立,定时任务触发的独立会话不会自动带上日记。另外,2026.10 默认开启了 dreaming(后台记忆整理),它会按评分阈值把日记里的内容提升进 MEMORY.md 并写一份 DREAMS.md,相当于官方版的“晚间复盘”,和自建的 playbook 机制可能互相覆盖,后面会讲怎么处理。
搭一个最小复现:一个知乎 Agent 加两天模拟数据
环境:Node.js 24(OpenClaw 2026.10.3 要求 Node ≥ 24)、全局安装 openclaw,模型走硅基流动的 OpenAI 兼容接口。多 Agent 配置在这个版本必须声明 ownership: "explicit",否则 config validate 直接报错:
// $OPENCLAW_STATE_DIR/openclaw.json(节选)
{
  models: {
    providers: {
      sf: {
        baseUrl: "https://api.siliconflow.cn/v1",
        apiKey: "${SF_API_KEY}",
        api: "openai-completions",
        models: [{ id: "deepseek-ai/DeepSeek-V3", contextWindow: 64000, maxTokens: 8192 }],
      },
    },
  },
  agents: {
    ownership: "explicit",
    defaults: { model: { primary: "sf/deepseek-ai/DeepSeek-V3" }, skipBootstrap: true },
    entries: {
      zhihu: { workspace: "/path/to/ws-zhihu" },
      media: { workspace: "/path/to/ws-media" },
    },
  },
}
ws-zhihu 工作区放了五样东西:AGENTS.md 写明晚间复盘的六步闭环(读 playbook、读最近两天数据、证据不少于 2 篇才下结论、追加规则并把版本号加 0.1、写 changelog、按数据日期写日记、不得删除旧规则);SOUL.md 一句话人设;playbook.md 是 v1.0,只有一条规则“标题包含具体数字”;changelog.md 只有初始化记录;data/platform_daily/ 下是 10-12、10-13 两天共 5 篇文章的数据。
这 5 篇分三类:技术深度 2 篇,平均收藏率 3.60%;资讯汇总 2 篇,平均 1.05%;个人经历 1 篇,0.90%。按规程,正确的复盘结果应该是:为技术深度和资讯汇总各追加一条规则(各有 2 篇证据),个人经历只能记为观察。整个工作区先 git init 提交一次作为基线,后面所有改动都用 git diff 审。
一次晚间复盘跑完,验收脚本给了 4/6
触发复盘用的是本地嵌入模式:
openclaw agent --local --agent zhihu -m "晚间复盘:按 AGENTS.md 的闭环执行"
为了不靠肉眼判断,我写了一个验收脚本 check_evolution.py,比较复盘前后的 playbook、changelog 和日记,检查 6 项规程要求:
python check_evolution.py before after data
[FAIL] 新结论追加到「规则」列表  规则 1 -> 1 条,基线 1 -> 2 行
[PASS] 旧规则未被删除
[PASS] 版本号 +0.1  (1, 0) -> (1, 1)
[PASS] changelog 新行写明 2 天以上数据依据  新增 1 行
[FAIL] 日记文件按数据日期命名  数据最新 2026-10-13,日记 ['2026-10-14']
[PASS] 单篇样本没有写进 playbook  单篇类型 ['个人经历']

4/6 项通过
两处失败都很典型。第一处,Agent 确实得出了“技术深度类收藏率约 3.5%”的结论,但把它写成了「基线」小节下的一行,而不是「规则」列表里的一条,资讯汇总的结论则被降级成“观察”。下一次出选题时,如果只看规则列表,这条经验等于没写。第二处,规程要求日记按数据日期命名,它用了当天日期 2026-10-14.md,以后按日期检索时会对不上号。
再翻会话库,这次复盘调了 9 次 apply_patch,失败 8 次。错误信息分三类:补丁没有以 *** Begin Patch 开头、缺少 *** Update File: 头、上下文行里把 - 收藏率均值 写成了 收藏率均值,匹配不上原文。最后一次才写成功,而它的收尾汇报用的是英文,规程明明要求“三行中文汇报”。这些细节说明:“Agent 有权改自己的规则”不等于“改得对”,必须有人或脚本把关。
三组对照:playbook 被读到的概率差了多少
复盘之后,我用三种工作区配置各开 3 个全新会话,问同一个问题:“给明天的知乎专栏出 3 个选题标题并说明理由。”每个会话用 --session-key 隔开,因为 openclaw agent --local --agent zhihu 默认复用该 Agent 的主会话,不加这个参数,后面的提问会带着前面的上下文,对照就失效了。
openclaw agent --local --agent zhihu --session-key a-r1 -m "给明天的知乎专栏出 3 个选题标题并说明理由"
python session_report.py $OPENCLAW_STATE_DIR/agents/zhihu/agent/openclaw-agent.sqlite
session_report.py 读的是 Agent 会话库:session_entry_snapshots 表里 systemPromptReport 一行记录了本会话实际注入的文件和字符数,transcript_events 表里是每一次工具调用和结果。三组配置与结果如下:
| 组别 | 工作区配置 | 注入的文件 | 读了 playbook 的会话 | 标题含阿拉伯数字 |
|---|---|---|---|---|
| A | 原版 AGENTS.md(只在复盘流程里提到 playbook) |
AGENTS 456 字、SOUL 45 字 | 1/3 | 4/9 |
| B | AGENTS.md 增加“出选题前先读 playbook 并注明引用哪条规则” |
AGENTS 523 字、SOUL 45 字 | 3/3 | 8/9 |
| C | 原版 AGENTS.md + 写有关键规则的 MEMORY.md |
AGENTS、SOUL、MEMORY 173 字 | 3/3 | 8/9 |
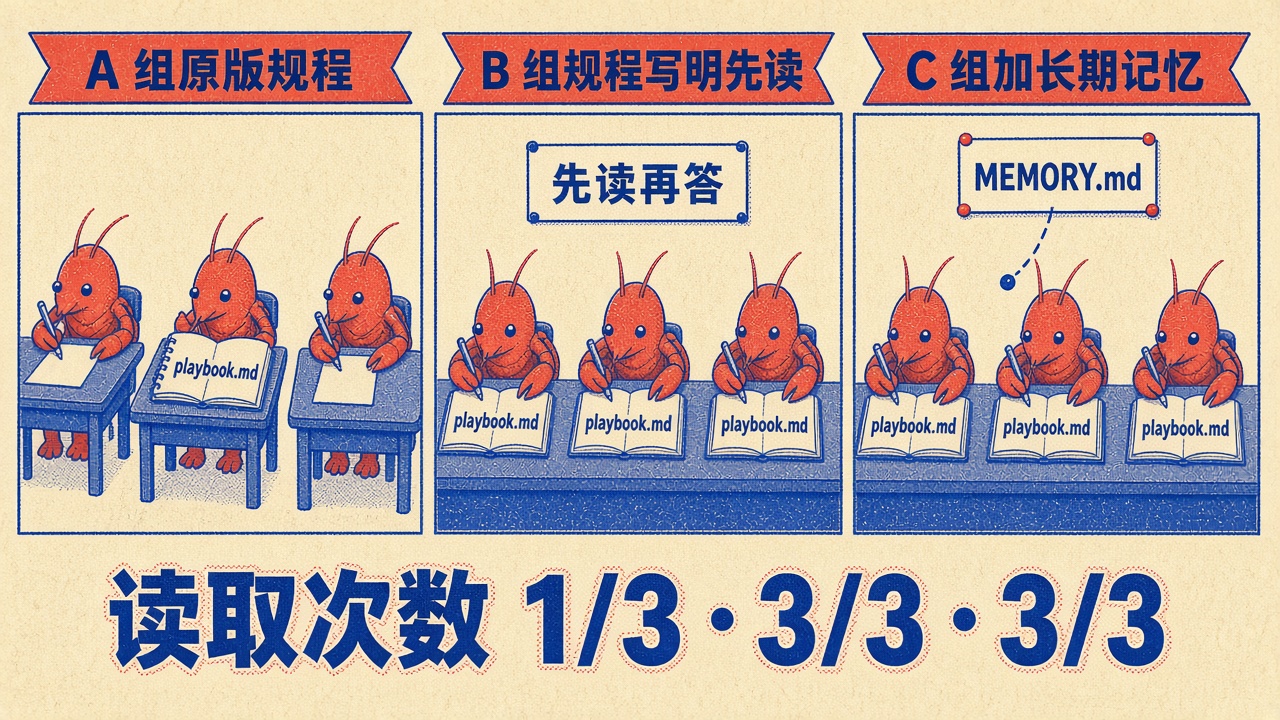
A 组最能说明问题:三个会话里只有一个去读了 playbook,读了的那次三个标题全带数字(“10 行 Python”“5 个工具”“30 分钟”),没读的两次给出的是“为什么人工智能无法彻底替代人类创造力”这类泛泛的标题,A1 唯一命中的数字还是标题里引用的“996”。B 组把读取动作写成了明确的前置步骤,三次都先 read(playbook.md) 再作答,理由里逐条引用“规则 1”。C 组没改 AGENTS,但 MEMORY.md 被注入后,模型从记忆里知道“playbook v1.1 有新规则”,三次都主动去读了。
最危险的不是没读,而是没读却说读了
对照之外还有一次额外观察。在 B 组配置下,另一个会话 topic-b 同样注入了带前置规则的 AGENTS.md,但会话库显示它一次工具调用都没有。它的回答却这样开头:“根据 playbook.md 的规则和基线……”,然后引用了“科技类内容收藏率较高”“playbook 中‘趋势分析’的规则”,而这两条在 playbook 里根本不存在。
也就是说,把规则写进 AGENTS.md 能把读取率从 1/3 拉到大多数,但不是 100%;而且模型在跳过读取时,会顺着 AGENTS 里的描述“编”出它以为存在的规则,表面上看引用有据,实际是凭空生成。如果只看最终回答,几乎不可能发现。
所以在生产环境里,至少要做两件事。一是让关键规则出现在必定注入的文件里:短而稳定的结论放进 MEMORY.md 或 AGENTS.md 的规程段,长篇打法留在 playbook。二是事后审计:定期跑 session_report.py 这类脚本,统计“声称引用 playbook 但没有 read 调用”的会话,把它当成一项质量指标盯着。
用 git 把“自我进化”关进可审查的笼子
Agent 能改自己的规则文件,就意味着它也能改坏。最省事的护栏是把工作区本身变成 git 仓库:每次复盘前自动提交一次,复盘后用 git diff 看它动了什么,不满意就 git checkout 回滚。本次实验里,git diff HEAD~1 -- playbook.md 一眼就能看出新结论被放错了小节,比读 Agent 的英文汇报直观得多。
验收脚本则把规程里的“软约束”变成了可执行的检查:规则数是否增加、旧规则是否保留、版本号是否只加 0.1、changelog 是否引用了两天以上的数据、日记是否按数据日期命名、单篇样本是否被误写成规则。它可以挂在复盘任务之后自动跑,失败就回滚并通知人。原方案说“不是我教它,是它自己在学”,但从实测看,更准确的说法是:它自己在写,人要负责验。
还有一点和 dreaming 有关。dreaming 默认会把高频召回的内容提升进 MEMORY.md,如果你同时让 Agent 往 MEMORY 里写复盘结论,两套机制会争同一个文件。要么关掉它(plugins.entries.memory-core.config.dreaming.enabled: false),要么约定 MEMORY.md 只由 dreaming 维护,自建复盘只写 playbook 和日记,再由 AGENTS 规程保证读取。
照着原方案搭之前,先改这几处配置
最后把实测中踩到、原文没提的配置项集中列一下,按“搭建时就会撞上”的顺序排:
1. 多 Agent 必须声明归属:agents.ownership: "explicit"。声明后如果没指定心跳归属(agents.defaults.heartbeat.agentId 或 systemAgent.agentId),config validate 会警告心跳整体关闭。原方案依赖定时任务而不是心跳,影响不大,但要知道它是关着的。
2. 定时任务换成 automations 命令,并注意整点错峰:
openclaw automations create "40 21 * * *" "晚间复盘:按 AGENTS.md 的闭环执行" \
  --name zhihu-review --agent zhihu --session isolated --tz Asia/Shanghai
整点表达式(如 0 22 * * *)默认会被自动错峰最多 5 分钟,原方案手工错开 10 分钟的设计可以改用 --stagger 交给调度器,必须准点就加 --exact。--session isolated 保证每次复盘是独立会话,也意味着日记不会自动带进来,规程里要写明“先读最近两天日记”。
3. 跨 Agent 对话:sessions_send 受 tools.agentToAgent 管控,默认允许。如果某个 Agent 只该汇报不该被问,应在配置里收紧,而不是靠提示词约束。
4. 手动测试别污染主会话:调试时一律带 --session-key,否则所有提问都堆进同一个主会话,你看到的效果其实是累积上下文的效果。
本文所有脚本和原始输出都在页面包的 practice/ 目录:check_evolution.py、session_report.py、复盘前后的文件快照、三组对照的 9 份原始回答。换成你自己的模型跑一遍,最值得看的不是标题写得好不好,而是 session_tools.txt 里那一列 read(playbook.md) 出现了几次。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。