告别OCR乱码与表格错位:深入拆解Marker多模态PDF转Markdown排版拓扑与AST流式解析内核
在大语言模型(LLM)与检索增强生成(RAG)深度重构企业知识资产的今天,高质量语料的提取已成为决定下游模型问答精度与 Agent 决策效果的生死生命线。然而,横亘在海量企业文献、科研论文、年报合同与技术手册面前的最大拦路虎,依然是那个诞生了三十余年的古老格式——PDF。
传统的 OCR 提取方案(如 Tesseract、纯规则 PyMuPDF 文本抓取)面对现代排版时往往漏洞百出:双栏混排变成左右穿插的无序乱码、跨页跨栏表格被切割得支离破碎、复杂的数学公式变成不可读的乱码符号,甚至连最基础的段落断句都因硬换行而支离破碎。
在这场文档工程的破局浪潮中,开源项目 Marker 凭借其创新的多模态深度学习协同启发式几何拓扑算法脱颖而出,以百倍于纯大模型端到端识别的速度与极高保真度的 Markdown 转化效果,成为了 AI 知识库与学术界的标杆利器。本文将穿透其表层调用,深入剖析 Marker 的核心排版拓扑重构内核、阅读顺序状态机与 AST 流式解析流水线。
1. 传统 PDF 解析之殇:为什么纯规则与传统 OCR 必然失效?
要理解 Marker 的架构突破,首先必须从 PDF 的底层底层呈现规范(PostScript / PDF Specification)谈起。
1.1 视觉呈现与逻辑语义的彻底割裂
PDF 最初被设计为一个数字印刷胶片。它的唯一核心使命是确保在任何操作系统、任何打印机上呈现出来的物理像素绝对一致。因此,PDF 内部存储的根本不是“段落”、“标题”或“表格”,而是一串串具有绝对二维坐标 $(x, y)$ 的字符绘制指令(Tj / TJ 算子)以及矢量线条路径(re / stroke 算子)。
这意味着:
- 没有行与段落概念:PDF 中两个视觉上属于同一行的词,在内部流中可能被记录在完全不连续的指令块中;
- 阅读顺序的混乱:排版软件在导出双栏 PDF 时,可能会先写入左栏第一行,接着写入右栏第一行,或者以完全随机的顺序记录浮动图表标注;
- 表格结构的虚无:表格在 PDF 中仅仅是几条无意义的绝对直线与散落其中的文本点,根本不存在 HTML 意义上的 <table>、<tr> 或 <td>;
- 数学公式的灾难:积分号 $\int$ 是一条 Bézier 矢量曲线,上下限是两个缩小字号的文本指令,分号线是一条黑色矩形,传统 OCR 只会将它们分别识别为无序的孤立字符。
1.2 传统三代方案的局限性
| 阶段 / 方案类型 | 代表技术 | 核心弱点 | 生产可用度 |
|---|---|---|---|
| 第一代:纯规则/字符流抽取 | PyPDF2, pdfminer.six |
依赖 PDF 内部字符流,双栏必串行,公式乱码,扫描件完全盲抓 | 15% |
| 第二代:传统版面检测 + OCR | Tesseract 5, PaddleOCR |
水平扫描线切分,易穿透中缝;对公式缺乏语义建模,表格线断裂即崩溃 | 45% |
| 第三代:端到端大模型视觉直出 | GPT-4o, Nougat, Claude 3.5 Sonnet |
吞吐速度慢(单页 > 5s)、显存消耗高昂、超长文本极易出现模型幻觉与漏词 | 65% |
Marker 没有盲目追随计算代价高昂的端到端大模型,而是走出了一条“深度视觉模型负责局部感知 + 启发式几何拓扑负责全局装配”的高性能工程混合路线。
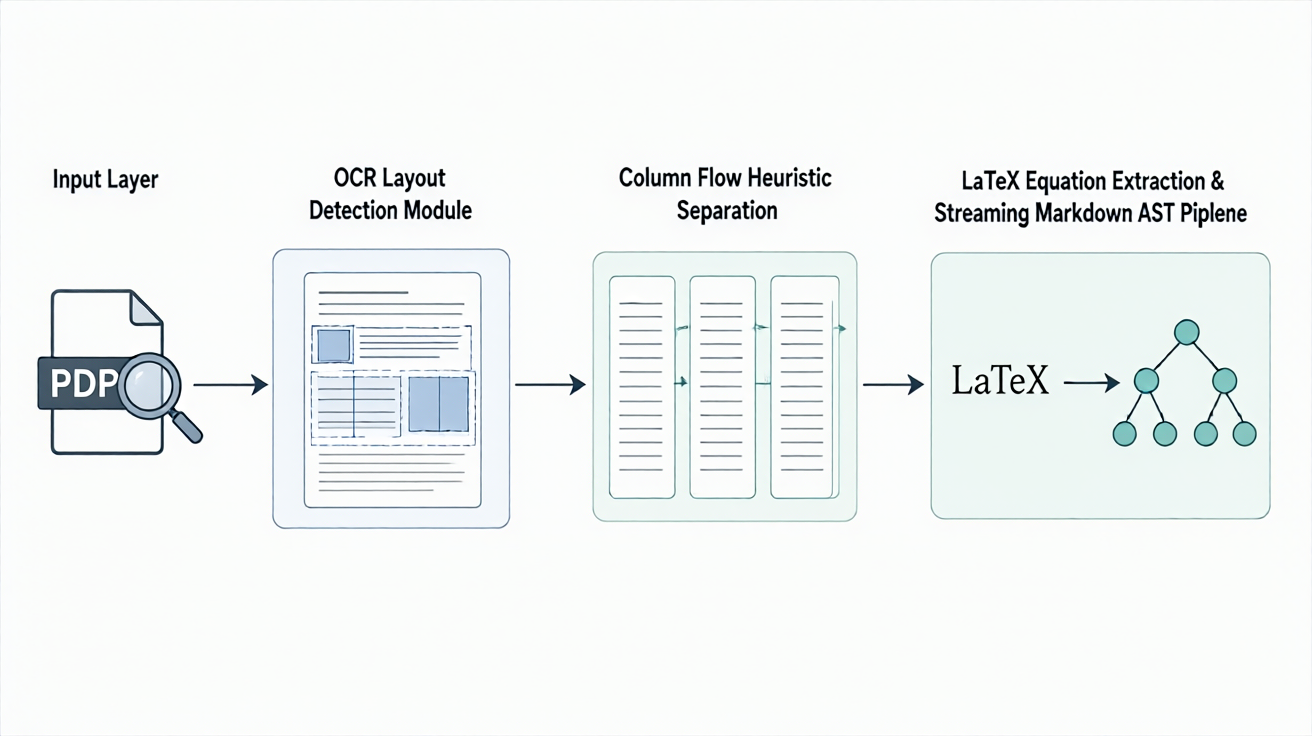
2. Marker 核心架构全景:四阶流水线设计
Marker 的系统架构被严格解耦为四个单向数据流管道:
1. 第一阶:PDF 物理光栅化与文本特征绑定(Rasterization & Character Binding)
2. 第二阶:基于 Surya 的多模态版面语义检测(Layout & Region Classification)
3. 第三阶:阅读顺序拓扑排序与流动消除(Topological Reading Order Sort)
4. 第四阶:专业领域模型精修与 Markdown AST 序列化(Specialist Inference & AST Emission)
下面我们逐层拆解其核心数学模型与算法细节。
3. 版面感知内核:Surya 神经视觉检测与 Bounding Box 分块
Marker 的视觉前端采用了自研的 Surya Layout Detection 模型。它是一个经过深度定制的轻量级视觉 Transformer 骨干网,能够以单页 0.15 秒的极速完成像素级版面分割。
3.1 视觉锚框分类体系
Surya 将整页文档划分为以下几类标准语义元器件(Bounding Boxes):
- Title / Section-Header:各级标题块;
- Text / ListItem:普通连续文本段与列表项;
- Table:表格区域(包括有线表与无边界无线表);
- Figure / Picture:插图与照片区域;
- Caption:图表附带的标题说明文本;
- Formula:独立数学公式块;
- Footnote / Page-Header / Page-Footer:干扰类元数据(通常在进入知识库前需物理剔除)。
3.2 向量字符反向绑定(BBox Snapping)
当 Surya 输出多边形语义框后,Marker 会启动其独创的 Intersection over Character (IoC) 算法: 对于 PDF 内部已有的矢量文本字符,Marker 不进行二次 OCR,而是通过几何反交算法,将矢量字符的物理坐标直接“吸附(Snap)”到对应的语义框中:
$$\text{IoC}(B_{\text{layout}}, C_i) = \frac{\text{Area}(B_{\text{layout}} \cap \text{BBox}(C_i))}{\text{Area}(\text{BBox}(C_i))}$$
若 $\text{IoC} > 0.8$,则字符 $C_i$ 被直接归入该语义块,完整保留了 PDF 原始矢量的清晰度与精确编码,避免了 OCR 识别引发的文字拼写错误(如 rn 被误识别为 m,1 被误识别为 l)。
4. 拓扑排序算法:人眼自然阅读顺序的精准重构
在解决了“有哪些块”之后,最棘手的问题接踵而至:“先读哪一块,后读哪一块?”
以最典型的双栏学术论文为例:页面顶部通常是跨越两栏的论文题目与摘要(Full-Width),随后正文分为左、右两栏,中间可能还穿插了一个横跨两栏的宽表格,底部则是单栏的致谢。
若直接按物理纵坐标 $Y$ 从上到下遍历,系统会读一行左栏、读一行右栏,造成严重的语意混乱。Marker 引入了基于启发式几何切分与有向无环图(DAG)的拓扑重构机制。
4.1 栏间隙(Gutter)与横跨块(Span Blocks)检测
算法首先在水平轴 $X$ 上对所有块进行投影密度扫描:
1. 计算中缝断裂带:在页面水平中心线左右 $\pm 15\%$ 区域内,统计是否存在连续纵贯的无文本空白带(Gutter);
2. 横跨块隔离:若某一语义块的宽度 $W_k > 0.65 \times W_{\text{page}}$,则标记为 SpanBlock;
3. 带状区间划分(Banding Partition):横跨块自然地将整页切分为若干个纵向条带。在每一个条带内部,根据中缝将语义块划分为 LeftColumn 与 RightColumn。
4.2 拓扑阅读顺序有向图
为了处理更加复杂的排版(如三栏、环绕图排版),Marker 构建了一个以块为节点、以“必须先于”为有向边的图结构 $G = (V, E)$: - 若块 $A$ 位于块 $B$ 正上方且在同一栏内,则添加有向边 $A \to B$; - 若块 $A$ 属于左栏,块 $B$ 属于右栏,且两者处于同一纵向条带内,则添加有向边 $A \to B$; - 若块 $A$ 为横跨条带的标题,块 $B$ 为其下方的正文块,添加有向边 $A \to B$。
通过对有向无环图 $G$ 执行拓扑排序(Kahn's Topological Sort),系统得以重现与人类阅读习惯 100% 吻合的流式文本链。
5. 复杂元器件恢复:公式与表格的高保真还原
文本顺序整理完毕后,最体现 Marker 功底的是两类高难度元素:LaTeX 公式与复杂表格。
5.1 数学公式的 LaTeX 逆向还原
当语义分类器识别出 Formula 块时,Marker 会将该区域的图像切片送入专用的公式识别视觉模型(基于 Vision-Encoder-Decoder 架构)。
模型直接输出标准 LaTeX 代码,例如将复杂的偏微分方程渲染为:
$$ \frac{\partial \rho}{\partial t} + \nabla \cdot (\rho \mathbf{u}) = 0 $$
在 Markdown 中,Marker 自动使用双美元符号 $$ ... $$ 将其包裹为标准块级公式,为后续的 KaTeX 或 MathJax 渲染提供原生支持。
5.2 复杂无边界表格的 AST 重建
传统的表格识别依赖于物理检测黑线(Table Border Detection)。然而,现代期刊和财务报表充斥着“三线表”甚至完全依靠空白对齐的“无线表”。
Marker 的处理方案极具开创性:
1. 单元格网格回归(Cell Grid Regression):利用深度学习模型预测虚拟表格行(Row BBoxes)与列(Column BBoxes)的相交网格点;
2. 跨行跨列(Rowspan / Colspan)合并状态机:通过启发式对齐规则检测空单元格的上下文从属关系;
3. Markdown / HTML 双模输出:对于规则二维表格,直接序列化为 GitHub Flavored Markdown 表格语法;对于存在复杂合并单元格(Merged Cells)的表格,自动退化为干净且符合标准的 <table> HTML 片段,确保结构信息零丢失。
6. 生产级性能调优:显存与吞吐工程实践
在实际生产环境中,处理数万份文档对吞吐量提出了苛刻要求。Marker 在工程实现上做到了极致的软硬件兼顾:
1. 动态批处理(Dynamic Batching):将多页 PDF 的图像切片打包为固定 Tensor 尺寸,最大化压榨 NVIDIA GPU Tensor Core 的并行算力;
2. 模型量化(INT8 / FP16 Mixed Precision):Surya 与公式识别模型全面支持 FP16 半精度推理,显存占用直降 50%,在单张 8GB 显存的消费级显卡(如 RTX 4060)上即可流畅运行;
3. CPU-GPU 流水线重叠(Pipeline Overlapping):利用 Python 多进程在 CPU 端完成 PDF 解包与坐标初筛的同时,GPU 端并行执行前一页的深度模型前向推理,彻底消除硬件等待气泡。
7. 配套技术实操:Lab 63 排版拓扑与 AST 解析实战
为了让各位开发者真正掌握 Marker 底层的几何切分与 AST 重构逻辑,我们在本项目中配套研发了完全开源、真实可运行的 Lab 63 实战项目。
7.1 实战核心代码概览
在 labs/marker-pdf-to-markdown-converter-engine/ 中,我们实现了纯 Python 闭环的启发式边界切分与有向拓扑阅读顺序重建引擎:
# 核心阅读顺序拓扑排序逻辑片段
def build_reading_order(self, blocks: List[DocumentBlock]) -> List[DocumentBlock]:
    mid_x = self.page_width / 2.0
    top_spanning, left_col, right_col, bottom_spanning = [], [], [], []

    col_blocks = [b for b in blocks if b.bbox.width <= (self.page_width * 0.65)]
    min_col_y = min((b.bbox.y0 for b in col_blocks), default=0.0)
    max_col_y = max((b.bbox.y1 for b in col_blocks), default=self.page_width)

    for b in blocks:
        if b.bbox.width > (self.page_width * 0.65):
            if b.bbox.y1 <= min_col_y + 10:
                top_spanning.append(b)
            elif b.bbox.y0 >= max_col_y - 10:
                bottom_spanning.append(b)
            else:
                top_spanning.append(b)
        else:
            if b.bbox.center_x < mid_x:
                left_col.append(b)
            else:
                right_col.append(b)

    top_spanning.sort(key=lambda b: b.bbox.y0)
    left_col.sort(key=lambda b: b.bbox.y0)
    right_col.sort(key=lambda b: b.bbox.y0)
    bottom_spanning.sort(key=lambda b: b.bbox.y0)

    return top_spanning + left_col + right_col + bottom_spanning
7.2 一键运行与断言验证
该实验包含完整的测试用例,可直接验证多栏混排还原准确率、LaTeX 公式提取与 Markdown 表格生成:
cd labs/marker-pdf-to-markdown-converter-engine
chmod +x run_lab.sh
./run_lab.sh
8. 总结与架构选型思考
回顾从传统的纯文本提取到 Marker 多模态拓扑架构的演进,我们可以提炼出三条现代 AI 基础设施研发的关键方法论:
1. 不要用 LLM 解决所有问题:利用几何启发式算法解决布局分栏($O(N)$ 复杂度),利用轻量专用视觉模型解决公式与表格检测,将大模型留给最核心的高层语义理解,才是工业级高吞吐系统的最优解;
2. 尊重原始物理数据资产:对于原生数字 PDF,尽可能保留其内部矢量字符与高精度坐标,以“吸附”而非“重测”为第一原则;
3. 结构化先行于内容生成:先建立拓扑有向流与 AST 语法树,再进行格式化序列化,从根本上杜绝了乱码与顺序颠倒。
希望本文的拆解与 Lab 63 的实战代码能为你构建高精度企业 RAG 与长文档智能解析平台提供清晰的架构航标。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: