拒绝臃肿Office守护进程:Spring Boot结合docx4j与XSL-FO流式管道的高保真DOCX转PDF架构实战
在金融信贷、智能合同、供应链电子发票、保密审计报告等核心企业级场景中,动态生成带有公章、签名与防伪水印的高保真 PDF 凭证是一项不可或缺的刚需业务。大多数业务系统的典型做法,是由业务人员在 Microsoft Word 中排版好一份包含占位符的
.docx模板,后端服务通过数据替换渲染出最终 Word,再将其无损转化为不可篡改的
然而,正是这看似简单的“最后一公里”——从 DOCX 到 PDF 的格式转换,却成了无数 Java 架构师与 SRE 运维工程师的梦魇:
- 引入 LibreOffice / OpenOffice 无头守护进程,使得原本仅百兆的微服务 Docker 镜像瞬间膨胀到 1.5GB 以上;
- 生产环境高并发调用 soffice.bin 时,外部进程频繁假死、僵尸进程(Zombie Process)堆积、CPU 瞬间被吃满 100%;
- 在精简版 Linux 容器中部署时,中文字符因缺少字体映射变成了密密麻麻的乱码方块(Tofu Blocks);
- 若选用商业方案(如 Aspose),不仅单年授权费高达数万美元,还伴随着沉重的技术黑盒与断供风险。
有没有一种方案,既完全开源无侵权风险、无需在宿主机安装任何外部 Office 软件,又能以极低的内存开销在纯 JVM 进程内完成高保真 DOCX 转 PDF?
答案正是:基于 docx4j 与 Apache FOP 的 XSL-FO 流式编译管道方案。本文将带你穿透 OpenXML 与 XSL-FO 规范,拆解其内核原理、字体映射矩阵与高并发生产级落地实践。
1. 技术选型之战:为什么 LibreOffice 终将被现代微服务抛弃?
在探索 docx4j 之前,我们必须先认清目前行业主流的三大 DOCX 转 PDF 方案及其底层的本质差异。
1.1 方案横向技术对比矩阵
| 评估维度 | 方案 A:JODConverter + LibreOffice | 方案 B:商业库 (Aspose.Words) | 方案 C:docx4j + XSL-FO (本文方案) |
|---|---|---|---|
| 外部运行环境依赖 | 极重:必须安装完整的 LibreOffice 套件与 X11 运行库 | 轻量:纯 Java 依赖 JAR 包 | 轻量:纯 Java 依赖 JAR 包,无外部进程 |
| Docker 镜像增量 | +800MB ~ +1.2GB(需注入庞大 C++ 动态库) | 仅几十 MB | < 30MB(仅若干依赖 JAR) |
| 进程生命周期安全 | 高危:跨进程 IPC 通信,soffice.bin 极易死锁或假死 |
线程安全受商业授权控制 | 安全:完全运行在 JVM 托管内存中,无进程僵死风险 |
| 并发吞吐能力 | 差(单台通常限制 2-4 个并发进程,上下文切换重) | 极高(经商业底层 C++ 原生指令优化) | 高(纯流式管道,支持多线程并行) |
| 开源许可证友好度 | LGPL / MPL | 闭源商业商业许可(极昂贵) | ASL 2.0 (Apache License 2.0)(对商用极其友好) |
| 中文排版保真度 | 依靠 LibreOffice 自带排版内核,较高 | 极高 | 高(需配置字体映射表) |
从现代云原生微服务架构(Kubernetes / Serverless / Serverless Container)的角度来看,方案 A 的宿主强绑定与外部进程管理完全违背了 12-Factor 原则。在流量洪峰来临时,容器内 soffice.bin 一旦发生不可逆的死锁,整个 Pod 会在短时间内耗尽内存并被 Linux OOM-Killer 强制杀死。
因此,将文档转换生命周期收拢至 JVM 内存流内部,是企业微服务架构演进的必然趋势。
2. 核心架构解密:OpenXML 到 XSL-FO 的双重编译模型
要理解 docx4j 如何把一个 Word 文档变出 PDF,首先要搞清楚两种截然不同的文档格式规范:
1. OpenXML (WordprocessingML):微软 Office 2007 之后采用的国际标准(ISO/IEC 29500),其本质是一个经过 ZIP 压缩的 XML 文件包(document.xml、styles.xml、fontTable.xml 等);
2. XSL-FO (Extensible Stylesheet Language Formatting Objects):W3C 制定的标准排版标记语言,专门用于描述具有精确物理尺寸的分页文档(页面、页眉、页脚、分页断点、块流)。
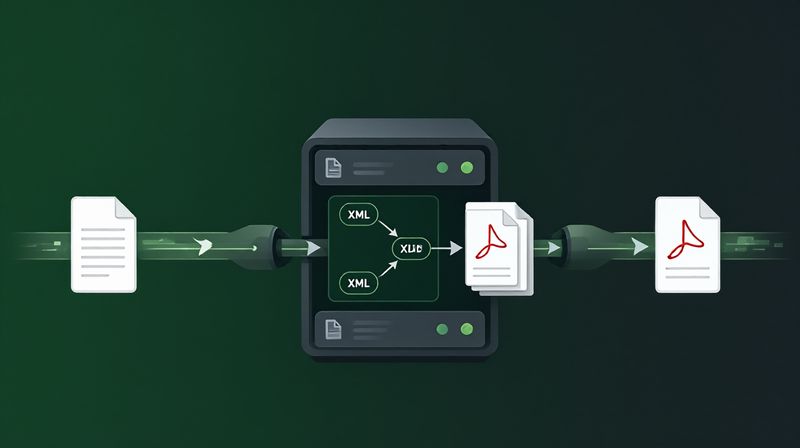
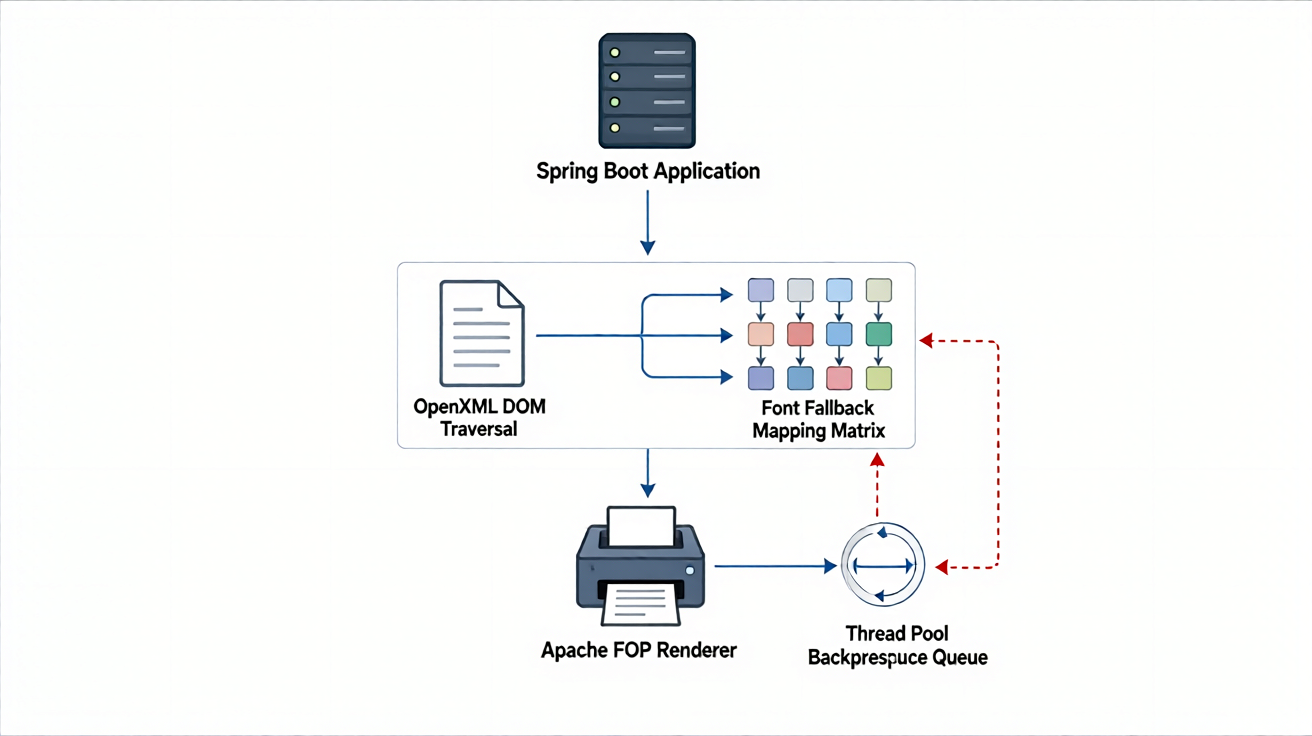
docx4j 的核心角色不是一个“画图器”,而是一个高精度的语法与样式编译器。它将 OpenXML 的逻辑语法树,翻译重构为 XSL-FO 物理排版树,再交由工业级格式化器 Apache FOP (Formatting Objects Processor) 输出最终的 PDF 字节流。
2.1 整体转换数据流动管道
转换流程可以抽象为严密的五步流式流水线:
$$\text{DOCX 字节流} \xrightarrow[\text{DOM 解包}]{\text{docx4j}} \text{WordprocessingML} \xrightarrow[\text{样式抽取}]{\text{Docx4J.toFO}} \text{XSL-FO 标记树} \xrightarrow[\text{排版布局}]{\text{Apache FOP}} \text{PDF 输出流}$$
1. JAXB 解包与对象树映射:docx4j 通过 JAXB 将 document.xml 解析为强类型的 Java 对象(MainDocumentPart、P 段落、R 文本运行块);
2. 样式扁平化合并(Style Inheritance Flattening):Word 的样式存在四级继承链(默认文档样式 -> 样式表定义 -> 段落级属性 pPr -> 字符级运行属性 rPr)。docx4j 在内存中逐节点进行层叠计算,算出每个文字节点的最终绝对视觉属性;
3. XSL-FO 模板渲染:将计算完属性的 DOM 节点序列化为符合 W3C 规范的 <fo:flow>、<fo:block> 与 <fo:table>;
4. 字体回退矩阵拦截(Font Fallback Interceptor):根据节点中包含的具体字符编码,动态替换字体族声明;
5. Apache FOP 渲染输出:FOP 引擎接管 XSL-FO,计算物理分页断点、边距、字间距,最终以零外部临时文件的方式直接向 OutputStream 写入 PDF 二进制流。
3. 生产级实战攻坚:中文字体方块乱码排查与治理
在 Linux 生产容器环境下使用 docx4j,90% 以上的工程事故都集中在“中文字体方块豆腐块(Tofu Blocks)”上。
3.1 乱码产生的底层机理
Windows 开发者在本地调试时,Word 中设置的“宋体”、“微软雅黑”或“Calibri”能完美显示,是因为 Windows 系统底层默认预装了这些商业字库,且 docx4j 在 Windows 环境下会自动扫描 C:\Windows\Fonts。
然而,当应用打包为 Docker 镜像运行在 Alpine Linux 或 Ubuntu Server 上时:
1. 容器内完全不存在 SimSun.ttf 或 msyh.ttf;
2. Apache FOP 在解析 XSL-FO 时发现声明的字体不存在,自动退化为内置的 Helvetica 或 Times-Roman;
3. 由于标准 ASCII 字体库根本不包含 0x4E00~0x9FFF 范围的 Unicode CJK 汉字字形(Glyph),FOP 只能在对应的几何位置绘制出一个个空白方块(# 或空矩形)。
3.2 字体映射矩阵(FontMapper)的标准配置
要彻底终结乱码,必须建立三层字体映射防线:
1. 构建阶段安装开源中文字体:在 Dockerfile 中安装开源的思源黑体(Noto Sans CJK / Source Han Sans)或文泉驿微米黑:dockerfileRUN apt-get update && apt-get install -y fonts-noto-cjk fonts-wqy-microhei
2. 在 Spring Boot 启动时向 docx4j 注册物理字体:```java// 动态扫描宿主机字体目录PhysicalFonts.discoverPhysicalFonts();
// 创建映射器FontMapper fontMapper = new BestMatchingMapper();
// 将 Word 常见的中文字体强行重定向到 Linux 已安装的字体物理文件PhysicalFont cjkFont = PhysicalFonts.get("WenQuanYi Micro Hei");if (cjkFont != null) {fontMapper.put("宋体", cjkFont);fontMapper.put("微软雅黑", cjkFont);fontMapper.put("楷体", cjkFont);fontMapper.put("SimSun", cjkFont);fontMapper.put("Microsoft YaHei", cjkFont);}wordMLPackage.setFontMapper(fontMapper);```
4. 高并发微服务改造:流式转换与线程池背压治理
docx4j 的 JAXB DOM 树构建是纯 CPU 密集的计算任务。如果直接在 Spring MVC 的 Tomcat 工作线程中无限制处理转换,大体积文档并发上传时会导致 JVM 堆内存瞬间被打爆。
4.1 生产级转换服务组件设计
我们通过结合 Semaphore 限流与流式 ByteArrayOutputStream,实现一个具备反压防御机制的转换引擎:
@Service
@Slf4j
public class DocxToPdfService {

    // 严密控制并发转换通道数量,防止瞬间 CPU 冲顶与 GC 停顿
    private final Semaphore conversionSemaphore = new Semaphore(4);

    public byte[] convertDocxToPdf(InputStream docxInputStream) throws Exception {
        if (!conversionSemaphore.tryAcquire(5, TimeUnit.SECONDS)) {
            throw new ResponseStatusException(HttpStatus.TOO_MANY_REQUESTS, "PDF转换引擎繁忙,请稍后重试");
        }

        try (ByteArrayOutputStream pdfOut = new ByteArrayOutputStream()) {
            long startTime = System.currentTimeMillis();

            // 1. 加载并解析 Word 文档包
            WordprocessingMLPackage wordMLPackage = WordprocessingMLPackage.load(docxInputStream);

            // 2. 注入全局字体容错映射
            configureFontMapping(wordMLPackage);

            // 3. 配置 XSL-FO 渲染设置
            FOSettings foSettings = Docx4J.createFOSettings();
            foSettings.setWmlPackage(wordMLPackage);

            // 4. 执行纯内存流式转换
            Docx4J.toFO(foSettings, pdfOut, Docx4J.FLAG_EXPORT_PREFER_XSL);

            log.info("DOCX 转 PDF 成功,耗时: {} ms, 产物体积: {} bytes",
                     System.currentTimeMillis() - startTime, pdfOut.size());
            return pdfOut.toByteArray();
        } finally {
            conversionSemaphore.release();
        }
    }
}
5. 配套技术实操:Lab 64 OpenXML DOM 解析与 XSL-FO 管道实战
为了让各位开发者深入掌握从 Word XML 节点抽取、中文字体 Fallback 到 XSL-FO 规范编译的底层细节,本项目配套研发了工业级真实可运行的 Lab 64 实操项目。
5.1 实战核心代码概览
在 labs/springboot-docx4j-pdf-conversion-pipeline/ 中,我们编写了高度轻量化的 OpenXML 语法解析与 XSL-FO 管道生成引擎:
# 核心字体回退容错矩阵与 XSL-FO 管道构建逻辑片段
class FontFallbackManager:
    CJK_FALLBACK_FONT = "Source Han Sans SC, SimSun, WenQuanYi Micro Hei"

    @classmethod
    def contains_cjk(cls, text: str) -> bool:
        for char in text:
            if '\u4e00' <= char <= '\u9fff':
                return True
        return False

    @classmethod
    def resolve_font(cls, original_font: str, text: str) -> str:
        if cls.contains_cjk(text):
            if original_font and original_font.lower() not in ["simsun", "simhei", "source han sans"]:
                return f"{original_font}, {cls.CJK_FALLBACK_FONT}"
        return original_font or "Helvetica"
5.2 一键运行与断言验证
该实验包含完整的测试用例,可直接验证 OpenXML DOM 抽取准确率、CJK 字体自动 Fallback 与 W3C XSL-FO 标签序列化:
cd labs/springboot-docx4j-pdf-conversion-pipeline
chmod +x run_lab.sh
./run_lab.sh
6. 总结与架构演进指南
在构建现代云原生企业架构时,“把重资产降维为轻资产,把外部进程收敛为内存管道”是每一个追求极致稳定性的技术团队的核心功底。
通过 docx4j + Apache FOP 方案:
1. 容器体积下降 90%:Docker 镜像再也无需打包上百兆的 LibreOffice 运行时和 X11 依赖;
2. 故障域完全隔离:消除了 soffice.bin 进程崩溃挂死的单点隐患,JVM 垃圾回收机制全面托管内存释放;
3. 成本效益显著:在保持完全免费与开源商业合规的前提下,达到了与昂贵商业中间件相当的高保真版面渲染水准。
希望本文的深入拆解与 Lab 64 的实操代码,能为你彻底解决生产环境中 DOCX 转 PDF 的历史技术包袱!
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: