

仓库索引才是底盘:Cursor 如何检索、同步并装配上下文
本站写过一篇「扒完 Cursor 系统 Prompt」的拆解:那套 500 行约束讲的是 Agent 怎么说话、怎么用工具、怎么停手。很多人读完就以为「会写提示词 = 会懂仓库」。错了。
打开一个五万文件的 monorepo,用自然语言问「支付失败后重试写在哪」,半秒内被指到正确模块——这件事跟 Prompt 文采几乎无关。模型上下文装不下整仓,grep 全扫又会把对话卡死。真正干活的是一套仓库索引 + 增量同步 + 按需装配上下文的底盘。
本文不复述系统提示词。镜头对准官方博客与工程实践已经公开的部分:语义索引、本地正则索引、AST 语法分块、Merkle 树同步、队友索引复用,以及「文件即上下文」的动态发现。目标只有一个——下次 Agent 找错文件时,你知道该怪检索、该怪提问,还是该怪 .cursorignore。
先分清两套索引,别把语义检索当万能 grep
多数人以为 Cursor 只有「一个向量库」。实际至少是两条并行管道,职责相反、不能互换。
| 索引 | 住在哪 | 擅长 | 搞不定 |
|---|---|---|---|
| 语义(向量)索引 | 服务端,按仓库分 namespace | 「我们在哪处理身份认证?」这类概念问法 | 「找出所有 db.execute("...") 字面量调用」 |
| 正则(倒排)索引 | 本机,跟当前 Git commit + 未提交编辑走 | 精确符号、路径、调用形态 | 「这段逻辑的业务含义是什么」 |
Cursor 自己的评测写得很直白:在 grep 之上叠语义搜索,Agent 准确率平均大约高 12.5%(随模型在 6.5%~23.5% 之间波动),大仓库上代码被真正留下的比例大约再高 2.6%,后续「答得不满意再追问」大约少 2.2%。数字不必当 KPI,但方向清楚:单靠精确匹配,Agent 会漏掉换了名字的同类逻辑;单靠向量,Agent 会编造「看起来像」的调用点。
官方学习文档把提问策略也拆开了。你知道函数名,就从精确模式起步,Agent 会优先走 Instant Grep;你在陌生模块里摸支付失败链路,就用宽问法,Agent 会先语义搜、再 grep 补引用。工具选错,不是模型变笨,是你把「概念」和「字面量」丢进了同一条管道。
语义索引回答「像什么」;正则索引回答「写没写过这串字符」。Coding Agent 的上下文质量,往往取决于这两路有没有同时开着。
自己做内部 Coding Agent 时,最常见的偷懒是只接一套 embedding。结果是:改函数名后旧向量还在指;搜刚写完的补丁却搜不到。Cursor 把「允许略滞后」的语义索引放云端,把「按键级新鲜」的正则索引留本机,正是承认这两种时效要求互相打架。
语义索引:按语法切块,再用会话轨迹训 embedding
打开项目后,语义索引的冷启动路径并不神秘:读文件 → 切块 → 向量化 → 写入向量库。关键不在「有没有 RAG」,而在切什么、用什么模型、存在哪。
按 AST 边界切,而不是按固定 token 窗口切。 官方描述是 syntactic chunks:先把源码解析成抽象语法树,再沿函数、类、方法、语句块切开。tree-sitter 这类多语言语法器是业界默认选项。函数是代码里天然的意义单元,也就应当是索引里的天然单元。小的兄弟节点(import、常量)可以在字节上限内合并;一个完整函数尽量不要被拦腰截断——否则 embedding 学到的是「半截签名 + 半截注释」,召回时必然串味。
下面是教学用的简化切块器,真实实现还要处理嵌套、多语言和数十种语法的边角,但心智模型够用:
from tree_sitter import Language, Parser
import tree_sitter_python as tspython

parser = Parser(Language(tspython.language()))
MAX_CHUNK_BYTES = 1500

def chunk_by_ast(source: bytes) -> list[str]:
    root = parser.parse(source).root_node
    chunks: list[str] = []
    for node in root.children:
        text = source[node.start_byte:node.end_byte].decode()
        if node.type in ("function_definition", "class_definition"):
            chunks.append(text)
            continue
        if chunks and len(chunks[-1]) + len(text) < MAX_CHUNK_BYTES:
            chunks[-1] += "\n" + text
        else:
            chunks.append(text)
    return chunks
embedding 不优化「两段代码长得像」。 Cursor 公开说过会自训 embedding,训练信号来自 Agent 会话轨迹:一次任务里模型先搜、再打开、最后改对的那些文件,事后交给 LLM 评分器排序「每一步本该更早看到什么」,再用对比学习把 query 拉向真正有用的块、推离仅表面相似的块。这和人类偏好对齐是同一思路,只是落在检索上。泛化代码相似度模型会把 retry_payment 和 retry_email 拉得很近;会话轨迹模型更关心「当前任务是支付失败,哪一块真帮 Agent 收工」。
向量落在 Turbopuffer,一仓一个 namespace。 公开数字是大约 8000 万个 namespace、超过 1 万亿向量。活跃 namespace 留在内存 / NVMe,冷的沉到对象存储,查询时再预热。旧方案要把 namespace 手工装箱到机器上,运维成本高;对象存储 + 无限 namespace 更贴「每个仓库一份索引」的产品形态。查询时可按路径 glob 过滤,例如只在 src/**/*.py 里做近邻检索,避免测试夹具和生成代码把召回带跑偏。
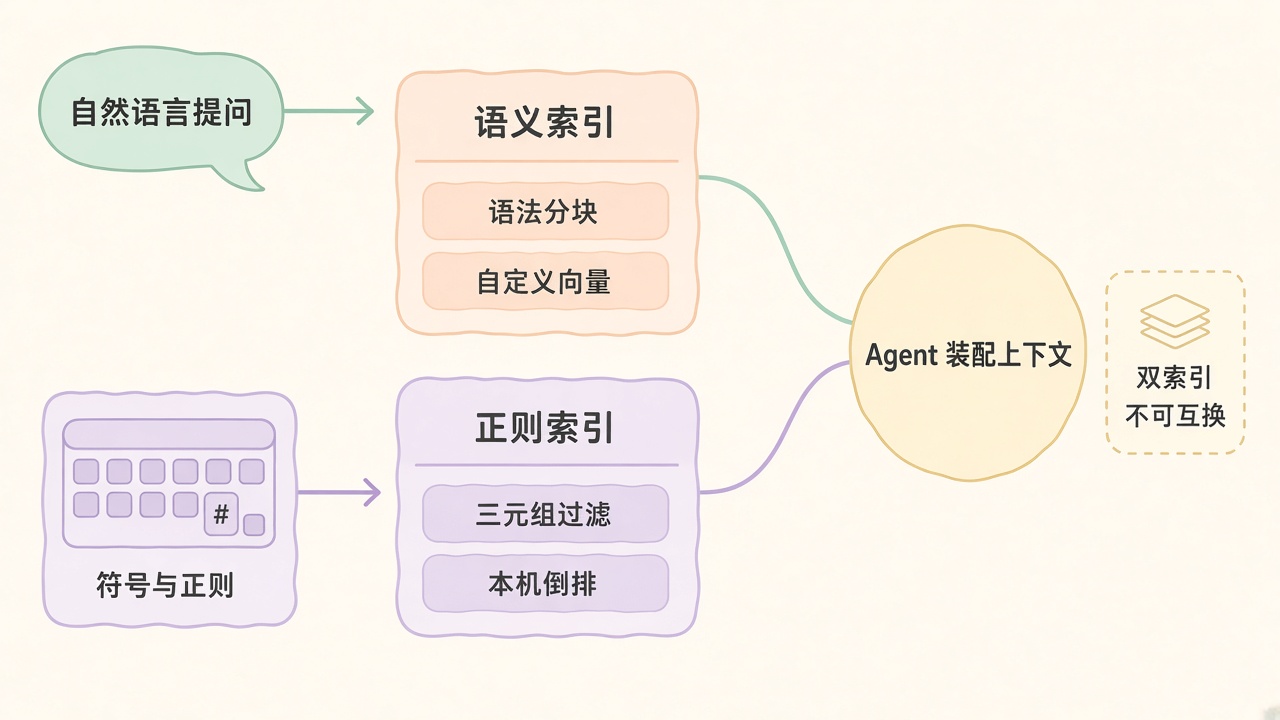
切块、模型和存储三件事绑在一起:切错了,再贵的模型也在记垃圾;模型训偏了,再好的切块也召回「像但不对」;namespace 规划乱了,权限和成本会一起爆。
Merkle 树同步:只重算分叉,还能安全复用队友索引
embedding 贵。五万文件每次全量重算,语义搜索会在「至少做完八成」之前不可用,大仓甚至要数小时。Cursor 用 Merkle 树当仓库指纹:每个文件一份 SHA-256,每个目录再哈希子节点,根哈希代表整棵树。思路和 Git 对象模型同宗,只是这里用 SHA-256。
客户端改一个文件,只有该文件及其祖先目录的哈希变。和服务端树并排走,哈希相同的子树整枝跳过,哈希不同的才下行。新增补上、缺失删掉、不一致重传。同步从不改客户端文件。五万文件只传文件名 + 哈希大约 3.2 MB;有了树,通常只需走「刚才改过的那几枝」。块内容没变则命中 embedding 缓存,推理阶段不必再付钱。
团队场景更狠。官方观察:同一组织内,同一仓的 clone 平均约 92% 相似。新人入职或换机从零索引,是在重复烧已经算过的向量。做法是:客户端从 Merkle 树导出 simhash(一份概括文件哈希分布的摘要),到团队已有索引的 simhash 空间里找近邻;相似度过阈值,就用向量库的 namespace 复制给新用户打底,复制写入还有折扣。用户可以立刻查这份「别人已经建好的索引」,后台再把本地差异补齐。
官方给出的首次可查询时间变化:
| 分位 | 从零索引 | 复用队友索引 |
|---|---|---|
| 中位仓库 | 7.87 秒 | 525 毫秒 |
| 90 分位 | 2.82 分钟 | 1.87 秒 |
| 99 分位 | 4.03 小时 | 21 秒 |
复用立刻引出安全问题:A 的索引里可能有 B 磁盘上没有的文件(未拉取的子模块、本地生成物、权限不同的目录)。解决方案仍然吃 Merkle 的密码学性质:算得出某个文件哈希,当且仅当你手里有这份内容。 B 启动复制索引时上传完整 Merkle 树,服务端存成内容证明;语义检索结果要和证明对路径。B 证明不了「我有这个文件」,这条结果直接丢掉。服务端为查询服务可以留向量和混淆路径,但访问决策不靠打开源码,而靠「你能不能复现哈希」。
树根对齐之前,你看到的是「交集」;树根对齐之后,证明可以扔掉,后续查询走完全同步的那份索引。同步过程不回写本机文件。
这套设计同时解决了两件看似无关的事:增量更新(变更检测)和跨人复用(访问控制)。自己搭企业检索时,只抄「复制 namespace」不抄「内容证明」,等于把别人分支里的私货泄漏给新同事。
本地正则索引:刚写完的补丁必须立刻能搜到
语义索引可以略旧——向量空间里「大致朝那边」往往够用。正则索引不行。Agent 刚生成一段 processRefund(),下一轮就要搜这个符号;索引若还停在十分钟前,它会怀疑自己没写出来,然后在仓库里空转,甚至再写一份同名函数。
本机 ripgrep 在小项目很快,Cursor 在超大 monorepo 上观察到单次 rg 超过 15 秒的情况。对实时结对的 Agent 来说,这是整条工作流停摆。他们回到 1993 年 Zobel / Moffat / Sacks-Davis 描述、2012 年 Russ Cox 在 Google Code Search 普及的 trigram 倒排:为每个重叠的三字符窗口建 posting list。查询 db\.execute\( 时,先抽出字面 trigram(db.、exe、ute……),对 posting 求交,得到候选文件,再只对候选跑真正正则。
def extract_trigrams(text: str) -> set[str]:
    return {text[i:i + 3] for i in range(len(text) - 2)}

def candidate_files(pattern_literals: list[str], index: dict[str, set[str]]) -> set[str] | None:
    grams: set[str] = set()
    for literal in pattern_literals:
        grams |= extract_trigrams(literal)
    if not grams:
        return None  # 抽不出字面量,只能退回全库扫描
    hits = None
    for g in grams:
        files = index.get(g, set())
        hits = files if hits is None else hits & files
    return hits or set()
纯 trigram 在 monorepo 会撑爆:常见三字窗口的 posting 太长,加载它们几乎等于全扫。生产版往两个方向收紧——sparse n-gram(确定性挑选、变长,而不是每个固定 3 窗口)让查询拆成更少、更挑的查找;每个 posting 再挂小型 Bloom 掩码,记录后继字符和位置,使「trigram 键」能按接近四元组的精度验证相邻关系。心智模型仍是「先过滤、再确认」;线上系统是把候选集压到足够小,再用 mmap 在本地做最终匹配。
架构决策同样关键:语义在云,正则在本机。 本地索引以当前 Git commit 为种子,再叠上用户和 Agent 的未提交编辑,按键级更新才便宜,启动加载才快。Instant Grep 对外表现仍是「Agent 会 grep」,对内已经不是每次从零扫盘。
实践目录里放了一份可跑的 Merkle + trigram 最小演示,用来感受「哈希分叉」和「三元组过滤」各自省掉多少比较,不是 Cursor 源码复刻。
动态上下文:检索命中先落成文件,再让 Agent 决定读多少
索引解决「找得到」。下一道坎是「塞不塞进窗口」。早期 RAG 习惯把 Top-K 片段直接拼进 prompt,MCP 一返回几万 token,对话立刻膨胀,截断还会把关键栈丢掉。
Cursor 后来强调的是 dynamic context discovery:以文件为上下文管理单元。工具响应过大时先写临时文件,Agent 只拿到路径,再按当前推理决定 read、tail 还是 grep。终端输出、MCP 回包、聊天历史同一套抽象——「可能有用的东西」都变成可再检索的文件,而不是预注入的一整坨。官方 A/B 提到,MCP 场景下 Agent 总 token 大约少 46.9%。
这和 Explore 子代理是配套的。子代理用更快的模型、独立上下文窗口并行搜,只把结论交回主对话,避免「为了看懂支付链路把四十个文件全文灌进主窗」。官方还提醒一个失败模式:没看懂现有实现就让 Agent 改。 它会再造一套校验器,或跟仓库里已有的表单模式分道扬镳。先让它画支付数据流的 Mermaid、指出共享校验器在哪,再下修改指令,比一上来「帮我重构结账」稳得多。
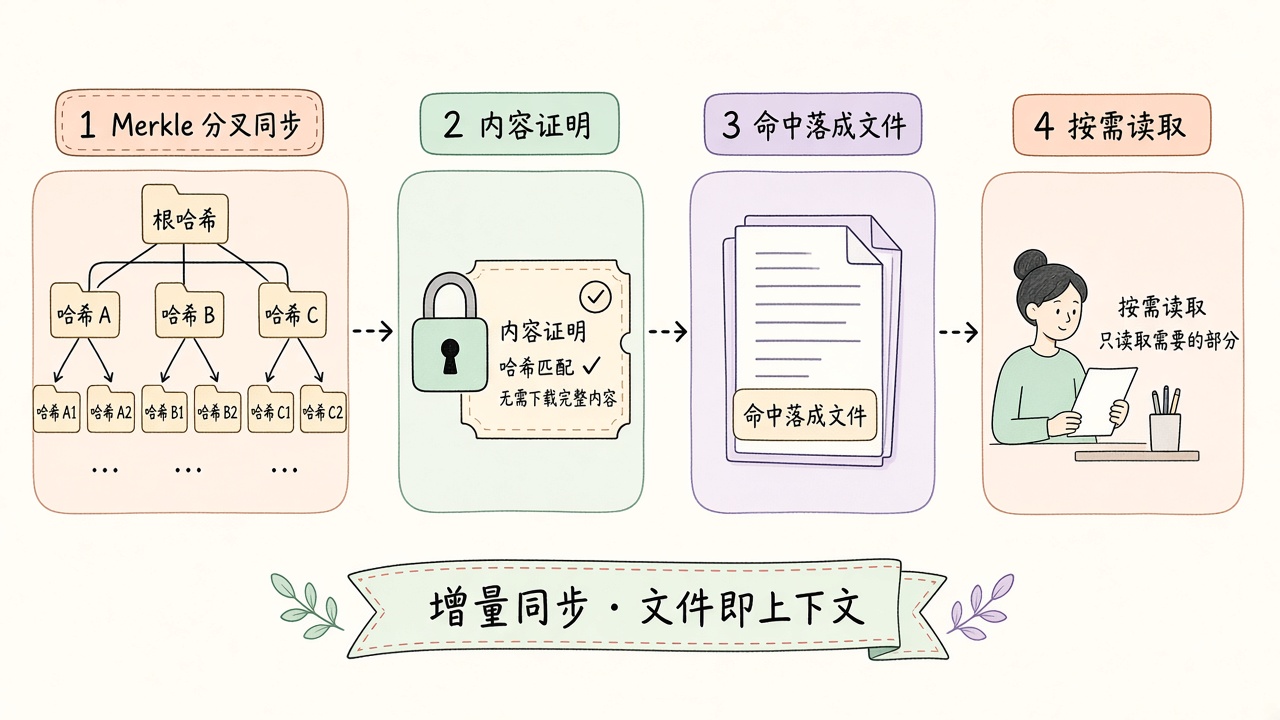
把这层说成人话:索引是图书馆目录,动态上下文是「先给你索书号,你自己决定抽哪几本」。目录再准,把整层书架搬进书桌,模型一样会晕。
自己搭 Agent 时,能抄的三块和必须留下的护栏
端到端串起来,打开仓库后的流水线可以记成七步:建 Merkle 树 → 首次用 tree-sitter 切块并写入本仓 namespace → 再次打开先用 simhash 找可复制的队友索引 → 后台只对分叉文件重算 embedding → 本机以 Git 快照加编辑层维护正则索引 → 查询时语义走云端并校验内容证明、正则走本地过滤 → 命中以文件形式按需读入,而不是预灌上下文。
对内建 Coding Agent,建议只抄「形状」,不要幻想复刻万亿向量的运维:
1. 双检索入口:自然语言走向量,符号 / 正则走倒排或 ripgrep;在编排层显式二选一或并行,而不是让模型「猜该用哪个工具」。
2. 增量比全量重要:文件哈希或 Merkle 都行,目标是「改一个函数不要重嵌整个服务」。
3. 上下文按文件发现:工具回包设硬上限,超限落盘,让模型自己决定再读哪一段。
护栏同样具体。.cursorignore / .gitignore 要挡住密钥、本地 .env、构建产物和 vendored 巨树,否则语义索引会记住不该记住的东西,正则索引会把 dist/ 里的打包字符串当「业务引用」。隐私模式和团队策略决定明文会不会离开本机——内容证明解决的是「复用索引时不看见你没有的文件」,并不自动等于「向量里没有敏感语义」。子模块没拉全时,复制来的索引可能短暂指向你磁盘上不存在的路径,这是「先可查、后对齐」的代价,不是 bug。
和 Prompt 拆解文对照更清楚:提示词管行为边界(别乱删、别假装跑过测试);索引管感知边界(你到底「看见」仓库的哪一层)。只调 Prompt,解决不了「搜不到刚写的符号」;只调切块,也解决不了「Agent 读了八十个文件却没下结论」。两套系统叠在一起,打开仓库后的那句问答才不像魔术。
配套练习见 practice/index_lab.py:对迷你目录建 Merkle、对分叉做增量对比,再用 trigram 把正则候选从「全库」收到「三两个文件」。跑通之后,再回头看 Cursor 状态栏里的索引进度,就不会觉得它只是个装饰动画。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





