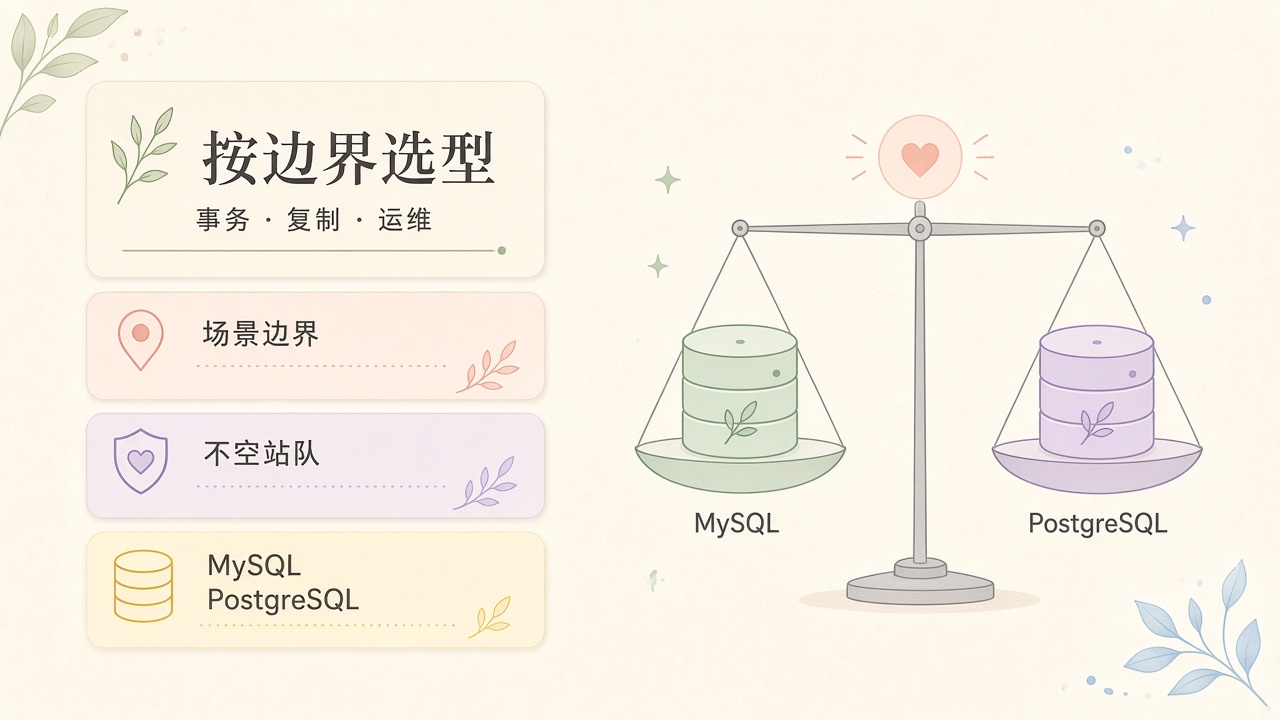
别空站队:按事务、复制与运维边界选 MySQL 或 PostgreSQL
源微信页常见验证码拦截。正文不沿用「谁更强 / 为什么还用」的口号句式,而以 MySQL 8.4 参考手册、PostgreSQL 17 文档 与社区公认工程事实为准,把选型落在场景边界:事务与隔离、复制与故障切换、JSON 与半结构化、生态与招人、运维成本。
两边都是成熟的关系型数据库,都能扛住绝大多数业务。真正浪费时间的,是用「功能清单谁更长」代替「你的团队今晚 3 点能不能修复制延迟」。
一、先停在场景,而不是停在信仰
选型争论通常从结论开始:「新项目一律 PostgreSQL」或「互联网就该 MySQL」。更稳妥的问法是四句:
1. 查询是简单主键 / 索引查找为主,还是多表 JOIN、窗口函数、分析型报表?
2. 一致性要求是「最终一致可接受」,还是「金融级可审计、可点时间恢复」?
3. 团队现成的 DBA / 监控 / 备份剧本写在哪一套工具链上?
4. 半结构化数据是偶尔塞 JSON,还是要当一等公民做检索与约束?
| 场景倾向 | 更常先看 MySQL | 更常先看 PostgreSQL |
|---|---|---|
| 读多写少、简单 CRUD、LAMP / WordPress 遗留 | 工具链与招人密度高 | 也能做,迁移成本要算 |
| 复杂 SQL、GIS、数组 / 范围类型、行级安全 | 能力相对薄 | 扩展与类型系统更完整 |
| 高并发写入 + 复杂事务 | InnoDB 行锁成熟,但间隙锁要懂 | MVCC 实现路径不同,默认隔离级别也不同 |
| 半结构化文档检索 | 8.0 JSON + 多值索引够用到一定规模 | JSONB + GIN / 表达式索引更顺手 |
| 向量 / 地理扩展 | 生态有方案,但不是默认叙事 | pgvector / PostGIS 事实标准感更强 |
没有「绝对赢家」。只有「当前团队、当前负载、当前故障剧本」下的可运维选择。
二、事务与并发:默认隔离级别差一级,行为就不一样
两边都宣称 ACID,但默认配置与 MVCC 实现路径不同,踩坑点也不同。
MySQL(InnoDB)
- 事务能力绑定存储引擎:真正谈 ACID,默认指 InnoDB;历史 MyISAM 不能当事务引擎用。
- 默认隔离级别常见是 REPEATABLE READ。间隙锁(gap lock)、临键锁(next-key lock)在「防幻读」与「插入并发」之间拉扯,死锁与锁等待日志是日常功课。
- Undo 日志承担版本链;长事务会拖住清理,表现为 undo 膨胀与历史版本读取变慢。
PostgreSQL
- 默认隔离级别是 READ COMMITTED。同一事务里两次
SELECT可能看到不同已提交快照——这是设计选择,不是「更弱所以落后」。 - 行版本写在堆表上,旧版本靠 VACUUM / autovacuum 回收。长事务、大量更新、索引膨胀是运维主线,而不是「有没有间隙锁」。
- 需要更强隔离时可用
REPEATABLE READ或SERIALIZABLE(SSI);金融级强一致场景要明确选隔离级别并压测冲突率,而不是只看默认值。
实践对照口诀:
| 关注点 | MySQL 侧先查什么 | PostgreSQL 侧先查什么 |
|---|---|---|
| 锁冲突 | performance_schema / innodb_lock_waits、死锁日志 |
pg_locks、pg_stat_activity、等待事件 |
| 长事务副作用 | undo 历史长度、purge 延迟 | xmin horizon、autovacuum 积压、表膨胀 |
| 「读是否挡写」 | 受隔离级别与锁类型影响更大 | 读通常不阻塞写,但 vacuum 与 IO 会间接影响 |
别把「PostgreSQL 更正确」当成免责声明:默认 RC 下业务若假设可重复读,会自己埋雷。反过来,MySQL 默认 RR 也不是「更安全就无痛」——间隙锁会让高并发插入路径变得难调。
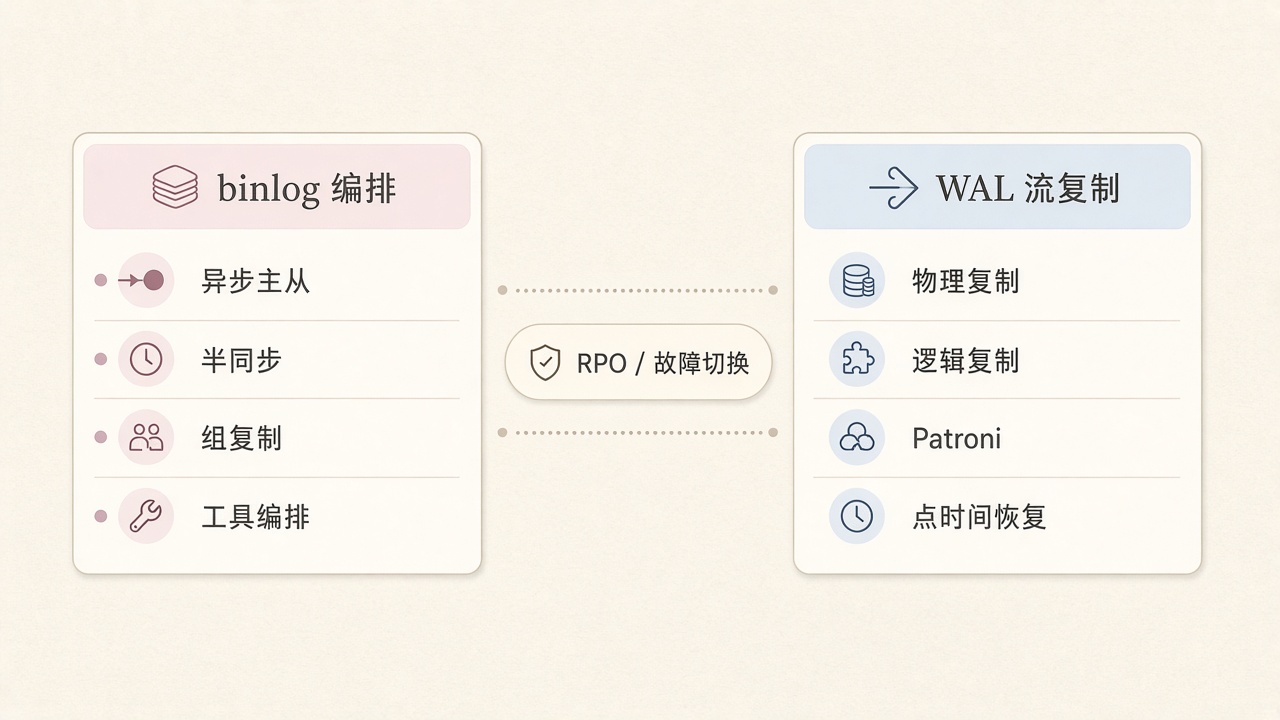
三、复制与高可用:物理流复制 vs binlog 生态
两边都能做主从与故障切换,差异在复制介质与工具成熟度。
MySQL
- 经典路径是 binlog(语句 / 行 / 混合格式)。异步复制简单;半同步、组复制(MGR)把「丢数据窗口」和「多主冲突」往工程化推。
- 故障切换与编排常用 Orchestrator、MHA、各类云托管的自动 failover。互联网公司剧本多,招人时「做过 MySQL 主从」几乎是标配。
- 点时间恢复(PITR)依赖 binlog 保留策略与备份工具(如 xtrabackup)配合;能做,但流程要写进 runbook。
PostgreSQL
- 主路径是 WAL 流复制(物理复制),延迟通常很低;逻辑复制适合迁表、部分表同步、跨大版本。
- 高可用常用 Patroni + etcd/ZooKeeper、repmgr 等;
pg_rewind处理「旧主回退」是常见话术。 - 原生 PITR 与 base backup 叙事清晰:归档 WAL + 基础备份即可回到时间点。代价是你必须认真对待归档磁盘与 slot 膨胀。
选型时不要只比「谁支持同步复制」,而要比:
1. 可接受的 RPO(丢多少秒数据)?
2. 切换是否要应用层改连接串,还是有 Proxy / VIP?
3. 跨机房延迟下,半同步 / 同步复制会不会把写入拖死?
四、JSON 与半结构化:都能存,不等于同样好查
「要不要用文档库」经常被简化成「MySQL / PostgreSQL 也有 JSON」。工程上要拆成三层:存得下、查得快、约束得住。
| 能力 | MySQL 8.x | PostgreSQL |
|---|---|---|
| 存储 | JSON 类型(内部有校验) |
JSON(文本)与 JSONB(二进制) |
| 索引 | 生成列 + 二级索引;数组场景可用多值索引(8.0.17+) | GIN / 表达式索引 / 部分索引,对嵌套查询更自然 |
| 运算符习惯 | -> / ->>、JSON_EXTRACT、JSON_TABLE |
@>、?、路径操作符与 jsonb_path_query 等 |
| 约束 | 可用生成列 + CHECK,复杂文档约束仍偏应用层 | CHECK + 域类型 + 更丰富的表达式,但仍建议文档形状稳定 |
本地对照脚本见 practice/compare_json.sql。结论很务实:
- 文档是「附属字段、偶尔过滤」→ 两边都行,优先跟主库走。
- 文档是「主查询入口、频繁嵌套包含查询」→ PostgreSQL 的 JSONB + GIN 通常少写胶水。
- 文档形状天天变、还要跨文档事务与强关系 → 先怀疑数据模型,而不是先换引擎。
五、生态、招人与扩展:规模优势 vs 扩展面
MySQL 的规模优势仍然真实
- PHP / WordPress / 大量国内中间件默认示例是 MySQL。
- 监控、备份、审核、SQL 优化器周边工具与文章密度高。
- 招聘市场上「会 MySQL」的候选人池更大;这意味着故障时更容易找到人。
PostgreSQL 的扩展面同样真实
- 扩展机制把数据库变成「可装配平台」:PostGIS、pgvector、TimescaleDB、Citus 等把 GIS、向量、时序、分布式往外推。
- 许可证是 PostgreSQL License(类 BSD),商业嵌入与云厂商改版摩擦相对小。
- 连接模型是多进程:高连接数几乎必然要 PgBouncer / 连接池;这不是可选优化,是默认运维件。
云托管时代两边都能一键开实例。真正差的是:你们现有的告警规则、慢查询平台、备份校验剧本写在哪边。换引擎 = 换一整套操作记忆。
六、运维边界:连接、膨胀、参数与「看起来能跑」
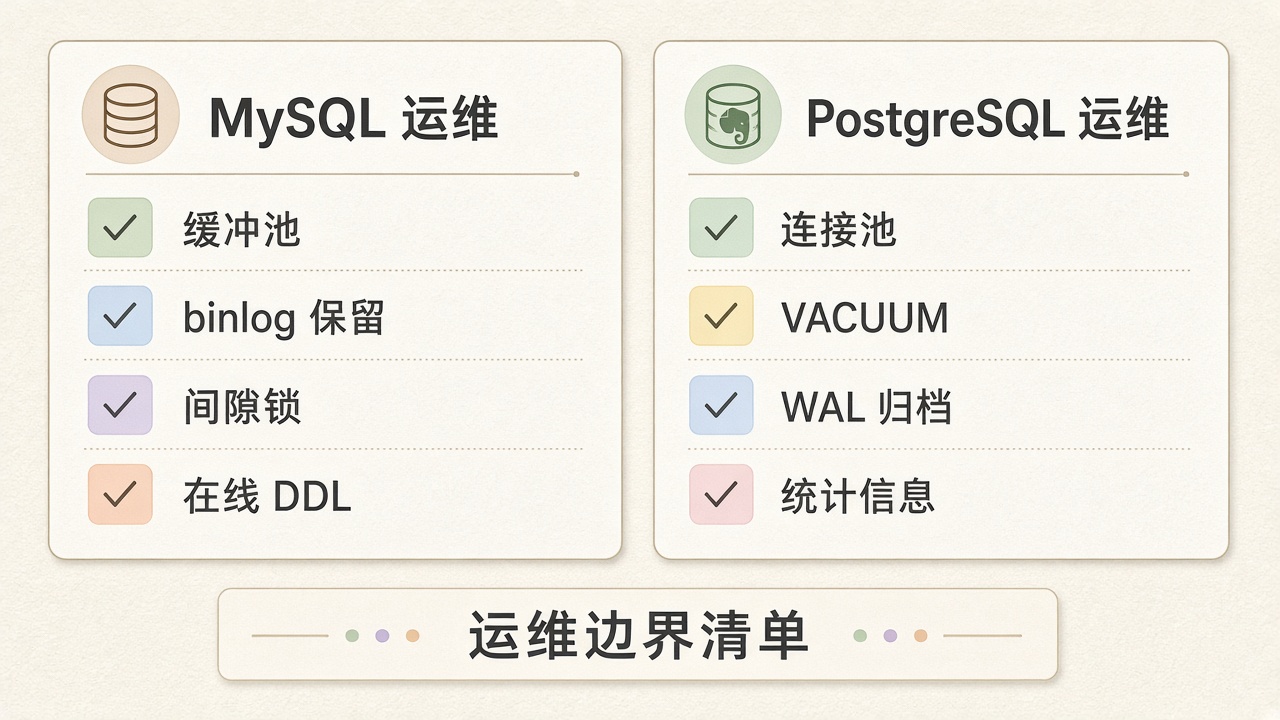
把运维差异写成可检查清单,比口号有用。
MySQL 常见边界
max_connections、缓冲池(innodb_buffer_pool_size)、redo / undo 磁盘。- binlog 保留天数 vs 磁盘;从库延迟与并行复制配置。
- 大表 DDL:在线 DDL /
pt-online-schema-change类工具的窗口与锁行为。 - 字符集必须默认 utf8mb4,别再踩三字节 utf8 的历史坑。
PostgreSQL 常见边界
- 连接数与进程内存:宁可池化,也不要「应用直接打满 max_connections」。
- autovacuum 是否跟得上写入;大表是否需要手动 vacuum / reindex 策略。
- WAL 归档与 replication slot:slot 滞后会撑爆磁盘。
- 统计信息与
ANALYZE:优化器强,但也依赖统计新鲜度。
practice/docker-compose.yml 提供一对可丢弃实例(MySQL 8.4 :3307,PostgreSQL 17 :5433),方便本地验证连接与 JSON 语法差异,不是性能基准。压测要对齐硬件、数据集、连接池与隔离级别,否则数字没有可比性。
七、给决策者的收敛路径
1. 存量系统:业务稳定、工具链成熟 → 继续 MySQL,把精力花在复制、备份校验与慢 SQL,而不是为了「追新」迁移。
2. 绿地项目且查询会变复杂:GIS / 向量 / 复杂分析 / 严格约束 → 优先评估 PostgreSQL,并预算连接池与 vacuum 运维。
3. 团队只会一边:先用会的那一边把备份、监控、演练做扎实;能力债比引擎债更贵。
4. 双库长期并存:可以,但要写清「系统级边界」——谁写主、谁做分析、如何避免双写一致性地狱。
5. 别用博客结论代替压测:用你们真实的 Top SQL、峰值连接、故障切换演练结果说话。
一句话收束:PostgreSQL 功能面更宽,不等于你的下一张工单更短;MySQL 生态更大,不等于复杂查询会自动变简单。 选边界,不选阵营。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: