

Agent 写完页面没处托管?Nubase 用 MCP 把库、函数和静态站一次推上线
Cursor、Claude Code、Codex 现在吐页面已经很快:一张待办表、一套登录、一个调用 LLM 的摘要接口,几轮对话就能堆出可点的前端。真正卡住的往往不是「模型会不会写」,而是写完之后往哪放——库谁建、JWT 谁发、静态站谁托管、边缘函数谁部署、半夜定时任务谁跑。多数团队的答案是:再开一份 Vercel、再开一份 Supabase、再手写一段 cron。Agent 负责写代码,人负责拼基础设施,demo 到线上中间永远隔着几天胶水。
Nubase(github.com/OtterMind/Nubase,Apache-2.0,官网 nubase.ai)把这层胶水收成一个可自托管的后端加部署层:数据库、认证、对象存储、静态 CDN、边缘函数、AI 网关、长期记忆、定时任务,八个模块跑在同一服务里。编码 Agent 通过 MCP(nubase_cli 本地桥,或 /mcp HTTP)直接建表、上函数、发前端,不必再单独开一份托管账号。本文基于官方 README、docs/product-overview.md、docs/deploy-ai-generated-apps.md、docs/mcp.md、docs/nubase-cli-usage.md 与 docs/docker-all-in-one.md 深度改写;源微信页抓取失败,以仓库与文档为准,不臆造能力。
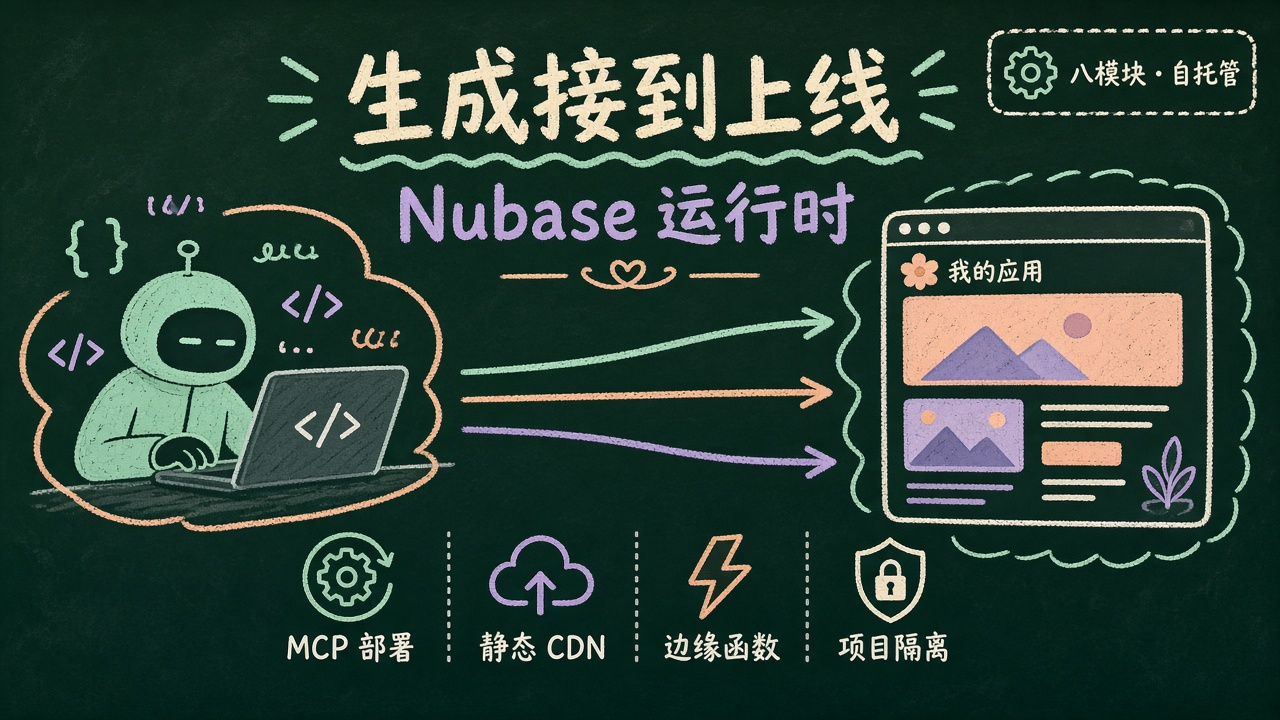
一、它补的不是又一个 BaaS,而是「生成代码」后面的上线目标
传统 BaaS 给开发者 Database、Auth、Storage,够 CRUD 应用。AI 原生应用和「Agent 刚生成的那一坨」还缺三样东西:一是长期记忆(用户偏好、实体、会话事实),二是可被 Agent 操作的控制面(建表、发前端、上函数不能只靠人点控制台),三是自托管时的多项目隔离。官方把问题说得很直:
AI Coding 工具能很快生成产品界面,但生成的应用仍需要真正上线:数据、认证、后端逻辑、前端托管、定时任务、安全 API、项目隔离,以及人类可以检查和修复的控制台。
Supabase Cloud 在托管侧是多项目的,但官方自托管栈按单项目设计。Nubase 的取向相反:一台控制面、一个 Studio、多个物理隔离的项目库。Java / Spring Boot 后端 + Next.js Studio,API 风格尽量对齐 PostgREST / JWT / RLS,让习惯 Supabase 客户端的前端不必重学一套方言。
八个模块按「应用多半会用到」排序:先数据与身份,再部署层,再 AI 增强与调度。
| 模块 | 对外路径 | Agent 主要工具 | 上线结果 |
|---|---|---|---|
| Database | /rest/v1 |
sql_execute / rest_select |
每项目独立 Postgres + RLS |
| Auth | /auth/v1 |
auth_* |
注册登录、刷新令牌、OAuth |
| Storage | /storage/v1 |
storage_* |
S3/R2 对象 + 签名 URL |
| Assets | /assets/v1 |
assets_upload |
生成前端的公共静态 CDN |
| Functions | /functions/v1 |
functions_deploy |
边缘函数 + 密钥 + 调用日志 |
| AI Gateway | /v1、/v1/messages |
gateway_* |
兼容 OpenAI / Anthropic,按项目计量 |
| Memory | /mem/v1 |
memory_write / memory_search |
事实抽取 + 混合检索 |
| cron | /cron/admin/v1 |
cron_create |
调边缘函数或库函数 |
Studio 给人看:项目、SQL 历史、用户、存储、记忆浏览器。REST + MCP 给 Agent 用:同一套项目令牌,同一套能力。它不是「再写一个 Agent 框架」,而是给已经会写代码的 Agent 准备一个可以落地的运行时目标。
二、控制面与项目库拆开:双令牌路由,而不是一套 schema 糊所有租户
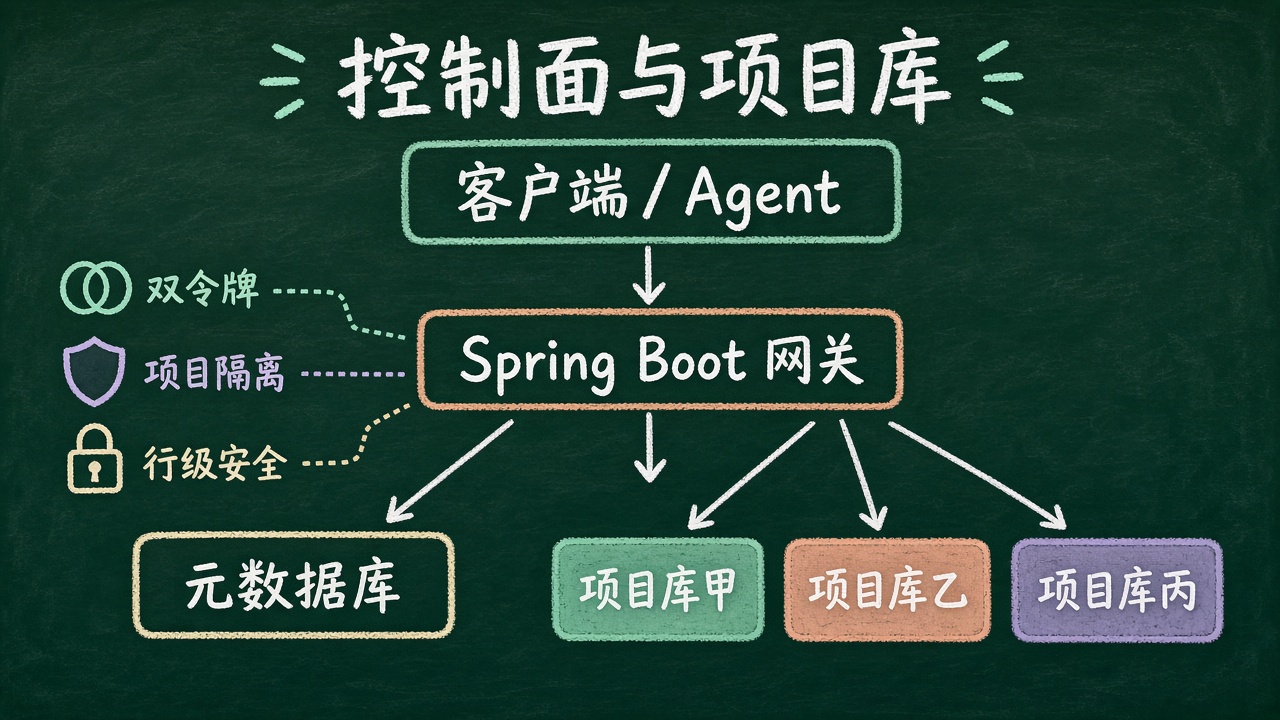
Nubase 的隔离粒度是每个项目一张物理 PostgreSQL,不是「一个库里分 schema」。元数据库(metadata)只放控制面:平台用户、项目配置、加密后的库密码与 JWT 密钥、归属关系、SQL 片段和执行记录。项目库里才是业务:public.* 应用表、auth.* 用户会话、storage.* 对象元数据、mem.* 记忆与实体。好处是爆炸半径清楚——备份、导出、轮换密钥都能按项目切;代价是连接数和池化要认真算,开通项目需要库级权限。
请求走双令牌。apikey 是项目 JWT,里面带项目引用和角色(anon / authenticated / service_role),后端用它解析项目、校验密钥、给 Hikari 数据源指到对应项目库。Authorization: Bearer <jwt> 才是终端用户,喂给 RLS 的 auth.uid() 和按用户隔离的 Memory。过滤器顺序可以画成:
Client / Studio / Agent
        |
        | apikey + optional Authorization: Bearer
        v
Spring Boot API(解析项目、设请求上下文)
        |
        +--> Metadata DB(路由、加密凭据)
        +--> Project DB A / B / C
/rest/v1 是 Java 实现的 PostgREST 风格:select / filter / order / 分页 / insert / update / upsert / delete,带 schema cache。Auth 也是 Java 自研,不绑 GoTrue:邮箱密码、刷新轮换、Google / GitHub / 微信 OAuth、MFA/TOTP、匿名登录,以及按项目签发的三类令牌。Storage 元数据落项目库,字节走 S3 兼容后端(R2 / AWS / MinIO)。Assets 才是「生成页面的落点」:/assets/v1/** 带 Cache-Control / ETag / 304,可配项目默认缓存和自定义 CDN 域名。Functions 走 /functions/v1/{slug},可挂 verify_jwt、按函数密钥、限流、本地执行器或 Cloudflare Workers for Platforms。
Memory 不是外挂向量脚本。写入 /mem/v1/memories 后,LLM 抽事实并判定 ADD / UPDATE / DELETE / NONE,embedding 写入 mem.memories,变更进 mem.memory_history,实体进 mem.entities。检索是 pgvector + 全文 + 实体加权的融合排序。cron 由控制面按 UTC crontab 调度,目标可以是已部署的边缘函数,也可以是具名数据库函数,并留运行历史。
三、generate → live:manifest 一次推,或按模块拆着上
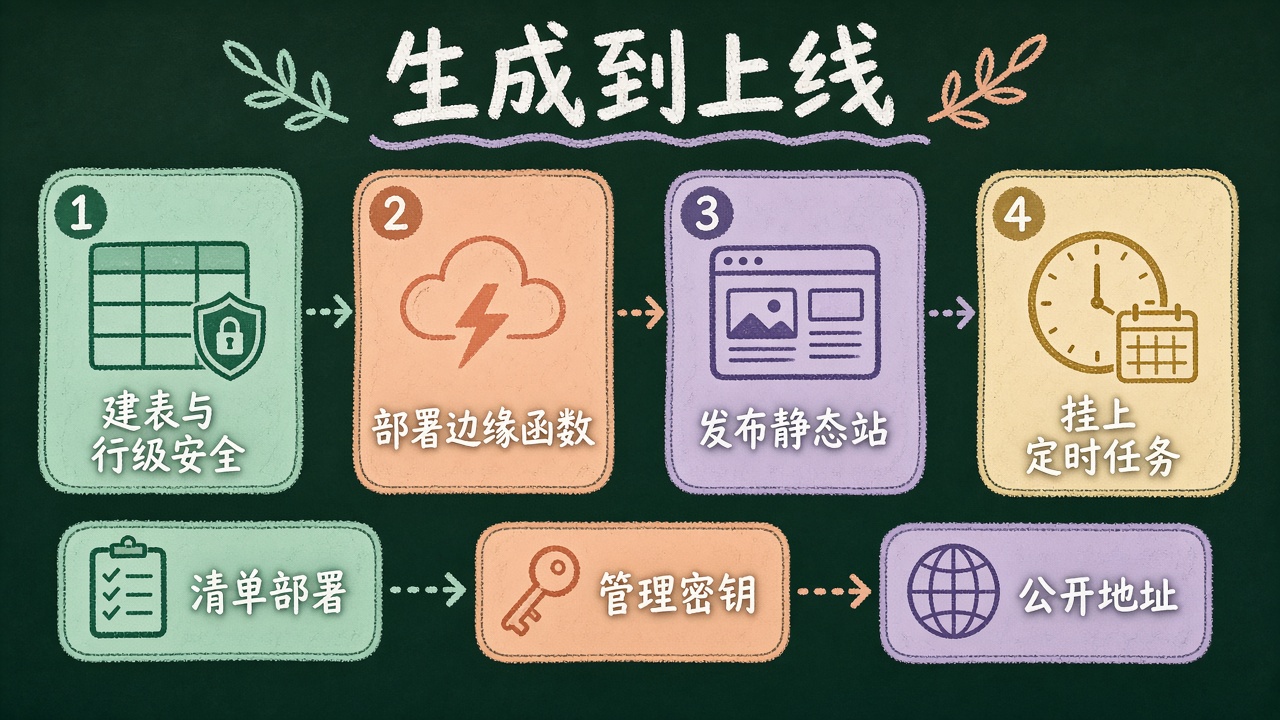
官方把「部署动作」收成四步,其余模块当配菜:建表与 RLS、上函数、发 Assets、挂 cron。AI Gateway 管模型调用计量,Memory 记这次部署发生过什么,Storage 接用户上传文件。写操作全部上锁:MCP 桥要 NUBASE_ALLOW_ADMIN_WRITE=true(函数 / 静态资源 / cron),改 schema 还要 NUBASE_ALLOW_SQL_EXECUTE=true,并且用项目的 service_role 连接。浏览器端永远只带 anon + 用户 JWT,service_role 不准进前端、不准当资源文件发出去。
Claude Code / Codex 推荐走一份部署清单,一条命令推完整应用:
{
  "name": "notes",
  "migrations": [{ "name": "schema", "file": "schema.sql" }],
  "functions": [
    {
      "name": "api",
      "dir": "nubase/functions/api",
      "verify": { "method": "GET" }
    }
  ],
  "assets": {
    "dir": "dist",
    "cacheControl": "public, max-age=31536000",
    "release": true,
    "releaseId": "v1",
    "spaFallback": true
  },
  "cron": [
    {
      "name": "nightly-digest",
      "cronExpression": "0 7 * * *",
      "targetType": "edge_function",
      "functionSlug": "api"
    }
  ],
  "rememberDeployment": true
}
NUBASE_ALLOW_SQL_EXECUTE=true NUBASE_ALLOW_ADMIN_WRITE=true \
  nubase_cli app deploy nubase.deploy.json
deploy_app 返回 deploymentId、分步状态、开启 release 时的 releaseId / releasePrefix,以及前端 publicUrl。事后用 deployment_status / deployment_logs 看进度;不想要了调 deployment_rollback——当前会删掉记录在案的 Assets 和 cron,SQL、Memory、函数部署和密钥不会自动回滚,因为没有安全的前态。assets.release: true 会把文件发到 __releases/<id>/ 并写 __nubase_release.json;spaFallback: true 把项目的 SPA 回退指到该 release 的 index.html。上传前默认扫私钥、看起来像 service_role 的 JWT、.env 和常见厂商 Key;内网可控环境可在清单里设 "securityScan": false。
不想一把梭,就按模块拆。先 sql_dry_run 再 sql_execute 建带 RLS 的表;functions_new 脚手架本地 nubase/functions/<name>/,写完 functions_deploy,再 functions_secrets_set——密钥必须挂在已部署的 slug 上,下次调用生效,不必重发包;functions_invoke 通了再 assets_upload,页面里用相对路径 /assets/v1/、/rest/v1/、/functions/v1/,避免写死主机名。定时任务先验证函数再 cron_create。LLM 流量改指网关:
OPENAI_BASE_URL=$NUBASE_URL/v1
OPENAI_API_KEY=$NUBASE_AI_GATEWAY_KEY          # gateway_issue_key 签发的 nbk_ 前缀
ANTHROPIC_BASE_URL=$NUBASE_URL
ANTHROPIC_AUTH_TOKEN=$NUBASE_AI_GATEWAY_KEY
最后 memory_write 记一句:哪张表、哪个函数 slug、前端 URL、几点的 cron。下一轮 Agent 进场先 nubase_overview + memory_context,就不必重新猜线上长什么样。
四、一条 Docker 拉起控制面,再用 nubase_cli 把 Agent 接进去
试用路径是一体化镜像:PostgreSQL 15 + pgvector、内部 Redis、后端和 Studio 打进同一进程,只暴露 9999(Studio 在 /studio,与 API 同源),5432 给需要直连库的人。Docker Hub 镜像命名空间是 ottermind/nubase,支持 linux/amd64 与 linux/arm64。
# 试用:密钥自动生成进 /data 卷,换容器务必挂回同一卷
docker run -d --name nubase \
  -p 9999:9999 -p 5432:5432 \
  -v nubase_data:/data \
  ottermind/nubase:latest
# 生产:主密钥写死,否则重启后解不开项目凭据
docker run -d --name nubase \
  -p 9999:9999 -p 5432:5432 \
  -v nubase_data:/data \
  -e PGRST_ENCRYPTION_MASTER_KEY="$(openssl rand -base64 32)" \
  -e METADATA_SERVICE_ROLE_KEY="$(openssl rand -base64 48)" \
  ottermind/nubase:latest
打开 http://localhost:9999/studio 注册平台账号(和项目里的 auth.users 不是同一批人),建项目,点 Provision:会创建独立库、auth / storage / mem / public schema、角色、JWT 密钥、service_role 与 authenticated 令牌。镜像默认关掉平台邮箱验证(容器没带 SMTP);要强制验证再开 NUBASE_PLATFORM_EMAIL_VERIFICATION_ENABLED=true 并配 SMTP。远端访问只开 9999,UI 用相对路径打 API,不必为换域名重建镜像。对象存储、OAuth、LLM 厂商都走环境变量,清单见 docs/docker-all-in-one.md。
本机开发则拆开跑:docker compose -f pg-docker-compose.yml up -d 起元数据库,导出 PGRST_ENCRYPTION_MASTER_KEY 与 METADATA_SERVICE_ROLE_KEY,mvn spring-boot:run 听 9999,cd frontend && pnpm install && pnpm dev:studio 听 3000。自行打一体化镜像:docker build -f Dockerfile.all-in-one -t nubase:local .。
Agent 侧一条命令装技能、写 MCP、走浏览器授权(RFC 8252 回环回调,凭据写到项目 .nubase/config.json):
npx -y nubase_cli@latest install-skills
# 指向自建实例:
npx -y nubase_cli@latest install-skills \
  --studio-url https://studio.example.com \
  --nubase-url https://api.example.com
文档记录当前打包版本为 nubase_cli@0.1.7。它会给 Claude Code 和 Codex 写 skills、复制本地 MCP 桥到 .nubase/mcp-bridge/**、合并项目 .mcp.json(用 node 启本地桥,避免每次 npx @latest 卡 30 秒超时),并把 .nubase/ 加进 .gitignore。Claude Code 重启后跑 /mcp,看到 nubase connected。Cursor / IDEA 同样挂 stdio:command: npx,args: ["nubase_cli"],环境里放 NUBASE_URL、NUBASE_PROJECT_KEY、NUBASE_AGENT_ID。托管客户端也可以直连 http://localhost:9999/mcp,请求头带 apikey。
CLI 本身不是交互式业务壳,而是 MCP 工具面。日常只读默认关闭写开关;要改库先 sql_dry_run,确认后再临时开 NUBASE_ALLOW_SQL_EXECUTE;drop / truncate 还要再开 NUBASE_ALLOW_DANGEROUS_SQL。成功的 schema 变更默认写入仅追加的 nubase.migrations,用 db_list_migrations 回看。函数、Assets、cron、用户、bucket、网关密钥一律要 NUBASE_ALLOW_ADMIN_WRITE=true。也可以不用 MCP,直接子命令:nubase_cli functions new hello → NUBASE_ALLOW_ADMIN_WRITE=true nubase_cli functions deploy hello → nubase_cli functions invoke hello --method POST --body '{"name":"ada"}',线上路径就是 POST /functions/v1/hello。
# 手工发一页静态站(service_role,仅服务端)
curl -X PUT "http://localhost:9999/assets/admin/v1/files/index.html" \
  -H "apikey: $NUBASE_SERVICE_KEY" \
  -H "Content-Type: text/html" \
  --data-binary '<!doctype html><h1>Hello from Nubase Assets</h1>'

# localhost 没有子域名时,用 Host 头模拟 {appCode}.localhost
curl -H "Host: <appCode>.localhost" http://localhost:9999/assets/v1/index.html
配套示例清单和启动命令放在本页包 practice/ 里,可直接改路径试用。
五、和 Supabase 怎么选,以及现在还不能当生产保险柜的部分
对照官方表格,差异集中在三处。第一,自托管控制台:Supabase 开源栈模拟单项目,Nubase 从第一天按多项目 Studio 设计,隔离边界是独立 Postgres。第二,AI 工作负载:Memory 是一等支柱(Mem0 风格抽取 + 混合检索),不是「自己挂一张向量表」;AI Gateway 按项目发 nbk_ 钥并记账。第三,生成应用的部署面:Assets + Functions + cron 收在同一平台,不必再为静态站、函数和定时任务各开一家。数据库 API 是 Java 实现的 PostgREST 兼容层,Auth / Storage 走熟悉的 /auth/v1、/storage/v1。Realtime 官方明确还没有;备份 / PITR、高可用编排、企业 SSO / SCIM、按项目计费也不在开源核心里。docs/architecture.md 里仍把 Edge Functions 写在 Known Gaps——以 README 与部署文档为准:函数、Assets、cron 已经落地,架构文档略滞后。
开源核心覆盖项目开通、库级隔离、Auth、Storage、REST、Assets、Functions、Gateway、Memory、cron、本地 Studio。商业层预留组织团队、细粒度 RBAC、SSO/SAML/SCIM、审计、配额计费、托管备份与 HA。早期公开版还在做安全加固、生产部署文档、密钥清理、管理接口权限审查和 CI。官方提醒:把服务暴露到公网之前,先审一遍管理 / 开通类端点。
落地时几条硬边界建议写进团队规范,而不是只写在提示词里:
- 密钥分层:前端只带 anon + 用户 JWT;service_role、平台
METADATA_SERVICE_ROLE_KEY、函数密钥、PGRST_ENCRYPTION_MASTER_KEY全部留在服务器或本机 Agent 工具。 - 写开关默认关:只读排障用
nubase_overview/db_export_schema/memory_search就够;改表、发函数、传 Assets 再开对应环境变量,用完关掉。 - 回滚不对称:
deployment_rollback清得了静态资源和 cron,清不了已经执行的 SQL 和已部署函数。重要迁移先sql_dry_run,并接受 migrations 审计表是事后对账而不是时光机。 - localhost 的 Assets:公网读路径靠子域名解析租户;本机要用
Host: <appCode>.localhost验证,或直接打开上传返回的publicUrl。 - MCP 超时:
.mcp.json不要长期写npx -y nubase_cli@latest,让install-skills改成本地node .nubase/mcp-bridge/...,否则 Claude 重连容易 30 秒超时。 - Memory 依赖模型:没配
OPENAI_API_KEY(或兼容厂商)时,抽取 / embedding 会报配置错误或走降级;网关和 Memory 是两条线,MCP 通了不代表模型调用已记账。
适合谁:用 AI Coding 赶产品、想让 Agent 安全地碰后端、需要持久用户记忆、喜欢 Supabase API 但基础设施想放在 Java / Spring、一台机器上跑多个中小项目的团队。不适合谁:现在就要 Realtime 订阅、要托管级 PITR / HA、要把管理面裸奔到公网还不审接口的场景。它解决的是「Agent 写完了,运行时目标在哪」——不是把运维责任一起写没。
仓库、文档与许可证:https://github.com/OtterMind/Nubase(Apache-2.0)。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





