42 个 OpenClaw 落地案例按权限分五档:先从哪一档搭起最不容易翻车
OpenClaw 装好之后不知道拿来干什么,是很多人的真实状态:聊天有 ChatGPT,写代码有 Cursor,一个能跑定时任务、能连聊天软件、能执行命令的 Agent,反而因为“什么都能做”而无从下手。
GitHub 上的 awesome-openclaw-usecases 就是为这个问题建的。它不收集技能(Skill),只收集“真实在用”的案例,每个案例给出痛点、所需技能、配置步骤和提示词。仓库 README 开头有一句很关键的警告:列表里引用的社区技能、插件和外部仓库没有经过维护者审计,可能存在严重安全漏洞,使用者要自己检查源码、权限,并且不要把 API Key 写死在配置里。
所以挑案例时,除了“这个有没有用”,更该先问“这个出了错会怎样”。本文把仓库里 42 个案例克隆到本地,用一个脚本按“权限爆炸半径”分成五档,再从里面提炼出三种可以复用的工程模式,最后给出一条从低风险到高风险的搭建顺序。
仓库现状:42 个案例,3.1 万 Star
截至 2026 年 10 月,仓库约 3.17 万 Star、2700 多 Fork,MIT 协议,最后一次提交在 3 月 24 日。网上流传的“8000+ Star、30 个案例”是早期数据,现在 usecases/ 目录下有 42 个案例文件。README 按场景分了六类:
| 分类 | 条目数 | 代表案例 |
|---|---|---|
| 社交媒体 | 5 | Reddit / YouTube 每日精选、X 账号分析、109 源科技新闻聚合 |
| 创作与构建 | 6 | 一觉醒来收获一个 App、多 Agent 内容工厂、播客制作流水线 |
| 基础设施与运维 | 2 | 自愈家庭服务器、n8n 工作流编排 |
| 效率 | 21 | 多 Agent 专业团队、早间简报、第二大脑、电话助理、个人 CRM |
| 研究与学习 | 8 | 财报追踪、个人知识库 RAG、动手前查重、arXiv 论文阅读 |
| 金融交易 | 1 | Polymarket 模拟盘自动交易 |
README 表格共 43 行,其中“Phone-Based Personal Assistant”出现了两次,去重后正好对应 42 个文件。贡献规则也值得一提:只接受“自己实际用过且至少稳定跑了一天”的案例,并且明确不收加密货币相关内容。
为什么按权限分级,而不是按场景挑
社区文章通常按角色推荐,比如内容创作者选什么、独立开发者选什么。这种分法解决的是“有没有用”,没有回答“出错的代价”。Agent 的错误不像普通脚本那样可预期:提示词注入、技能里的恶意代码、模型的一次误判,都可能让它做出你没授权的事。出错时能造成多大损失,由你给它开了哪些权限决定。
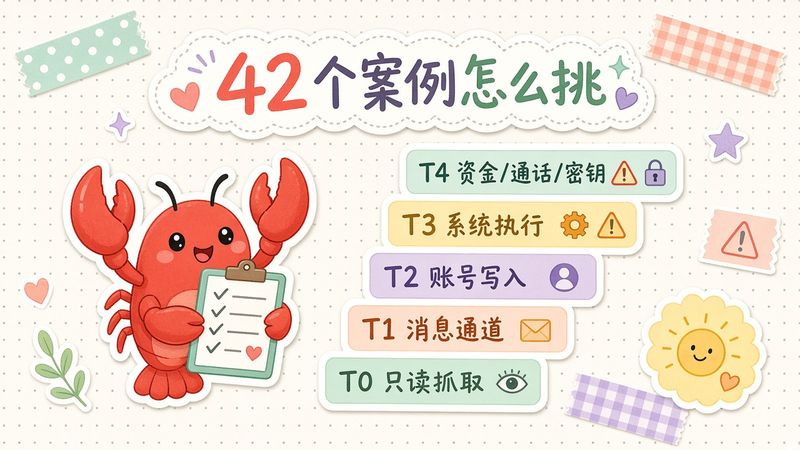
按这个思路,我把案例需要的能力分成五档:
| 档位 | 能力 | 出错的典型后果 | 可逆性 |
|---|---|---|---|
| T0 只读抓取 | 读 Reddit、YouTube、arXiv、HN,网页抓取 | 摘要质量差,浪费一点 Token | 完全可逆 |
| T1 消息通道 | Telegram、Discord、Slack、短信机器人 | 消息发错群,机器人 Token 泄露 | 基本可逆 |
| T2 账号写入 | 邮箱、日历、Todoist、Jira、Notion、发推 | 误删邮件,以你的名义对外发布内容 | 部分可逆 |
| T3 系统执行 | SSH、kubectl、Terraform、Docker、Shell、git push | 改坏线上配置,泄露密钥,删数据 | 难以逆转 |
| T4 资金 / 通话 / 密钥库 | 打电话、交易、1Password | 产生费用,打扰真人,金融或凭据损失 | 不可逆 |
这里“可逆性”比“危险程度”更值得关注。T0 的错误重跑一次就好;T4 的电话一旦拨出去、钱一旦花出去,就收不回来了。
用脚本给 42 个案例分档
分级脚本 practice/triage_usecases.py 的逻辑很简单:逐个读取 usecases/*.md,用每档的关键词正则在全文中匹配,取命中的最高档,并打印命中的证据词,方便人工复核;同时统计 AGENTS.md、HEARTBEAT.md、STATE.yaml 等配置文件被提到的次数。
TIERS = [
    ("T4", r"\b(phone call|voice call|voice agent|twilio|elevenlabs|polymarket|trading|1password|payment|stripe)\b"),
    ("T3", r"\b(ssh|kubectl|terraform|ansible|docker|shell|exec|git push|browser automation|playwright|deploy)\b"),
    ("T2", r"\b(gmail|email|calendar|todoist|jira|linear|notion|crm|post tweets?|x api|instagram)\b"),
    ("T1", r"\b(telegram|discord|slack|whatsapp|sms|lark|feishu|dingtalk)\b"),
    ("T0", r"\b(rss|reddit|youtube|arxiv|hugging ?face|web search|fetch|hacker news)\b"),
]
写这个脚本时踩了两个小坑,也说明这个仓库的格式并不统一:第一,“所需技能”小节有 Skills You Need、Skills you Need、Skills Needed 三种写法;第二,很多案例的技能栏只写了技能名(比如电话类案例写的是 clawdtalk),只看技能栏会把打电话的案例误判成 T0。所以最终改为全文匹配。运行结果:
$ python triage_usecases.py awesome-openclaw-usecases
cases=42 T0=7 T1=7 T2=13 T3=9 T4=6
config files: cron=13, AGENTS.md=5, HEARTBEAT.md=3, STATE.yaml=1, SOUL.md=1
T0  skills=0  daily-reddit-digest                    reddit
T0  skills=1  pre-build-idea-validator               hacker news
T0  skills=3  autonomous-project-management
T1  skills=3  knowledge-base-rag                     slack,telegram
T2  skills=3  custom-morning-brief                   calendar,email,todoist
T2  skills=3  personal-crm                           calendar,crm,email,gmail
T3  skills=1  autonomous-game-dev-pipeline           git push
T3  skills=4  n8n-workflow-orchestration             docker,shell
T4  skills=4  event-guest-confirmation               phone call,twilio,voice agent
T4  skills=5  polymarket-autopilot                   polymarket,trading
T4  skills=7  dynamic-dashboard                      polymarket
T4  skills=8  self-healing-home-server               1password
(节选,完整输出见 practice/triage_output.txt)
关键词分级只能做初筛,必须人工复核,这份结果里就有三个典型的误判。arxiv-paper-reader 被判为 T3,是因为原文写着“No Docker or Python required”,否定句也被关键词命中了,它实际只需要下载论文,属于 T0。polymarket-autopilot 明确是模拟盘交易,不动真钱,应从 T4 下调。dynamic-dashboard 只是把 Polymarket 交易量当作一个数据源来读,但它确实要执行 shell 命令采集 CPU、内存和磁盘指标,所以按 T3 处理是对的。复核后的大致分布是:只读和消息类约占三分之一,账号写入约三分之一,需要系统执行或涉及通话、密钥的约三分之一。
先搭 T0 和 T1:三个低风险高回报的起点
建议从只读类开始,不是因为它们简单,而是因为它们让你在零风险的前提下熟悉 OpenClaw 的记忆和定时任务机制。
Reddit 每日精选(T0)。用的 reddit-readonly 技能不需要授权,README 明确写着“只读,不发帖、不投票、不评论”。配置就是一段提示词:列出关注的子版块,让 Agent 每天下午 5 点推送热门帖子;关键是让它为这个流程单独建一份记忆,每天问你喜不喜欢这批内容,并把你的偏好写成规则。一两周后,摘要会明显更贴合你的口味。这个案例教会你的是:OpenClaw 的价值很大程度来自“记忆 + 定时”,而不是单次对话。
动手前查重(T0)。这个案例很适合开发者:接入 idea-reality-mcp 这个 MCP 服务,它会扫描 GitHub、Hacker News、npm、PyPI 和 Product Hunt,返回 0 到 100 的 reality_signal 拥挤度评分。然后在 Agent 指令里加规则:评分高于 70 就停下来列出前三名竞品,30 到 70 之间给出差异化方向,低于 30 才开工。它本质上是给 Agent 加了一道“开工前检查”,防止它花 6 个小时重写一个已有 5 万 Star 的项目。
{
  "mcpServers": {
    "idea-reality": { "command": "uvx", "args": ["idea-reality-mcp"] }
  }
}
个人知识库 / 第二大脑(T1)。通过 Telegram 或 Slack 把链接、推文、随手的想法发给机器人,它负责入库,需要时用语义检索找回来。风险集中在机器人 Token 上,所以只给它开私聊,不要拉进公开群。
三个可复用的工程模式
看完 42 个案例会发现,真正值得学的不是某个具体案例,而是反复出现的几种结构。
模式一:HEARTBEAT 与定时任务是真正的产品。 脚本统计显示,13 个案例依赖 cron 定时执行,3 个用到 HEARTBEAT.md。自愈服务器案例的作者总结得很直接:定时任务(健康检查、邮件分拣、早间简报)带来的日常价值,比临时下指令大得多。他的 Agent 跑着 15 个活跃定时任务。设计案例时,先想清楚“它每天几点自动做什么”,再想“我能问它什么”。
模式二:用 STATE.yaml 代替中心调度。 “自主项目管理”案例让主会话只做协调(规则是每次最多 0 到 2 次工具调用,只派发、不执行),每个子 Agent 认领 STATE.yaml 里的任务,完成后更新状态和产出,其他 Agent 轮询这个文件来领取解除阻塞的任务。所有状态都在一个受 Git 管理的文件里,出了问题可以直接看 diff、直接回滚。
tasks:
  - id: api-auth
    status: done
    owner: pm-backend
    output: "src/api/auth.ts"
  - id: content-migration
    status: blocked
    owner: pm-content
    blocked_by: api-auth
模式三:凭据隔离代理。 这是我认为整个仓库里最有价值的安全模式,来自“n8n 工作流编排”案例。
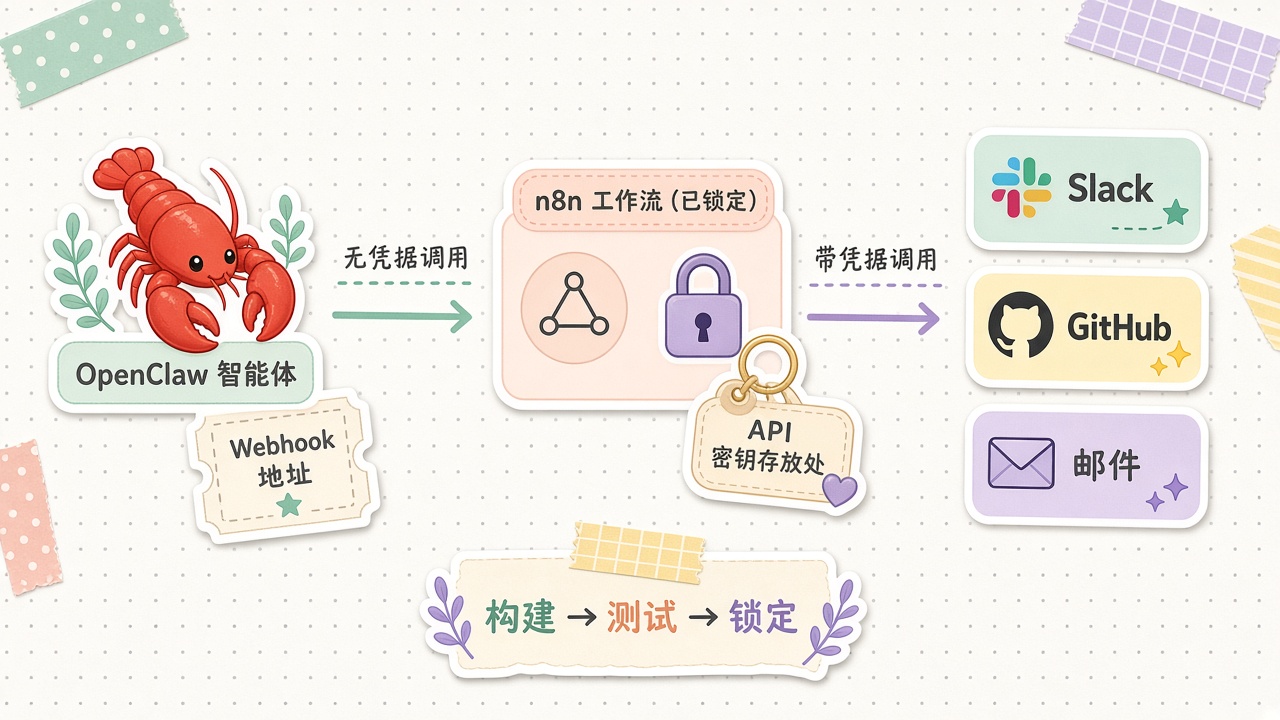
做法是:Agent 不直接持有任何第三方 API Key,所有外部调用都交给 n8n 工作流。Agent 通过 n8n API 创建一个带 Webhook 触发器的工作流,由你在 n8n 界面里手动填入凭据,测试通过后锁定这个工作流,之后 Agent 只能用一个 JSON 请求调用 Webhook 地址。这样一来,凭据不会出现在 Agent 的环境变量和技能文件里,每个集成都能在可视化界面里审查,还可以在 n8n 里加校验、限流和审批节点。案例里强调了“构建、测试、锁定”这个顺序:不锁定的话,Agent 可以悄悄修改工作流。
这个模式能把很多 T2、T3 的案例实际降低一档:Agent 自己不再需要邮箱或 GitHub 的凭据,它能做的只是调用你锁定好的那几个动作。
T3 和 T4:上之前先把护栏装好
“自愈家庭服务器”是仓库里权限最大的案例:Agent 能 SSH 到家庭网段内所有机器,能用 kubectl 操作 K3s 集群,能读 1Password 里专门划出来的 AI 保险库,还能读写 Gmail 和日历。作者分享的教训很具体:
- AI 会把密钥写死在代码里。这是头号风险,作者第一天就泄露过一次 API Key。必须配 pre-push 钩子和密钥扫描(他用的是 TruffleHog)。
- 不要让 Agent 直接推公开仓库。先推到私有的 Gitea 实例,经过 CI 扫描再同步出去。
- 在 AGENTS.md 里写死规则:禁止硬编码密钥,一律走 1Password CLI 或环境变量;禁止直接推 main,一律提 PR;所有基础设施变更写入变更日志。
T4 里的电话类案例(嘉宾到场确认、电话提醒)调用 Twilio 等语音服务给真人打电话,除了每通电话的费用,还涉及对方是否同意接收 AI 来电。真要用,先只拨给自己的号码测试,再小范围给同意过的联系人使用。
把这些经验归纳成上线前的检查清单:
| 档位 | 上线前至少要做 |
|---|---|
| T1 | 机器人只开私聊;Token 放环境变量,不写进技能文件 |
| T2 | 优先用只读或草稿权限;对外发布、删除类动作要求人工确认 |
| T3 | 专用低权限账号;pre-push 密钥扫描;只能提 PR,不能推 main;变更写日志 |
| T4 | 先用模拟盘或测试号码;设置额度和频率上限;关键动作必须人工审批 |
| 全部 | 安装社区技能前读源码、看申请的权限;优先用凭据隔离代理 |
推荐的搭建顺序
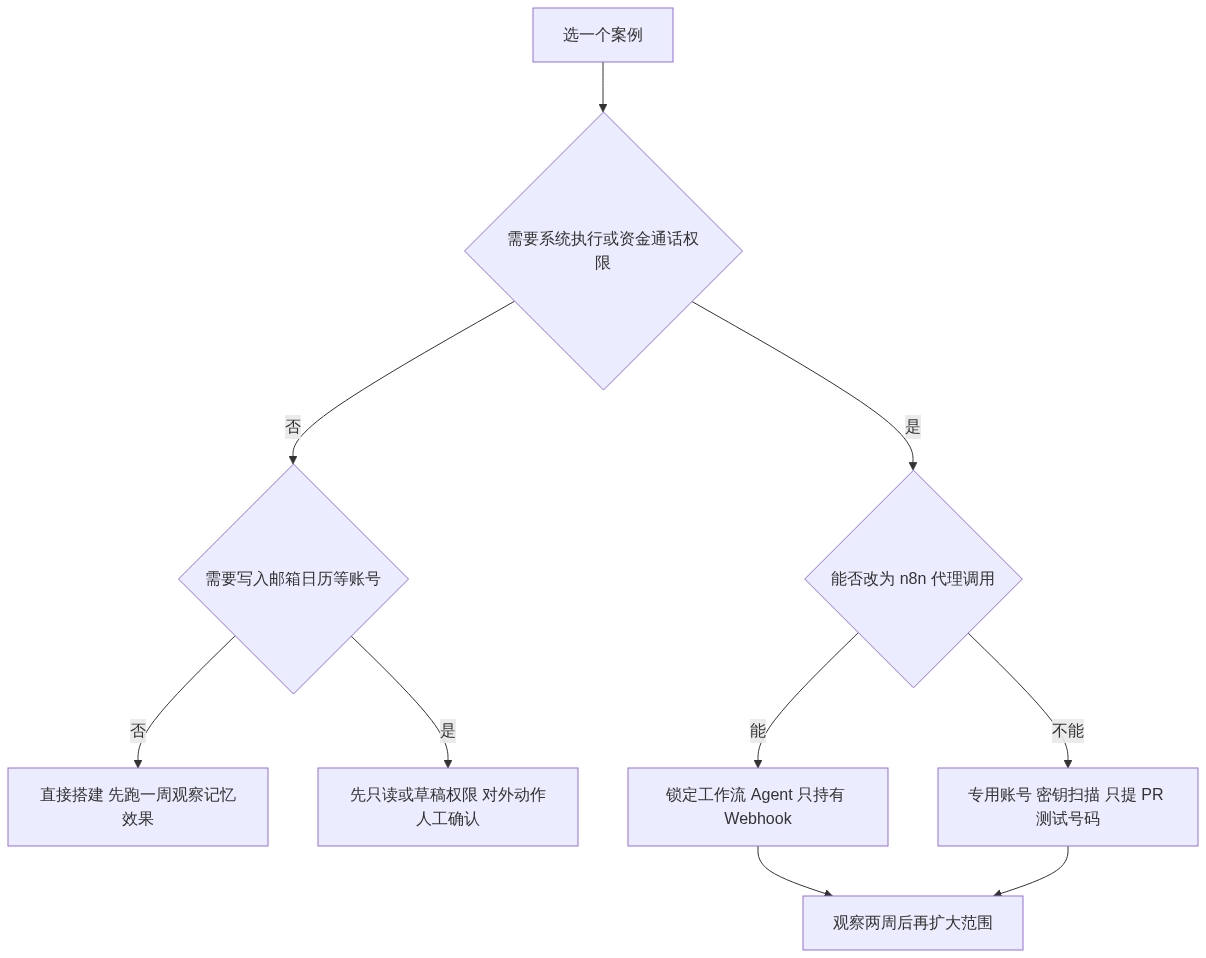
按角色给出组合时,把档位一起标上,心里会更有数:
| 你是谁 | 起步组合(低风险) | 进阶(需要护栏) |
|---|---|---|
| 内容创作者 | Reddit / YouTube 精选(T0)+ X 账号分析(T0) | 多 Agent 内容工厂(T1)、播客流水线(T2) |
| 独立开发者 | 动手前查重(T0)+ 市场调研产品工厂(T1) | 一觉醒来收获一个 App(T1,构建产物需人工审) |
| 想提升效率 | 第二大脑(T1)+ 早间简报(T2,任务只读) | 多渠道助理(T2)、个人 CRM(T2) |
| 运维 / 技术人员 | 项目状态管理(T1)+ n8n 工作流编排(T3,用来降权) | 自愈服务器(T4,护栏装全再上) |
总结
awesome-openclaw-usecases 最大的价值不在于“42 个能抄的配置”,而在于它把别人跑通的结构摆在了面前:用定时任务让 Agent 主动干活,用 STATE.yaml 协调多个 Agent,用 n8n 把凭据和 Agent 隔开。
挑案例时先问一句“出错能不能撤回”,从只读类开始,把记忆和定时任务玩熟;需要写权限时,优先考虑凭据隔离代理,把 Agent 能做的事限定在你锁定好的几个动作里。T3 和 T4 的案例确实最有吸引力,但它们也是最需要先装好护栏的。
参考资料:hesamsheikh/awesome-openclaw-usecases 仓库 README 及各案例文档(提交 659895e,2026-03-24)、案例中引用的 Nathan《Everything I've Done with OpenClaw (So Far)》。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。