定时增量每 5 秒全表扫一遍?我用 DBSyncer 跑了三组对照实验才找到原因
做过数据同步的人大多踩过这种坑:任务面板一片绿,“成功”数字天天往上涨,可目标库里就是少了几条新订单,删掉的数据也还躺在那里。问题往往不在工具本身,而在“增量”到底是怎么取数的。
DBSyncer 是一款国产开源的异构数据同步中间件,GitHub 和 Gitee 双仓库维护,采用 Apache-2.0 协议。它的卖点是“组合驱动”:MySQL、Oracle、SQL Server、PostgreSQL、Elasticsearch、Kafka、文件之间可以任意搭配,全量、增量都在一个 Web 控制台里配置。本文不重复功能清单,而是把 DBSyncer 2.1.2 社区版跑起来,用 SQLite 到 SQLite 的同步做三组对照实验,把“定时增量”模式里最容易被忽略的三个坑逐一复现,再顺带记录一个连接器缺陷和绕过方法。
DBSyncer 是什么:一个“连接器 × 监听器”的组合框架
先看定位。DBSyncer 的 README 列出了 23 种连接器(含只能作数据源的自定义 SQL),绝大多数既能做数据源也能做目标源,覆盖的面相当广:
| 类别 | 连接器(支持版本以 README 为准) |
|---|---|
| 主流关系型 | MySQL 5.7.19+、Oracle 10g-19c、SQL Server 2008+、PostgreSQL 9.5.25+ |
| 国产与分布式 | 达梦 DM8、人大金仓 V8、OceanBase 3.x+、TiDB 5.x+ |
| 分析型 | ClickHouse 22.x+、Doris 1.2.x+、StarRocks 2.5+、DuckDB 1.5.x |
| 嵌入式 | SQLite、H2 2.2.x |
| 非关系型与消息 | Elasticsearch 6.0-8.15、MongoDB 4.2+、Redis、Kafka、RocketMQ 4.9+ |
| 其他 | File(.txt / .unl)、HTTP、自定义 SQL(仅作数据源) |
工程按职责拆成十来个 Maven 模块:dbsyncer-connector 放各数据库的读写实现和 SQL 生成器,dbsyncer-parser 负责字段映射、类型转换和批量写入,dbsyncer-manager 管理全量与增量任务的生命周期,dbsyncer-storage 存元数据(默认落本地磁盘,生产推荐换成 MySQL 以支持集群),dbsyncer-web 是 Spring Boot 2.5 写的控制台,dbsyncer-plugin 和 dbsyncer-sdk 提供插件扩展接口。
截至 2026 年 10 月,GitHub 仓库约 949 Star、154 Fork,最近一次提交在 10 月 13 日,Gitee 上最新标签为 v2.1.4(8 月 13 日)。社区版和专业版分开发布,专业版多了执行器并行度等配置,本文全部基于社区版。
需要先建立的一个概念是:DBSyncer 里“增量”有两种完全不同的实现,选哪种由数据源连接器决定,后面所有的坑都源于这一点。
日志解析与定时轮询:两种增量的能力边界
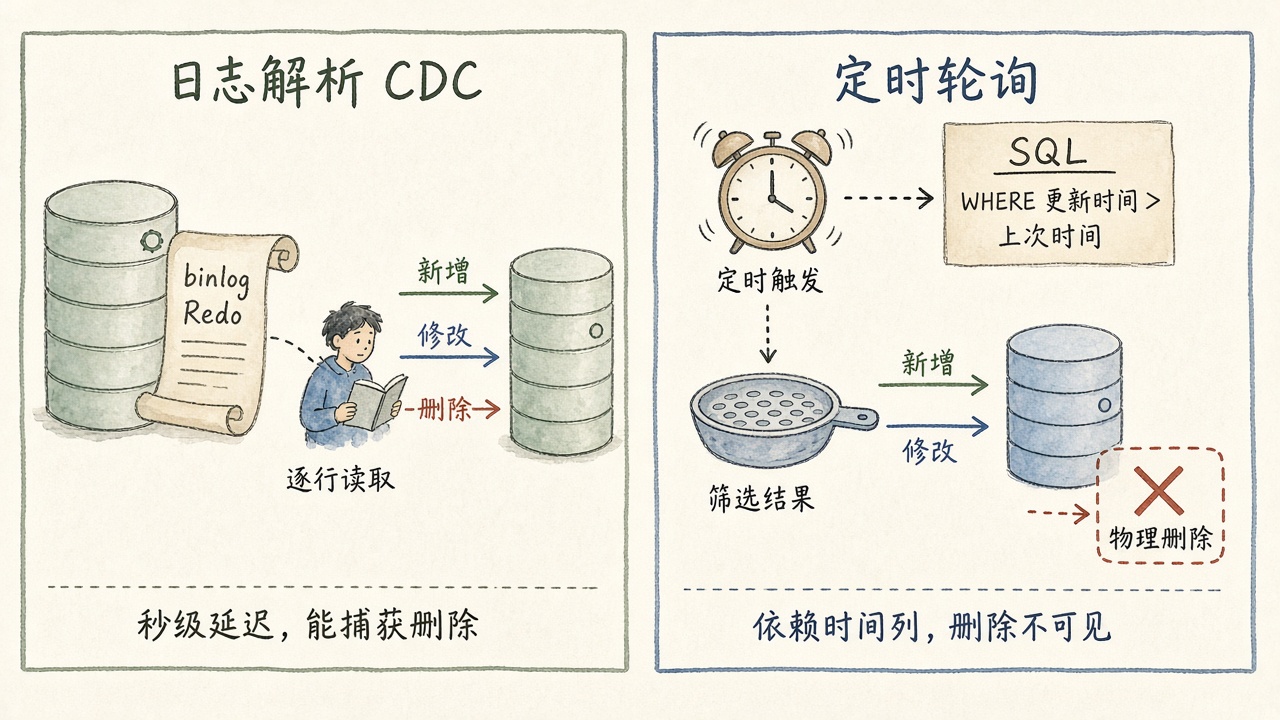
翻 dbsyncer-connector 下每个连接器的 getListener 方法,可以把增量能力分成三类:
| 增量方式 | 典型连接器 | 取数原理 |
|---|---|---|
| 只支持日志 | Kafka、RocketMQ、Redis、File | 订阅消息或解析文件追加内容 |
| 日志 + 定时都支持 | MySQL、Oracle、SQL Server、PostgreSQL、MongoDB、达梦、金仓、OceanBase、ClickHouse | 日志模式读 binlog / Redo / CDC / Change Stream;定时模式按 SQL 轮询 |
| 只支持定时 | SQLite、H2、DuckDB、Doris、StarRocks、Elasticsearch、HTTP | 只能按 SQL 条件周期性查询 |
日志模式是真正意义上的 CDC(变更数据捕获)。以 MySQL 为例,DBSyncer 依赖 mysql-binlog-connector-java 伪装成从库读取 binlog,新增、修改、删除三类事件都能拿到,延迟在秒级。代价是对源库有要求:MySQL 要开启 binlog_format=ROW,同步账号要有 REPLICATION SLAVE 和 REPLICATION CLIENT 权限。
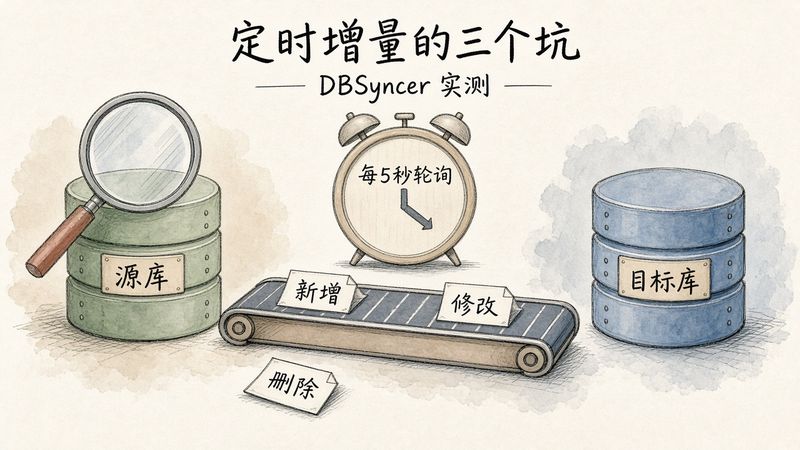
定时模式就朴素得多。源码里的 AbstractQuartzListener 按 Cron 表达式触发,每次执行一条带过滤条件的 SELECT,以 readNum(默认 5000)为页大小翻页,把读到的每一行包装成一个变更事件扔进队列。它对源库零侵入,任何能执行 SQL 的库都能用,但也带来三个天然限制:只能看到“查得出来”的行;能否只取新数据,完全取决于过滤条件;行本身不携带“这是新增还是修改”的信息。
这三个限制就是下面三个坑的来源。SQLite 只支持定时模式,正好拿来做实验。
实验环境:2 万行订单,全量 0.4 秒
实验在一台 8 核、16 GB 内存的 Linux 机器上进行。Docker 守护进程不可用,于是直接使用 Gitee 发布页的 dbsyncer-2.1.2-bin.zip,配合 Temurin JDK 8 启动(官方脚本默认 -Xms3g -Xmx3g,测试机内存紧张,改为 1 GB 堆):
export JAVA_HOME=/path/to/jdk8u504-b01
cd dbsyncer-2.1.2
java -Xms512m -Xmx1g \
  -Djava.ext.dirs=$JAVA_HOME/jre/lib/ext:$PWD/lib \
  -Dspring.config.location=$PWD/conf/application.properties \
  -DLOG_HOME=$PWD/logs -Dfile.encoding=UTF-8 -Duser.timezone=Asia/Shanghai \
  -Duser.dir=$PWD org.dbsyncer.web.Application
# 日志:Started Application in 4.988 seconds
浏览器访问 http://127.0.0.1:18686,默认账号 admin/admin。为了让实验可复现,我没有在界面上点选,而是写了一个 Python 脚本 practice/run_demo.py,直接调用控制台背后的表单接口:/login 登录,/connector/add 建连接,/mapping/add 建驱动(打开 autoMatchTable 自动匹配同名表),/mapping/edit 切换全量、增量配置,/mapping/start 和 /mapping/stop 启停。
源库是一张 2 万行的 orders 表,包含两个时间列:updated_at 为 TEXT 格式的 2026-10-14 02:09:54,upd_ms 为毫秒时间戳。每组实验的流程完全相同:
1. 全量同步 2 万行,等待目标库行数追平;
2. 切换为定时增量,Cron 设为 */5 * * * * ?,过滤条件为“时间列 > $timestamp_begin$”;
3. 在源库新增 50 行、修改 10 行、物理删除 5 行;
4. 等待 14 秒(约 3 个轮询周期)后核对目标库。
全量阶段三组结果一致:2 万行 0.4 秒写完。作为参考,官方在 Linux 8 核 48 GB 机器上测得 1 亿行全量耗时 37 分 52 秒,增量 TPS 约 8000,峰值 10000。全量这部分没什么可挑剔的,问题都出在增量阶段。
三组对照实验的结果
脚本输出原样贴出:
[runa] full: target=20000 cost=0.4s
[runa] filter=updated_at forceUpdate=False: src=20045 dst=20000 insert=0/50 update=10/10 deleted_still_in_target=5/5
  scan log: data=[5000] data=[5000] data=[5000] data=[5000] data=[50] ...(每 5 秒一轮全表)
[runb] full: target=20000 cost=0.4s
[runb] filter=updated_at forceUpdate=True: src=20045 dst=20050 insert=50/50 update=10/10 deleted_still_in_target=5/5
  scan log: data=[5000] data=[5000] data=[5000] data=[5000] data=[45] ...(每 5 秒一轮全表)
[runc] full: target=20000 cost=0.4s
[runc] filter=upd_ms forceUpdate=True: src=20045 dst=20050 insert=50/50 update=10/10 deleted_still_in_target=5/5
  scan log: data=[60]
整理成表格:
| 实验 | 过滤列 | 覆盖开关 | 新增 50 | 修改 10 | 物理删除 5 | 每轮扫描量 |
|---|---|---|---|---|---|---|
| A | updated_at(TEXT) |
关 | 0 条到达 | 10 条到达 | 未同步 | 全表约 2 万行 |
| B | updated_at(TEXT) |
开 | 50 条到达 | 10 条到达 | 未同步 | 全表约 2 万行 |
| C | upd_ms(毫秒数值) |
开 | 50 条到达 | 10 条到达 | 未同步 | 仅 60 行 |
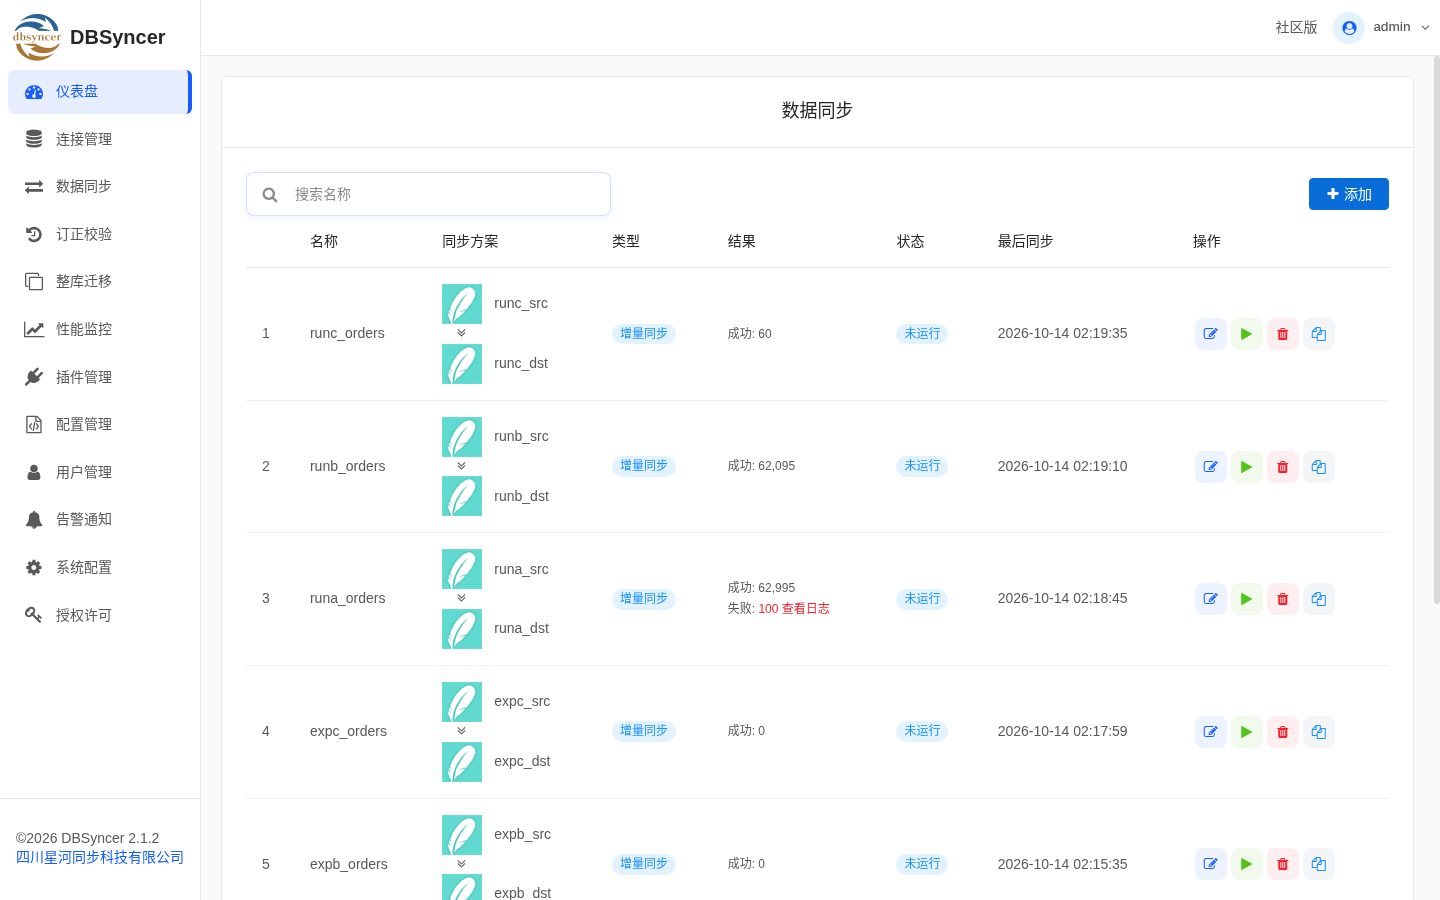
控制台“数据同步”列表把代价暴露得很直白:实验 A、B 的“结果”一栏都显示成功 6.2 万行以上,几乎全部来自增量阶段那二十多秒里的重复全表扫描;实验 C 只有 60 行。
坑一:时间列类型不对,过滤条件会静默失效
实验 A、B 的日志里,每个周期都是 4 页 5000 行加一个尾页,说明过滤条件根本没起作用,每 5 秒都在全表扫描。
原因在 $timestamp_begin$ 的实现。DBSyncer 的定时过滤支持 8 个系统参数($timestamp_begin$、$timestamp_end$、$date_begin$、$date_yes_begin$ 等),其中 TimestampFilter 返回的是 java.sql.Timestamp,断点以毫秒数字保存。在控制台的“定时”配置区可以直接看到这个断点值:0$timestamp_begin$ = 1791915565001。
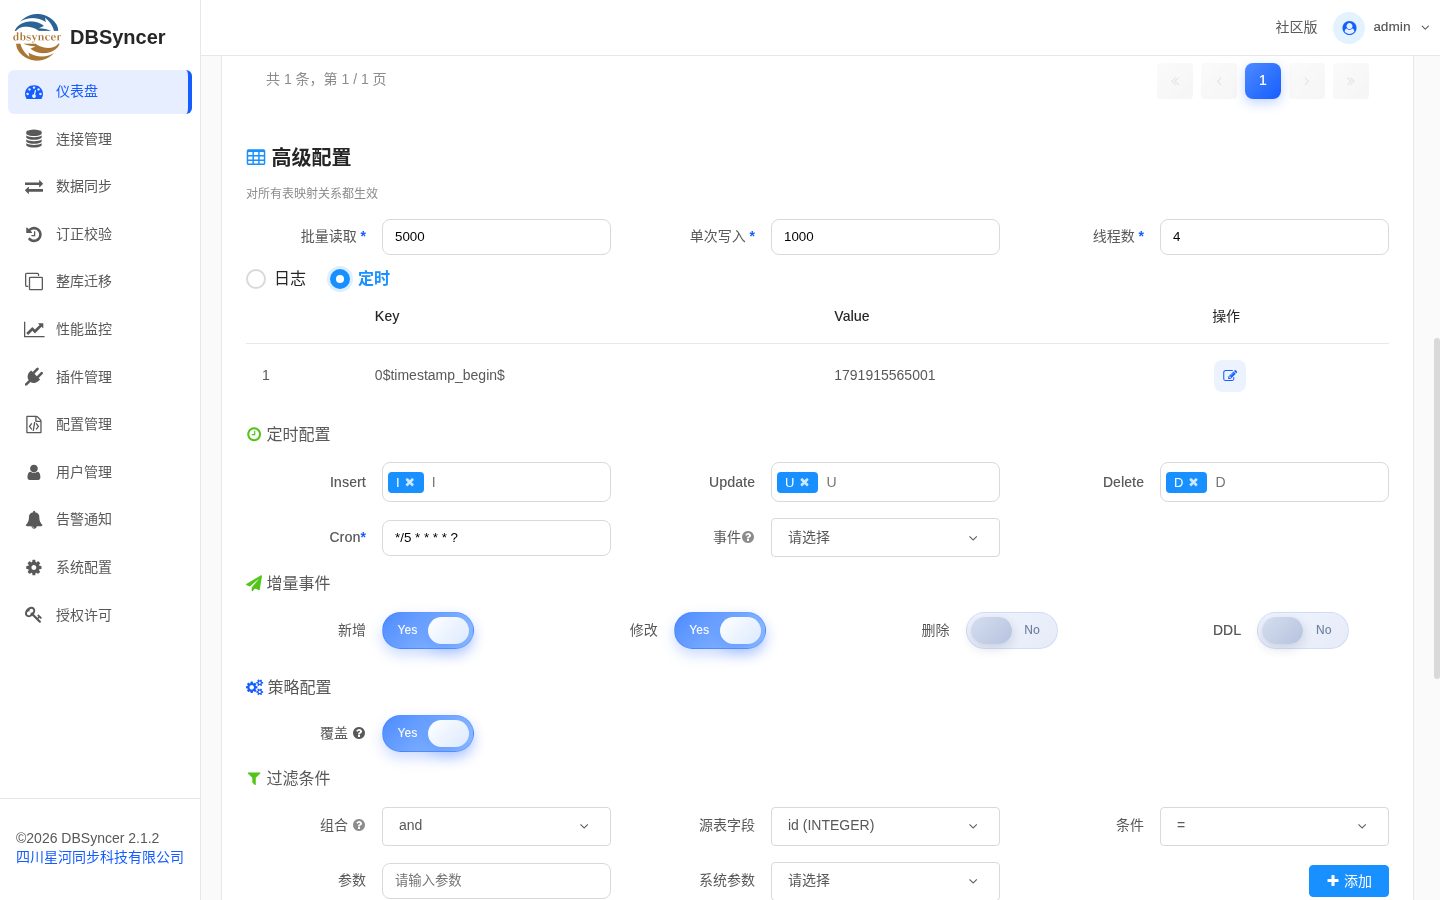
SQLite 是动态类型,比较规则是“TEXT 永远大于数值”。于是 updated_at > 1791915565001 对每一行都成立,条件恒为真。整个过程不报错,任务显示成功,只是每轮把全表重新同步一遍。在 MySQL、PostgreSQL 这类强类型数据库里,DATETIME 列与 Timestamp 参数可以正常比较,这个问题不会出现。但只要时间存在字符串列里,或者源库像 SQLite 一样做隐式类型转换,就会中招。
实验 C 换成数值型的毫秒列后,每轮只读到真正变化的 60 行(50 条新增加 10 条修改),这才是定时增量应有的样子。
排查技巧:打开
logs/info.log,搜索驱动名[表名], data=[。如果每个周期打印的数字接近全表行数,就说明过滤条件没生效。
坑二:覆盖开关一关,新增数据全部丢失
实验 A 的修改都到了,新增却一条没到。这和定时模式的事件判定方式有关。
AbstractQuartzListener.start() 里有这样一段逻辑:如果没有配置“事件字段”,就看增量事件开关,开了“修改”就把每一行都当成 UPDATE。这是合理的,因为轮询拿到的只是行,并不知道这行是新是旧。真正决定新行能否写进目标库的,是写入端 AbstractDatabaseConnector 的分支:
} else if (context.isForceUpdate()) {
    // 开启覆盖
    executeSql = context.getCommand().get(ConnectorConstant.OPERTION_UPSERT);
} else if (isUpdate(event)) {
    // 修改操作
    executeSql = context.getCommand().get(event);
}
覆盖开关(forceUpdate)打开时,写入走 UPSERT,目标表不存在的行会被插入;关闭时走普通 UPDATE,主键在目标表里不存在就影响 0 行,这批新增被静默跳过。
更隐蔽的是默认值。Mapping 模型里 forceUpdate 默认是 true,但 MappingChecker 每次保存驱动时,会把它设为“请求里有没有这个参数”。界面上这个开关默认是打开的,所以手动操作一般不会出事;而用脚本或 OpenAPI 改配置时,如果漏传这个参数,覆盖就被悄悄关掉了。实验 A 正是这样复现出来的。
坑三:物理删除永远到不了目标库
三组实验里,源库删掉的 5 行在目标库里都还在。这不是配置问题,而是轮询模式的原理限制:被 DELETE 的行已经不在源表里,SELECT 自然查不到。
DBSyncer 给出的解法是“事件字段”。在定时配置里指定一列作为事件标识,并设置 Insert、Update、Delete 对应的取值(默认是 I、U、D)。轮询读到一行后,按这一列的值决定发出哪种事件,读到 D 就在目标库执行删除。这要求源表改为软删除:业务代码不再物理删除,而是把该列更新为 D,同时刷新时间列,让这行能被下一轮轮询命中。
如果源表结构不能改,就只剩两条路:源库支持的话改用日志模式;或者定期跑一次全量比对(DBSyncer 的“订正校验”模块就是做这个的)。
附:SQLite 连接器的大整数缺陷
第一轮实验我把毫秒列声明为 INTEGER,结果全量阶段一行都没写进去,error.log 里刷满了这条:
SQLiteIntType does not support type [class java.lang.Long] convert to upd_ms(INTEGER), val [1789089360000]
看源码就明白了:SQLite 连接器把 INTEGER 列映射到 IntType(Java int),而 SQLiteIntType.merge() 遇到 Long 时直接抛出“不支持”。SQLite 的 INTEGER 实际是 64 位,毫秒时间戳、雪花 ID 这类超过 21 亿的值都会触发这个问题。这次测试用的是 2.1.2 版,我核对了 GitHub master 分支 10 月 12 日的代码,这段实现仍未改动。
临时绕过办法是把这类列声明为 REAL。SQLite 比较时仍按数值处理,DBSyncer 则走 Double 类型的转换,实验 C 就是这样跑通的。如果主键本身就是大整数,这个绕过办法就不适用了,只能等上游修复,或者自己写插件、改连接器。
插件扩展:用 SPI 自定义转换逻辑
字段映射和内置转换不够用时,DBSyncer 允许上传自定义插件。插件接口在 dbsyncer-sdk 的 org.dbsyncer.sdk.spi.PluginService,核心是三个钩子:
public interface PluginService {
    default void init() {}
    // 全量同步 / 定时增量同步前置处理
    default void postProcessBefore(PluginContext pluginContext) {}
    // 全量同步 / 增量同步时对数据做转换
    void convert(PluginContext pluginContext);
    // 写入目标库之后的后置处理
    default void postProcessAfter(PluginContext pluginContext) {}
    default String getVersion() { return "1.0.0"; }
    default String getName() { return getClass().getSimpleName(); }
}
PluginContext 提供 getEvent()(事件类型)、getSourceList() 和 getTargetList()(源行与目标行)。比如要在写入前给手机号打码、把状态码翻译成中文,或者在 postProcessAfter 里给下游发通知,实现 convert 和 postProcessAfter 即可。下面是一个打码插件的示意(未在本次实验中编译验证):
public class MaskPhonePlugin implements PluginService {
    @Override
    public void convert(PluginContext ctx) {
        for (Map row : ctx.getTargetList()) {
            Object phone = row.get("phone");
            if (phone instanceof String && ((String) phone).length() == 11) {
                String p = (String) phone;
                row.put("phone", p.substring(0, 3) + "****" + p.substring(7));
            }
        }
    }
}
打包时在 META-INF/services/org.dbsyncer.sdk.spi.PluginService 中注册实现类,然后在“插件管理”页面上传 JAR,驱动的高级配置里就能选择这个插件。仓库自带的 DemoPluginServiceProvider 可以作为模板。
选型建议:先确认增量能拿到什么
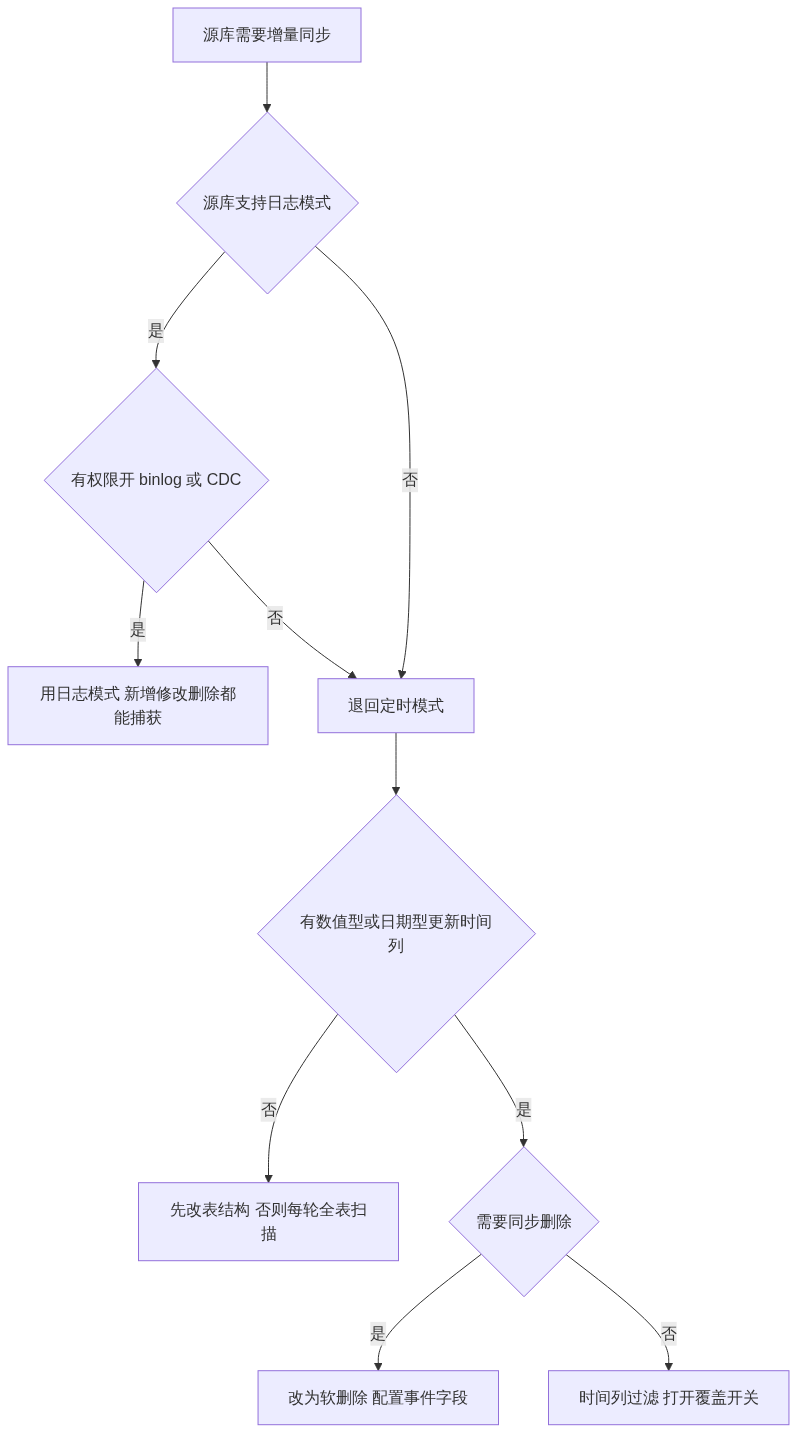
把实验结论落到操作上,就是一份上线前的检查清单:
| 检查项 | 怎么验证 | 不满足的后果 |
|---|---|---|
| 增量方式 | 驱动详情里看是“日志”还是“定时” | 定时模式拿不到物理删除 |
| 时间列类型 | 确认是数值型或 DATETIME 等日期类型,而非字符串 | 过滤条件恒真,每轮全表扫描 |
| 覆盖开关 | 驱动“策略配置”里确认处于打开状态,脚本改配置时显式传 forceUpdate |
新增行被当成 UPDATE 静默丢弃 |
| 轮询扫描量 | info.log 中 data=[...] 是否接近全表行数 |
源库压力和同步量成倍放大 |
| 大整数列 | SQLite 源或目标中是否有超过 21 亿的 INTEGER 值 | 整批写入失败 |
| 元数据存储 | 生产环境把 storage 切到 MySQL | 本地磁盘存储无法做集群高可用 |
另外两条部署层面的提醒:官方 Docker 命令给容器分配了 -m 5g,启动脚本默认 3 GB 堆,小规格机器要相应调低;连 MySQL 5.x 需要手动换成 5.1.x 的驱动,自带的是 8.0.21。
总结
DBSyncer 把异构同步做成了“连接器 × 监听器”的组合,全量性能和连接器覆盖面都不错,控制台也足够直观。但“定时增量”这个名字容易让人误以为它和 binlog 同步只是实现不同、效果相同,实际差别很大:它依赖时间列的类型,依赖覆盖开关,并且天生看不到物理删除。三组对照实验说明,这三个问题都不会报错,任务照样显示成功。
源库支持日志模式时优先用日志模式;只能用定时模式时,在上线前花十分钟把上面的检查清单过一遍,并对照 info.log 里每轮的扫描量做一次核对。
参考资料:DBSyncer GitHub / Gitee 仓库 README 与源码(master 分支,2026-10-12)、DBSyncer 官方 Wiki 性能测试章节。
💡 在线实战体验:本文配套免安装的云端 Linux 交互式实验环境与终端操作,可在 边学边练平台 (https://www.skillup.host/) 直接体验运行验证。