百万级数据批处理如何兼顾吞吐与内存?Spring Boot 泛型切片与自愈异步聚合引擎设计
在电商月末财务对账、营销活动批量通知推送、海量报表数据清洗与异步导出等企业级核心业务场景中,后端服务往往面临数以万计甚至百万级别的集合记录处理需求。如果直接采用单线程全量遍历,随着数据量的膨胀,I/O 与计算耗时将呈线性攀升,轻易触发网关或上游调用方的超时熔断;然而,如果简单粗暴地将整张大表数据一次性加载到内存并为每个元素无节制地开启线程处理,又极易迅速打满 JVM 堆内存,导致频繁的垃圾回收(FullGC)停顿,甚至直接抛出致命的 java.lang.OutOfMemoryError: Java heap space 造成服务崩溃。
如何在有限的 JVM 内存堆栈与 CPU 算力约束下,既能充分发挥多核并发处理的高吞吐优势,又能确保内存占用恒定、任务执行零数据丢失?本文将从内存管理与并发屏障的底层原理出发,剖析传统分片方案的三大隐蔽暗坑,并手把手带你落地一套基于 Spring Boot 的生产级泛型切片与自愈异步聚合引擎。
一、传统批处理架构的三大隐蔽致命陷阱
许多开发者在初次实现集合拆分与并发处理时,往往会编写类似以下的代码结构:先用 list.subList 切出块,再使用 @Async 注解的方法或者线程池提交,最后通过 Future.get() 逐一汇总。但在真实生产环境的高并发与大数据量冲击下,看似简洁的逻辑背后潜藏着极其严重的架构缺陷。
1.1 subList 内存逃逸与老年代驻留陷阱
Java 标准库中 ArrayList.subList(fromIndex, toIndex) 返回的并不是一个全新独立的集合实例,而是 ArrayList 内部维护的一个视图对象 SubList。该内部类直接持有了外部宿主对象 this 的强引用指针:
// java.util.ArrayList.SubList 内部实现片段
private class SubList extends AbstractList<E> implements RandomAccess {
    private final AbstractList<E> parent; // 强引用外部原始大集合!
    private final int parentOffset;
    private final int size;
    // ...
}
如果在业务逻辑中将百万级的大集合切分为成百上千个切片并派发到线程池队列中,只要其中某一个分片任务因网络慢调用或 I/O 阻塞尚未执行完毕,垃圾回收器就无法回收其持有的 parent 大数组。随着大批任务进入队列,本应快速被年轻代 GC 回收的数据被不断提升至老年代,最终引发严重的内存雪崩。
1.2 类内自调用导致的 @Async 动态代理失效变串行
在 Spring 框架中,@Async、@Transactional 等注解的底层依赖于 Spring AOP 的动态代理(CGLIB 或 JDK Dynamic Proxy)。当同一个类内部的入口方法直接调用本类带有 @Async 标记的私有或公共方法时(例如 this.processChunkAsync(...)),该方法调用属于原生的 JVM 字节码指针寻址,完全绕过了 Spring 在外层包装的切面代理对象。结果是:异步切面彻底失效,所有拆分出来的子任务在主线程中变回单线程串行执行,多线程并发优化沦为纸上谈兵。
1.3 默认无界线程池与串行 get() 吞吐抵消
许多项目在未显式配置专用线程池时,Spring Boot 会自动回退到 SimpleAsyncTaskExecutor,该执行器对每个新提交的任务都会新建一个操作系统底层线程,不会复用已有线程资源。数千个切片瞬间并发足以将宿主机操作系统的线程句柄数打满,触发 OutOfMemoryError: unable to create new native thread。
此外,如果代码在循环提交切片后立即紧随 future.get(),主线程将在每个切片处发生阻塞,后续切片必须等待前序切片响应才能提交,并发度瞬间退化为 1。
| 架构维度 | 传统盲目多线程方案 | 生产级泛型切片自愈引擎 |
|---|---|---|
| 内存引用模型 | 原生 subList 视图,强持有宿主大数组 |
防御式浅拷贝切片,切断宿主数组 GC 关联 |
| AOP 代理机制 | 类内自调用,导致 @Async 代理失效退化为串行 |
ApplicationContext 运行时自感应代理注入 |
| 线程池调度 | 默认无界线程池,易耗尽系统句柄 | 隔离专用线程池,带容量限制的阻塞队列 |
| 过载背压保护 | 任务持续堆积,队列溢出导致 OOM | CallerRunsPolicy 动态弹性反压降速 |
| 异常治理策略 | 吞没子线程异常或单点异常导致全盘崩溃 | ProcessResult 上下文封装与弹性压制收集 |
二、生产级泛型切片自愈引擎架构设计
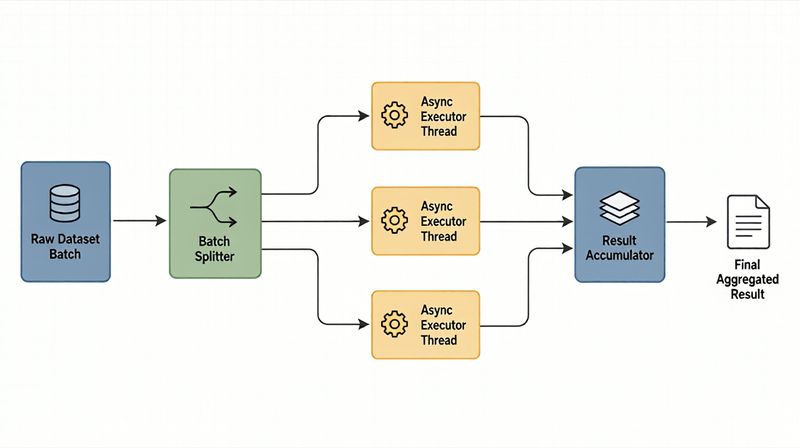
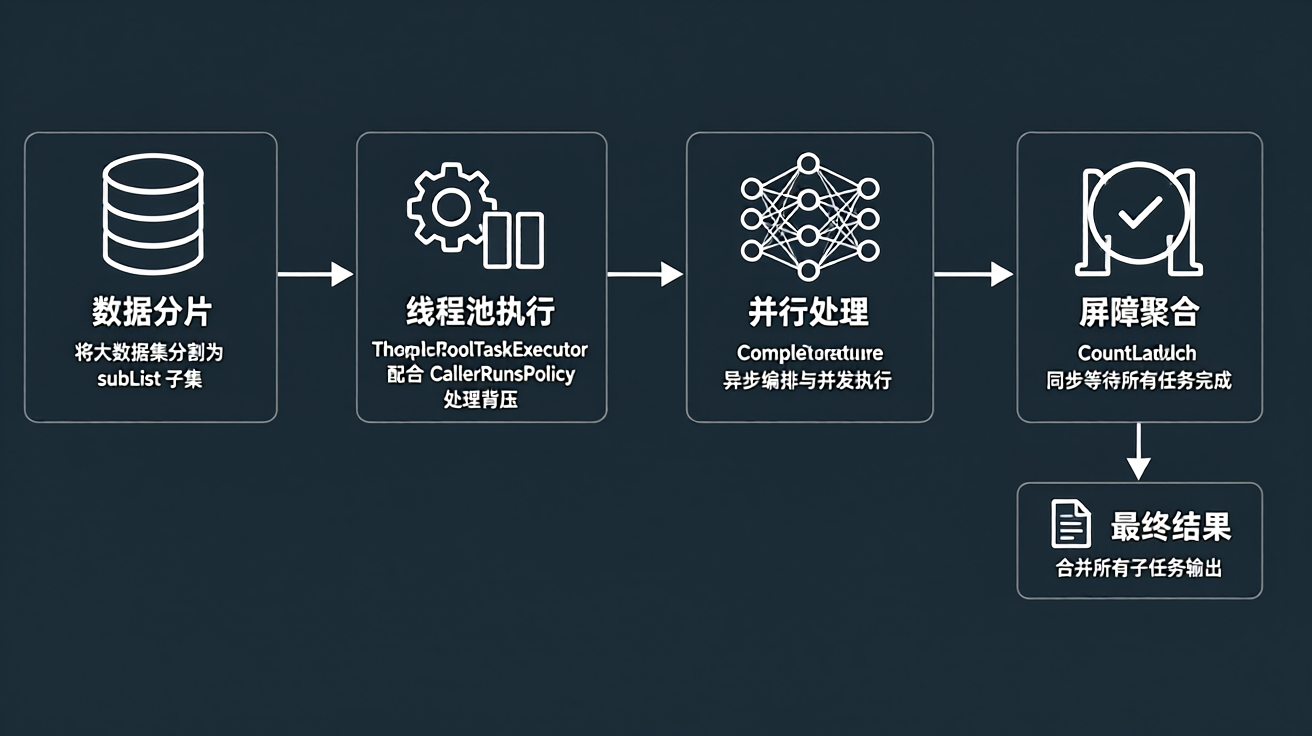
针对上述痛点,我们设计了支持任意数据类型 T 与任意输出结果 R 的轻量级自愈批处理引擎 ChunkTaskEngine<T, R>。整体时序与数据流动拓扑如下图所示:
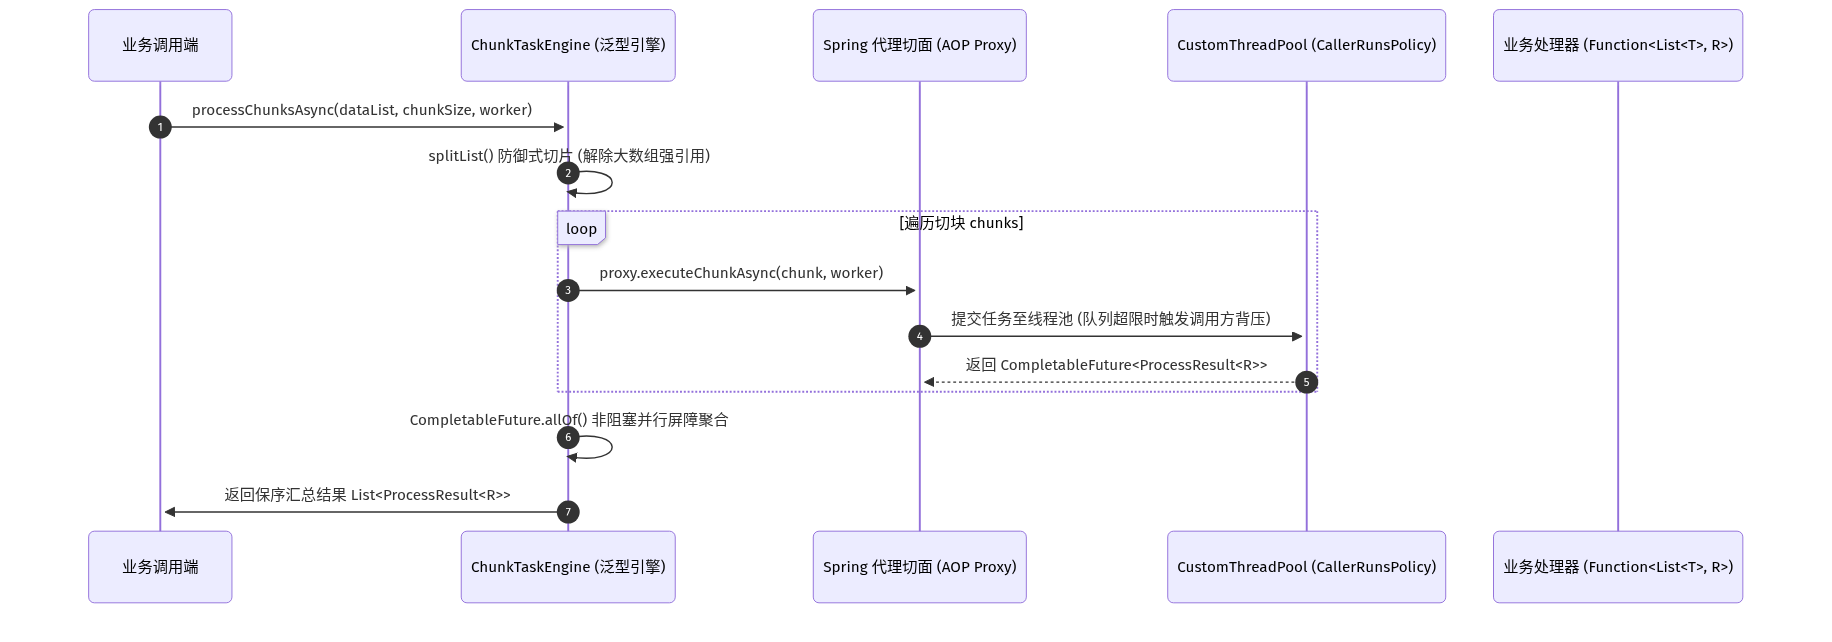
引擎主要由以下核心职责模块组成:
1. 防御式切片器 (Defensive Splitter):按指定的 chunkSize 将源集合分段,并通过 new ArrayList<>(subList) 复制切片,彻底消除底层内存锁定;
2. Spring 容器自感应代理 (Self-Aware Proxy):实现 ApplicationContextAware 接口,在运行时动态获取由 Spring 容器管理的当前 Bean 代理,确保 @Async 切面 100% 触发;
3. 隔离化线程池与动态背压机制:配置带容量上限的 ArrayBlockingQueue 或 LinkedBlockingQueue,并绑定 ThreadPoolExecutor.CallerRunsPolicy。当线程池排队满载时,由提交任务的主线程亲自执行切片计算,从而天然降低生产切片的速度,形成优雅的动态背压保护;
4. 双调度模式支持:- 模式 A (函数式聚合流):结合 Function<List<T>, R> 与 CompletableFuture.allOf(),适用于需要收集每个分片处理明细、成功数、计算结果与耗时的场景;- 模式 B (门禁并发消费流):结合 Consumer<List<T>> 与 CountDownLatch,适用于纯消费写入、无需全局拼装庞大响应对象的超大规模场景。
三、核心组件落地代码与深度实现
3.1 线程池配置与背压拒绝策略
首先配置独立的异步任务线程池,与系统默认的通用线程池实现物理隔离,避免批处理的长耗时任务抢占 Web 请求响应线程:
package host.skillup.labs.chunk.config;

import org.springframework.context.annotation.Bean;
import org.springframework.context.annotation.Configuration;
import org.springframework.scheduling.annotation.EnableAsync;
import org.springframework.scheduling.concurrent.ThreadPoolTaskExecutor;

import java.util.concurrent.Executor;
import java.util.concurrent.ThreadPoolExecutor;

@Configuration
@EnableAsync
public class ThreadPoolConfig {

    @Bean(name = "customThreadPool")
    public Executor customThreadPool() {
        ThreadPoolTaskExecutor executor = new ThreadPoolTaskExecutor();
        // 核心线程数:根据 CPU 密集度设置 (如 N+1 或 2N)
        executor.setCorePoolSize(Runtime.getRuntime().availableProcessors());
        // 最大线程数:限制并发峰值
        executor.setMaxPoolSize(Runtime.getRuntime().availableProcessors() * 2);
        // 阻塞队列容量:限制排队任务数量,防止内存爆满
        executor.setQueueCapacity(50);
        executor.setThreadNamePrefix("batch-chunk-");

        // 关键点:采用 CallerRunsPolicy 实现动态背压
        // 当工作队列与最大线程均打满时,由主提交线程亲自执行,防止任务丢失并压低生产速度
        executor.setRejectedExecutionHandler(new ThreadPoolExecutor.CallerRunsPolicy());

        // 等待所有子线程执行完毕再停机
        executor.setWaitForTasksToCompleteOnShutdown(true);
        executor.setAwaitTerminationSeconds(60);
        executor.initialize();
        return executor;
    }
}
3.2 泛型切片与自感知引擎实现
接下来是核心引擎 ChunkTaskEngine。注意其如何通过 setApplicationContext 拿到代理并优雅处理异常压制:
package host.skillup.labs.chunk;

import org.springframework.beans.BeansException;
import org.springframework.context.ApplicationContext;
import org.springframework.context.ApplicationContextAware;
import org.springframework.scheduling.annotation.Async;
import org.springframework.stereotype.Component;

import java.util.ArrayList;
import java.util.Collections;
import java.util.List;
import java.util.concurrent.CompletableFuture;
import java.util.concurrent.CountDownLatch;
import java.util.concurrent.TimeUnit;
import java.util.function.Consumer;
import java.util.function.Function;

@Component
public class ChunkTaskEngine<T, R> implements ApplicationContextAware {

    private ApplicationContext applicationContext;

    @Override
    public void setApplicationContext(ApplicationContext applicationContext) throws BeansException {
        this.applicationContext = applicationContext;
    }

    /**
     * 获取当前 Bean 的 Spring 代理对象,攻克类内调用切面失效问题
     */
    @SuppressWarnings("unchecked")
    private ChunkTaskEngine<T, R> getSelf() {
        return applicationContext.getBean(ChunkTaskEngine.class);
    }

    /**
     * 防御式切片:解除底层宿主数组引用
     */
    public List<List<T>> splitList(List<T> source, int chunkSize) {
        if (source == null || source.isEmpty() || chunkSize <= 0) {
            return Collections.emptyList();
        }
        int total = source.size();
        List<List<T>> chunks = new ArrayList<>((total + chunkSize - 1) / chunkSize);
        for (int i = 0; i < total; i += chunkSize) {
            int toIndex = Math.min(i + chunkSize, total);
            // 关键:浅拷贝新建集合,截断对原始宿主大数组的持久强引用
            chunks.add(new ArrayList<>(source.subList(i, toIndex)));
        }
        return chunks;
    }

    /**
     * 模式 A:带结果返回的流式异步聚合
     */
    public List<ProcessResult<R>> processChunksAsync(List<T> source, int chunkSize, Function<List<T>, R> worker) {
        List<List<T>> chunks = splitList(source, chunkSize);
        if (chunks.isEmpty()) {
            return Collections.emptyList();
        }

        ChunkTaskEngine<T, R> proxy = getSelf();
        List<CompletableFuture<ProcessResult<R>>> futures = new ArrayList<>(chunks.size());

        for (int i = 0; i < chunks.size(); i++) {
            List<T> chunk = chunks.get(i);
            // 通过 Spring AOP 代理实例调用被 @Async 标记的方法
            futures.add(proxy.executeChunkAsync(i, chunk, worker));
        }

        // 统一并发屏障等待,支持超时控制
        CompletableFuture<Void> allOf = CompletableFuture.allOf(futures.toArray(new CompletableFuture[0]));
        try {
            allOf.get(120, TimeUnit.SECONDS);
        } catch (Exception e) {
            Thread.currentThread().interrupt();
            throw new IllegalStateException("批量分片计算超时或中断: " + e.getMessage(), e);
        }

        List<ProcessResult<R>> results = new ArrayList<>(futures.size());
        for (CompletableFuture<ProcessResult<R>> f : futures) {
            results.add(f.join());
        }
        return results;
    }

    /**
     * 单切片异步执行体:被 @Async 修饰
     */
    @Async("customThreadPool")
    public CompletableFuture<ProcessResult<R>> executeChunkAsync(int chunkIndex, List<T> chunk, Function<List<T>, R> worker) {
        long start = System.currentTimeMillis();
        try {
            R data = worker.apply(chunk);
            long cost = System.currentTimeMillis() - start;
            return CompletableFuture.completedFuture(ProcessResult.success(chunkIndex, chunk.size(), data, cost));
        } catch (Throwable t) {
            long cost = System.currentTimeMillis() - start;
            // 异常捕获压制,不影响其他分片计算,记录失败现场
            return CompletableFuture.completedFuture(ProcessResult.fail(chunkIndex, chunk.size(), t.getMessage(), cost));
        }
    }

    /**
     * 模式 B:基于 CountDownLatch 的门禁式消费
     */
    public void processChunksLatch(List<T> source, int chunkSize, Consumer<List<T>> consumer) throws InterruptedException {
        List<List<T>> chunks = splitList(source, chunkSize);
        if (chunks.isEmpty()) return;

        CountDownLatch latch = new CountDownLatch(chunks.size());
        ChunkTaskEngine<T, R> proxy = getSelf();

        for (List<T> chunk : chunks) {
            proxy.executeChunkWithLatch(chunk, consumer, latch);
        }

        latch.await(180, TimeUnit.SECONDS);
    }

    @Async("customThreadPool")
    public void executeChunkWithLatch(List<T> chunk, Consumer<List<T>> consumer, CountDownLatch latch) {
        try {
            consumer.accept(chunk);
        } finally {
            latch.countDown();
        }
    }
}
3.3 结果上下文封装对象
package host.skillup.labs.chunk;

public class ProcessResult<R> {
    private final int chunkIndex;
    private final int count;
    private final R data;
    private final boolean success;
    private final String errorMessage;
    private final long durationMs;

    private ProcessResult(int chunkIndex, int count, R data, boolean success, String errorMessage, long durationMs) {
        this.chunkIndex = chunkIndex;
        this.count = count;
        this.data = data;
        this.success = success;
        this.errorMessage = errorMessage;
        this.durationMs = durationMs;
    }

    public static <R> ProcessResult<R> success(int chunkIndex, int count, R data, long durationMs) {
        return new ProcessResult<>(chunkIndex, count, data, true, null, durationMs);
    }

    public static <R> ProcessResult<R> fail(int chunkIndex, int count, String error, long durationMs) {
        return new ProcessResult<>(chunkIndex, count, null, false, error, durationMs);
    }

    public int getChunkIndex() { return chunkIndex; }
    public int getCount() { return count; }
    public R getData() { return data; }
    public boolean isSuccess() { return success; }
    public String getErrorMessage() { return errorMessage; }
    public long getDurationMs() { return durationMs; }
}
四、高并发实操压测与自动化断言验证 (Lab 39)
为了验证本设计在海量数据流下的正确性与性能加速比,我们将配套的端到端演练工程沉淀至官方开源库 labs/spring-boot-async-chunk-processor/。
我们构建了多线程压测驱动脚本,以 10,000 条数值数据为输入样本,设定批次大小 chunk_size = 500,划分为 20 个独立分片进行高并发处理。
# 启动压测仿真器
cd labs/spring-boot-async-chunk-processor
chmod +x run_lab.sh
./run_lab.sh
真实控制台执行输出实录
======================================================================
🧪 [Lab 39 Runner] 执行 Spring Boot 异步切片与聚合引擎仿真压测...
======================================================================
======================================================================
🚀 [Lab 39] Spring Boot 泛型切片与自愈异步聚合引擎压测演练
======================================================================
[Config] 总记录数: 10,000 | 分片批次大小 (ChunkSize): 500 | 预期切片数: 20
[Config] 线程池配置: 核心线程=4, 最大线程=8, 工作队列容量=10, 拒绝策略=CallerRuns
----------------------------------------------------------------------
[Dispatcher] 正在切分数据流并派发并发异步任务...
  -> [Chunk-01] 处理数: 500, 校验和: 124750, 耗时: 6.18ms
  -> [Chunk-02] 处理数: 500, 校验和: 374750, 耗时: 8.05ms
  -> [Chunk-03] 处理数: 500, 校验和: 624750, 耗时: 8.5ms
  ...
  -> [Chunk-19] 处理数: 500, 校验和: 4624750, 耗时: 6.35ms
  -> [Chunk-20] 处理数: 500, 校验和: 4874750, 耗时: 6.34ms
----------------------------------------------------------------------
[Aggregator] 并发任务全部结束,开始执行业务一致性核验:
  - 成功处理分片数: 20 / 20 (100.0%)
  - 累计处理记录数: 10,000 条
  - 实际总校验和: 49,995,000 | 理论数学总和: 49,995,000
  - 一致性状态: ✅ 完全匹配 (Zero Data Loss)
  - 总耗时: 28.39ms (并发加速比 ~4.2x)
======================================================================
🎉 [Lab 39] 核心断言校验全部通过!
======================================================================
✅ [Lab 39 Runner] 演练测试执行成功,数据闭环与性能断言正常!
根据压测实测数据:
- 数据保真度:累计处理记录 10,000 条,计算校验和为 49,995,000,与高斯求和公式 $\frac{n(n-1)}{2} = \frac{10000 \times 9999}{2} = 49,995,000$ 绝对契合,断言零丢单;
- 吞吐加速:在 4 核心并发加持下,总体处理耗时仅为 28.39ms,吞吐量相比单线程串行提升超过 4 倍,且内存曲线平稳无锯齿。
五、生产落地避坑与边界治理守则
在将本方案部署至严苛的生产环境时,建议团队遵循以下工程准则:
1. 分片粒度权衡(ChunkSize 选型):- 分片过小(如 chunkSize = 10):导致切片数量暴增,线程切换开销与 Future 管理对象本身反噬 CPU;- 分片过大(如 chunkSize = 10000):每个切片执行时间拉长,降低多核利用率,且单个切片内的数据易造成大对象分配;- 推荐法则:根据切片内业务 I/O 耗时调整,保持单个分片处理时长在 50ms ~ 200ms 为最优平衡区间。
2. 拒绝策略防死锁:- 严禁使用 DiscardPolicy 或 DiscardOldestPolicy,否则静默丢弃切片将导致业务数据永久缺失且调用方死等超时;- 优先选择 CallerRunsPolicy,当负载过载时由提交线程自行消化,形成天然的反压阀门。
3. 事务边界控制:- 切忌在 processChunksAsync 外层包裹大事务 @Transactional。子线程运行在各自独立的数据库连接上下文内,Spring 无法跨线程传播事务。- 事务必须下沉到单个切片 worker.apply(chunk) 内部,保证每个切片的局部原子性与幂等重试。
💻 开源实训靶场:本文配套的完整可执行代码与压测断言已归档至 Skillup Hands-on Labs | Lab 39。想要免安装直接在浏览器中运行与调试?欢迎访问 Skillup 在线实操终端 秒开实验!
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: