让大模型自己看懂代码库:基于AST语义解析的开源仓库自动化Agent技能提取实践
随着大语言模型(LLM)从单纯的文本对话向自主智能体(Autonomous Agent)与工具调用(Tool Calling)演进,开发者面临的工程重心正在发生转移。过去,我们需要针对每一个业务 API 或开源工具包,手工编写繁琐的 JSON Schema、工具描述(Tool Definitions)以及调用接口。当面对一个包含数十个模块、数百个底层 API 的大型开源项目时,手动接入的工作量几乎令人望而却步。
为了让大语言模型真正能够“即插即用”地调用任意开源仓库的能力,社区开始探索自动化技能抽取管道(Codebase-to-Skill Pipeline):直接将一个成熟的 GitHub 仓库转化为符合 Agent 规范的专属技能包(如 Antigravity Skill、Claude Skill 或 MCP Server)。而支撑这一自动化转换的基石,正是编译原理中经典的抽象语法树(Abstract Syntax Tree, AST)。
文本切分的失真危机:为什么必须回归 AST?
在早期尝试中,许多方案试图采用简单的正则表达式或基于 LLM 的全量代码提示词来提取函数信息。然而在真实的工业级代码库中,这种弱类型文本切分方案极易在以下场景中彻底崩溃:
1. 复杂跨行装饰器与类型嵌套:现代代码大量使用 @dataclass、@validator 以及复杂的联合泛型(如 Union[Dict[str, List[int]], None]),正则表达式几乎无法可靠切分跨行参数签名;
2. 上下文污染与私有实现泄露:源码中存在大量以下划线开头的私有辅助函数、内部锁机制与魔术方法(Magic Methods),若不做语法级树状过滤,会向 LLM 暴露过多无用的底层杂音;
3. 文档与参数错位:Docstring 可能采用 Google、Sphinx 或 NumPy 等不同风格,纯文本匹配极难建立“入参名称”与“说明段落”之间的强约束绑定。
抽象语法树(AST)将源代码解析为带有强类型语义的层次节点树,能够在毫秒级内无歧义地遍历模块、类、方法、参数注解及文档节点,是实现高确定性语义抽取的唯一可靠途径。
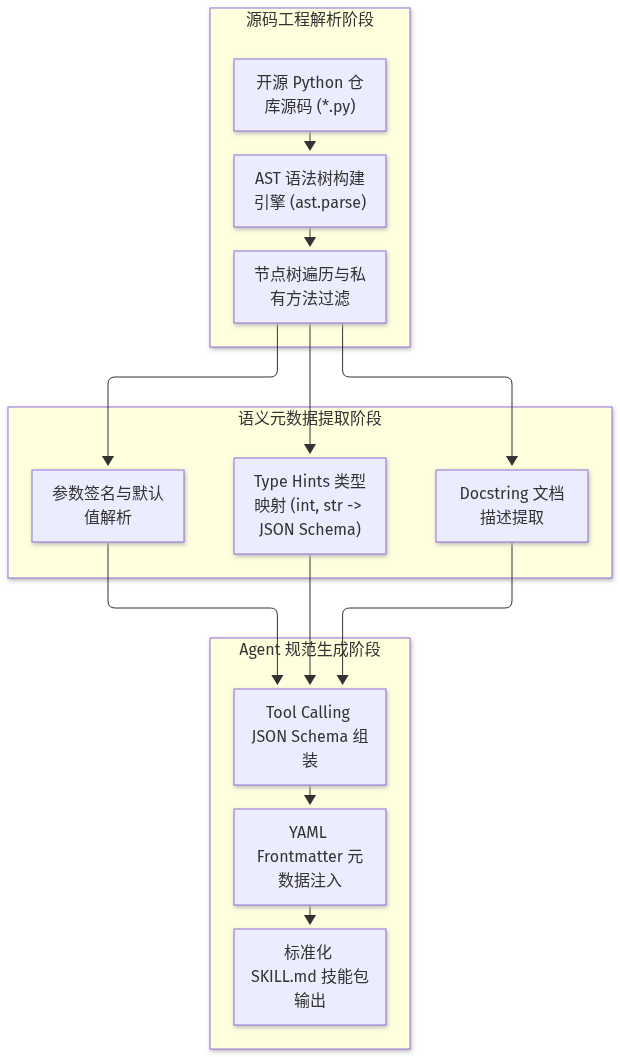
自动化技能抽取流水线的工程设计
一套完整的开源仓库技能提取引擎通常划分为三个核心阶段:
1. 语法树遍历与公有 API 识别
利用 Python 内置的 ast 模块将代码解析为根节点,通过 ast.iter_child_nodes 检索顶层 FunctionDef 与 ClassDef。对于类方法,自动将类名与方法名拼接为全局唯一的工具调用标识(例如 ContainerOrchestrator_deploy_service),避免工具名在智能体全局上下文中发生重名冲突。
2. 参数类型推断与 JSON Schema 转换
大语言模型工具调用(如 Function Calling / MCP)依赖标准的 JSON Schema 规范。抽取器需要建立从编程语言类型注解到 JSON Schema 的类型映射字典:
str/Text$\rightarrow${"type": "string"}int$\rightarrow${"type": "integer"}float$\rightarrow${"type": "number"}bool$\rightarrow${"type": "boolean"}List[...]$\rightarrow${"type": "array"}Dict[...]$\rightarrow${"type": "object"}
对于具有默认值的可选参数,通过计算 args.defaults 的偏移量,精准判定哪些参数应放入 required 必填数组中,哪些作为可选参数呈现给大模型。
3. Agent 技能包组装与 Prompt 增强
提取出的结构化元数据最终被渲染为兼具机器可读性与人类可读性的 SKILL.md 文档。文档头部注入标准 YAML Frontmatter,正文清晰列出工具名称、参数类型、入参描述,并附带错误处理指引,供智能体在运行时动态装载并理解上下文。
实战演练:Lab 50 自动化 Agent 技能提取器
本项目已在开源实践仓库中完整归档了单文件零依赖的 AST 技能抽取引擎:
- 实战源码:
labs/ast-auto-agent-skill-extractor/repo_to_agent_skill.py - 演练说明:
labs/ast-auto-agent-skill-extractor/README.md - 在线实训:https://www.skillup.host/
可直接在终端中执行全量自检:
python3 labs/ast-auto-agent-skill-extractor/repo_to_agent_skill.py
在测试用例中,该抽取器能够精准解析多参数云监控函数与容器编排类方法,自动剔除 self 参数、正确标记必填项,并在 5 毫秒内生成合规的 SKILL.md 规范。
生产落地踩坑与降噪工程实践
在面对真实复杂的 GitHub 开源大型仓库时,将代码自动化转为 Agent 技能还需要解决以下现实问题:
1. 动态类型缺失的容错兜底:部分历史开源项目未编写 PEP 484 类型注解。此时如果完全放弃提取,会导致工具池覆盖率过低。推荐策略是“静态推断 + 宽松兜底”:优先从 Docstring 中提取 :type param: int 注释;若均缺失,则降级为泛型 string 并在描述中提示模型注意数据格式。
2. Monorepo 与冗余 API 爆炸:一个成熟的项目往往包含成百上千个底层函数,全部塞入模型的 Prompt 会直接引发上下文超载并降低召回准确率。应当支持白名单模块配置、基于导出项(__all__)解析,或者引入两阶段检索(Embedding 预选出 Top-K 相关工具再装载至上下文)。
3. 运行时沙盒隔离与执行安全:自动生成技能包仅仅是第一步,当模型实际触发工具调用时,必须将下游代码运行在受控的容器或轻量沙盒内,禁止工具直接读取宿主机私有凭证或执行高危网络外联。
让大模型直接“读懂”开源代码库并转化为即用型能力,标志着 AI 应用开发正在告别手工配置的作坊模式。利用 AST 编译器内核构建确定性的自动化技能提取流水线,将成为构建下一代自进化智能体生态的核心技术支点。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: