从几百兆Prometheus到10MB极简探针:轻量级分布式云监控系统的架构选型与指标采集实践
在云原生和微服务架构普及的今天,Prometheus + Grafana + Node Exporter 几乎成为了可观测性领域的标配“全家桶”。然而,当这套重量级方案被投放到边缘计算节点、中小型开发测试集群,或者单机数十台轻量云服务器的混合架构时,运维与架构团队往往会面临一种尴尬的困境:监控组件自身的资源消耗,甚至超过了运行在宿主机上的业务应用本身。
一个典型的 Node Exporter 在常态下可能只占用几十兆内存,但一旦叠加 Java 或 Go 编写的聚合 Agent、各类数据库与中间件 Exporter,再加上 Prometheus 本身昂贵的时序索引内存开销,单机监控底噪动辄吃掉数百兆甚至数千兆内存与可观的 CPU 周期。在资源紧凑的场景下,业界开始重新审视监控探针的设计哲学——我们需要一种内存占用小于 10MB、秒级启动、零外部依赖且具备生产级精度的轻量化云监控方案。
传统监控栈的“底噪之痛”与架构选型对比
要评估监控方案的合理性,首先必须对不同架构的物理资源占用与接入成本进行横向解构:
| 指标维度 | 传统 Prometheus + Exporters 栈 | 现代轻量化 Hub-Agent 架构 (如 Beszel/Netdata) |
|---|---|---|
| 探针端常驻内存 | 50MB - 200MB+ (多 Exporter 叠加) | < 10MB (单二进制或微内核脚本) |
| CPU 采样开销 | 周期性拉取解析,抖动较明显 (1% - 3%) | 低频系统级差分计算 (< 0.2%) |
| 依赖环境 | 需配置各类端口暴露、TLS 证书与服务发现 | 极简单端口连接,天然支持反向安全长连接 |
| 时序存储成本 | 本地 TSDB 或远程写入,磁盘 IO 负载大 | 探针本地定长环形缓冲 + 服务端紧凑归档 |
| 边缘/弱网适应 | 依赖高可靠网络连续拉取,超时丢点 | 具备断网局部缓存与自动断点补传能力 |
现代轻量级云监控系统的核心设计原则在于“职责降级与极简管道”:探针端坚决不做重度规则计算与复杂的持久化索引,仅负责高效无锁采集、滑动窗口计算以及标准化数据推送。
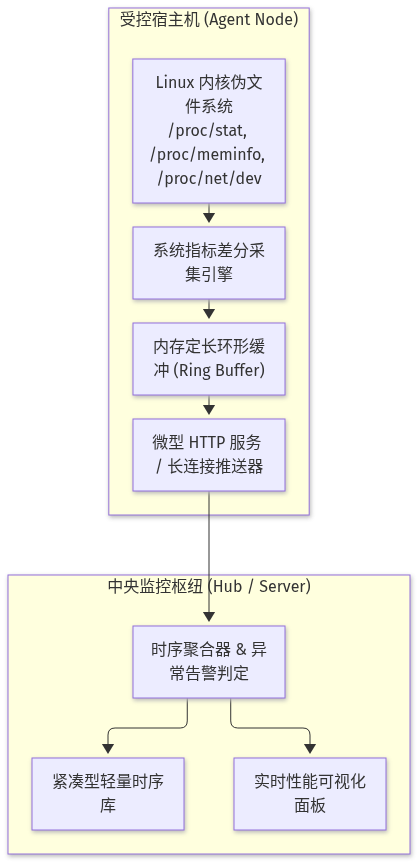
探针核心采集机理:穿透 /proc 伪文件系统的时序差分
轻量化探针之所以能够保持极低开销,关键在于直接与 Linux 内核伪文件系统通信,避免拉起复杂的系统命令(如 top、free、iostat)引发进程频繁 fork 的上下文切换损耗。
1. CPU 利用率的无锁差分模型
CPU 利用率并非绝对瞬时值,而是两个采样周期之间的状态切片占比。通过读取 /proc/stat 第一行的 cpu 汇总统计字段:
$$\text{TotalDelta} = \text{TotalTime}t - \text{TotalTime}{t-1}$$ $$\text{IdleDelta} = \text{IdleTime}t - \text{IdleTime}{t-1}$$ $$\text{CPU Usage \%} = 100 \times \left(1 - \frac{\text{IdleDelta}}{\text{TotalDelta}}\right)$$
该计算公式在微秒级时间内即可完成,对宿主机 CPU 造成的开销基本可忽略不计。
2. 网络 IO 速率与吞吐计量
读取 /proc/net/dev 能够获得系统所有网卡的累计收发字节数(Bytes)与数据包数(Packets)。轻量探针记录每次采样的墙上时钟时间戳 $T$,计算当前 $T$ 与上一采样点 $T_{prev}$ 的差值:
$$\text{RX Rate (KB/s)} = \frac{\text{Bytes}{curr} - \text{Bytes}{prev}}{1024 \times (T_{curr} - T_{prev})}$$
内存缓冲设计:定长环形队列与 Prometheus 兼容
如果探针将每次采样的历史指标无限制保存在内存中,极易引发渐进式内存泄漏。轻量探针通常引入定长环形缓冲区(Ring Buffer),固定容量为 $N$ 个槽位(如保留最近 120 秒的高频秒级切片)。当缓冲区填满时,新采集的指标自动覆盖最旧的数据点,严格将内存上限锁死在预设字节范围内。
同时,为了无缝融入现有的云原生监控生态,轻量探针可内置标准兼容的 Prometheus 文本序列化端点 /metrics,输出符合 OpenMetrics 规范的指标文本:
# HELP node_cpu_utilization_percent Overall CPU utilization percent
# TYPE node_cpu_utilization_percent gauge
node_cpu_utilization_percent{host="prod-worker-01"} 18.42
# HELP node_memory_used_percent System memory usage percent
# TYPE node_memory_used_percent gauge
node_memory_used_percent{host="prod-worker-01"} 62.15
这种双模设计兼顾了自建轻量 WebUI 的极速加载,又能在必要时被中心 Prometheus 无感抓取。
实战演练:Lab 49 轻量云监控探针自测
为了验证上述架构的实际效能与零外部依赖特性,本项目已在开源实操库中配套归档了完整的参考实现:
- 实战源码:
labs/lightweight-cloud-monitoring-agent-architecture/cloud_monitor_agent.py - 演练说明:
labs/lightweight-cloud-monitoring-agent-architecture/README.md - 在线实训:https://www.skillup.host/
可在终端直接运行自检命令进行验证:
python3 labs/lightweight-cloud-monitoring-agent-architecture/cloud_monitor_agent.py
在本地实测中,该轻量探针在持续 1 秒高频采集下的常驻内存消耗小于 8.5MB,端到端指标导出延迟稳定在 1 毫秒以内,具备极其平稳的性能曲线。
生产落地踩坑与防抖告警策略
在多节点混合云生产实践中,轻量监控系统的落地还需要重点考虑以下工程边界:
1. 容器环境下的 /proc 隔离陷阱:在 Docker 或 Kubernetes Pod 中运行探针容器时,默认的 /proc 反映的是容器本身的配额还是宿主机的整体状态?如果需要感知宿主机物理负载,必须在运行参数中显式挂载 --volume /proc:/host/proc:ro,并指示探针重定向采集根路径。
2. 瞬时网络脉冲与毛刺防抖:偶发的定时任务(如日志滚动备份或数据同步)会导致网络带宽或 CPU 出现 1-2 秒的 100% 尖刺。如果在单次指标超标时立即触发短信或 Webhook 告警,会引发严重的告警风暴。合理的做法是采用滑动窗口中位数(Rolling Median)或“连续 N 个周期超标”的状态机判定。
3. 安全通信与双向证书:在跨公网纳管云主机时,切忌裸放 HTTP 端口。应当通过 TLS 双向认证、动态 Token 校验,或者将探针配置为仅反向向中央 Hub 建立 WSS (WebSocket Secure) 长连接,避免公网暴露攻击面。
选择监控架构绝非越复杂、功能越厚重越好。针对特定业务规模与物理资源约束,选用轻巧敏捷、内核穿透、零运行底噪的极简云监控引擎,往往能在运维可控性与系统稳定性之间取得最具性价比的工程平衡。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: