

发版别再断请求:Spring Boot 优雅停机与 Nginx/K8s 滚动摘流实战
说明:源微信页触发「环境异常/验证码」无法完整抓取正文。本文按题意「零停机更新代码 / Spring Boot」结合官方 Graceful Shutdown、Actuator Readiness 与公开生产实践深度改写,重点给出可落地的配置清单与排坑表。
半夜两点发版,不是因为热爱加班,而是每次 kill 旧进程、再起新 Jar,中间那几十秒端口空窗会让 502 与超时告警刷屏。很多团队把「零停机」理解成「JVM 内热替换 Class」,结果在生产里既难又脆。更稳妥的路径其实很朴素:先管流量,再管进程——滚动摘流 + 优雅停机。
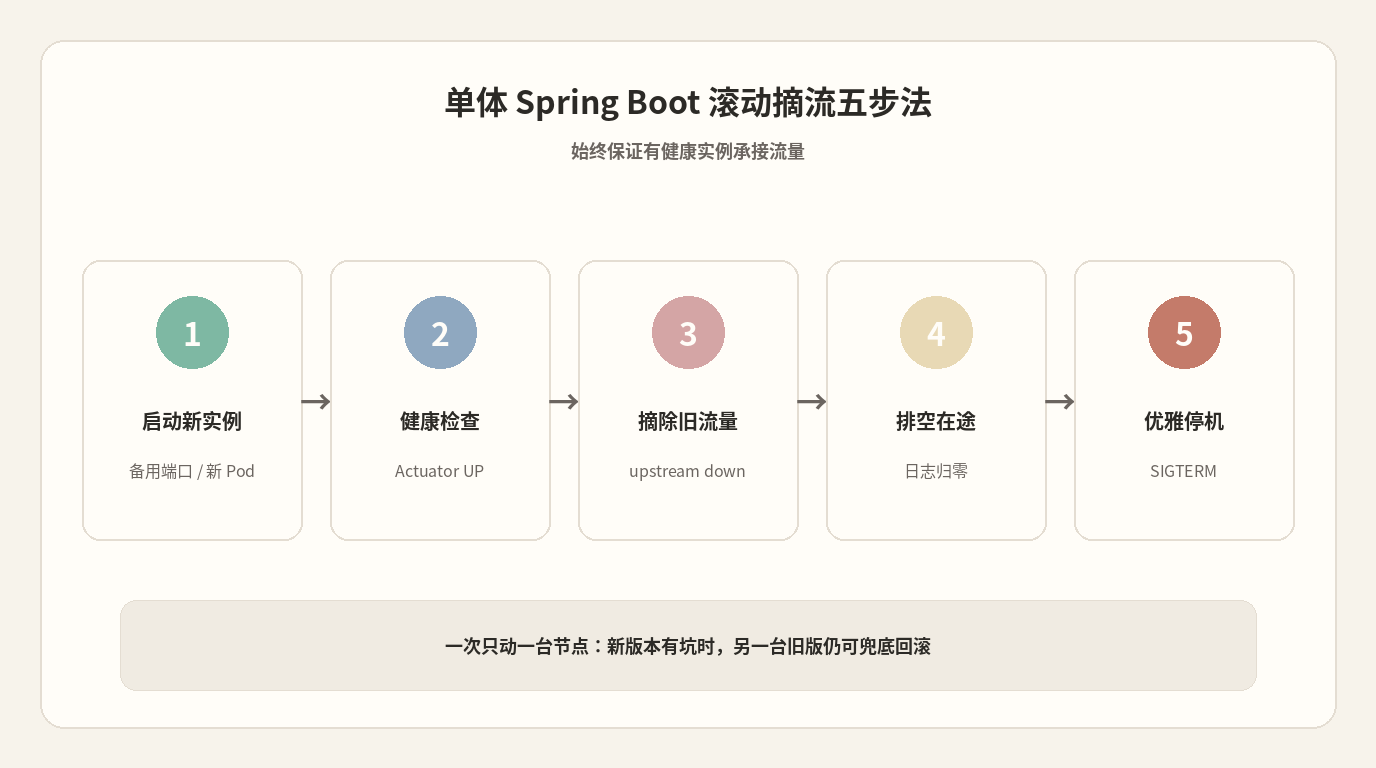
一、零停机的本质:始终有健康实例在接流量
「停服更新」的典型动作是:覆盖 Jar → kill -9 → 等端口释放 → java -jar。问题不止是启动慢:
1. 端口空窗:旧进程已死、新进程未就绪,网关/Nginx 仍把请求打过来 → 502 / 连接拒绝。
2. 在途请求被斩断:订单提交、支付回调、长事务在半路被掐,前端只能重试,客服群准时炸。
3. 只能躲流量:发版窗口被迫挪到凌晨,紧急热修却等不到「安全窗口」。
零停机不是让更新「不可见」,而是保证任意时刻至少有一个健康实例在承接流量。落到单体 Spring Boot,就是标准组合:
- 新版本先在备用端口/新 Pod 拉起并健康检查通过;
- 负载侧把旧节点摘流(Nginx
down/ K8s Endpoints 移除); - 旧实例耗尽在途请求后优雅退出;
- 再轮换下一台。
Spring Boot 侧能做的核心是两件事:优雅停机与就绪探针;流量切换则交给 Nginx、注册中心或 Kubernetes。
二、方案选型:滚动 / 蓝绿 / 灰度怎么选
| 方案 | 原理 | 优点 | 代价 | 适合场景 |
|---|---|---|---|---|
| 滚动发布 | 多实例逐个替换,始终有实例在线 | 成本低、易落地 | 发布期新旧版本短暂共存 | 绝大多数 Spring Boot 集群(首选) |
| 蓝绿发布 | 整套新环境就绪后一键切流 | 回滚极快 | 约双倍资源 | 核心链路、资源充足 |
| 灰度发布 | 按比例/标签导入新版本 | 风险可控 | 需要路由与观测能力 | 大版本、接口不兼容变更 |
三者并不互斥:灰度可以看作滚动的精细化;蓝绿也可叠加滚动。基础设施尚薄的团队,建议先打通 Nginx 轮询 + Spring Boot 优雅停机 + 健康检查,再谈全自动流水线。

三、Spring Boot 优雅停机:两行配置与真实时序
从 Spring Boot 2.3 起,内嵌容器支持优雅停机:
server:
  shutdown: graceful

spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
含义很直接:
1. 收到 SIGTERM 后,停止接收新连接;
2. 让已接受的 HTTP 请求继续跑完;
3. 每个停机阶段最多等待 timeout-per-shutdown-phase,超时强制收尾,避免慢请求拖死进程。
超时不要拍脑袋:按线上 P99 / 最慢接口 留余量。若最慢接口约 25s,30s 往往刚好;有重批处理可酌情加大,但必须与 K8s terminationGracePeriodSeconds 对齐(见下文)。
版本差异
- 2.2 及更早:没有
server.shutdown,自写ContextClosedEvent监听器很难真正「等请求完再断」。优先升级到 2.3+。 - 3.x:配置方式与 2.3–2.7 一致;若「配了不生效」,优先查配置层级写错、或容器把信号吞掉,而不是怀疑「版本太新」。
容器镜像:exec 形式 ENTRYPOINT
# 推荐:Java 为 PID 1,能直接收到 SIGTERM
ENTRYPOINT ["java", "-jar", "/app.jar"]

# 不推荐:shell 为 PID 1,信号传递链易断开
# ENTRYPOINT java -jar /app.jar
配合 Actuator 探针(K8s 强烈建议打开):
management:
  endpoint:
    health:
      probes:
        enabled: true
  health:
    readinessstate:
      enabled: true
    livenessstate:
      enabled: true
优雅停机开始时,Spring 会把 Readiness 置为 REFUSING_TRAFFIC,/actuator/health/readiness 返回不可用,便于负载侧停止灌新流量。
四、Nginx 双节点手工滚动:可照抄的操作清单
假设 A/B 两台机器,Nginx upstream 指向两台的 8080。发布前准备:已测通的新 Jar、SSH、库表兼容(无破坏性变更)、以及可观察的 QPS/错误率基线。
| 阶段 | 操作 | 验证点 |
|---|---|---|
| 启动新实例 | A 上临时端口如 8081 启动 app-v2.jar |
curl /actuator/health 为 UP |
| 摘除旧节点 | upstream 将 A:8080 标 down 后 nginx -s reload |
A 旧进程访问日志停止增长 |
| 接入新节点 | upstream 改为 A:8081 | 业务接口抽检正常 |
| 关闭旧进程 | kill(SIGTERM,禁止默认 kill -9) |
优雅停机日志出现,进程退出 |
| 轮换 B | 重复上述步骤 | 双节点均跑新版本 |
关键细节:
- 一次只动一台:新版本有隐藏 Bug 时,另一台旧版仍可兜底。
- keepalive 长连接:
down后已建立连接不会瞬间消失,日志短暂「还在涨」可能是连接池老化,可用ss/netstat看ESTABLISHED再决定何时kill。 - 健康检查别甩 Nginx 访问日志:主动探测交给监控或 K8s Probe;Nginx 专注转发。
五、Kubernetes:preStop、宽限期与 Readiness 必须成套
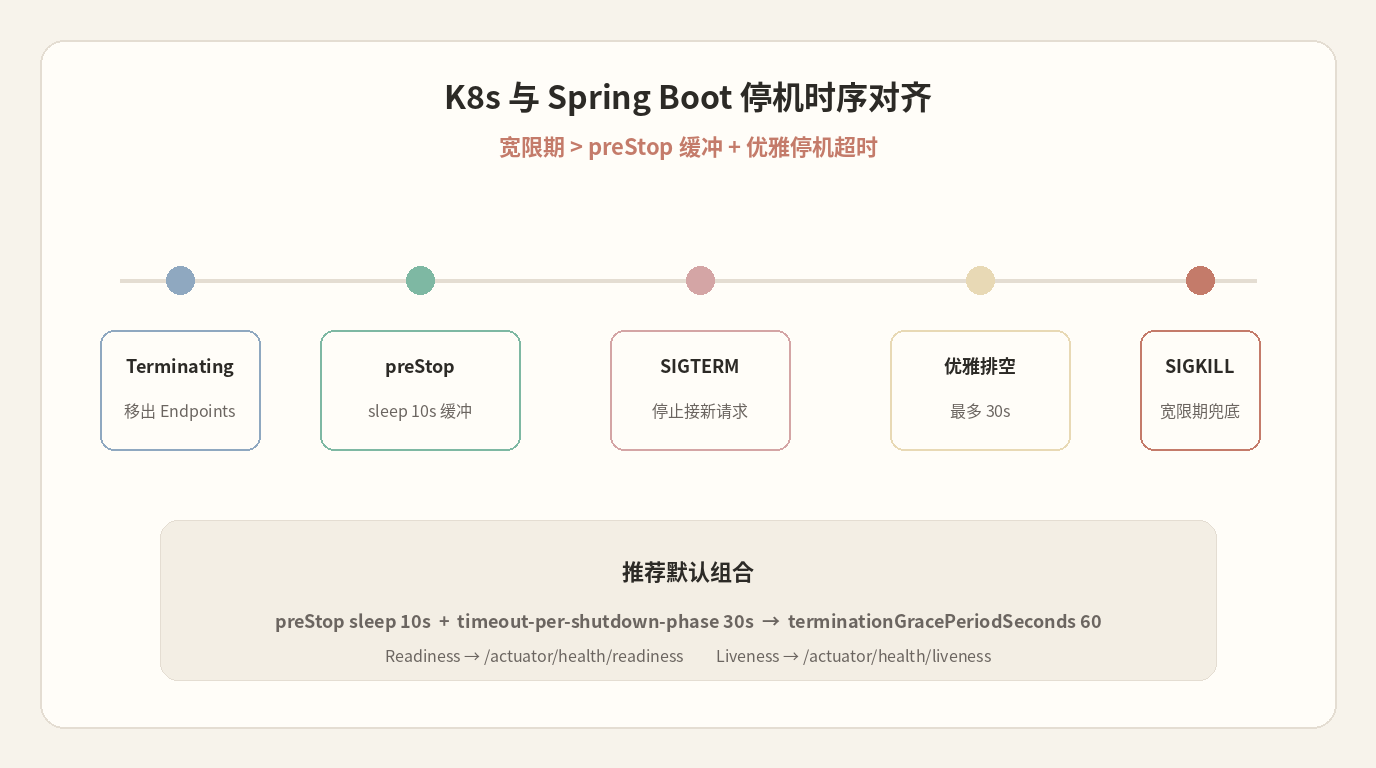
只配 server.shutdown=graceful 在 K8s 里远远不够。滚动删除 Pod 时的典型时序是:
1. Pod 进入 Terminating,从 Endpoints 移除;
2. 执行 preStop(若配置);
3. 向容器发 SIGTERM;
4. 超过 terminationGracePeriodSeconds 后 SIGKILL。
kube-proxy / 云 LB 同步有 lag。没有 preStop 缓冲时,SIGTERM 到达瞬间仍可能有新流量打进来;而优雅停机只能保护「进程内已接受的请求」,挡不住「同步延迟带来的新请求」。
推荐骨架:
spec:
  terminationGracePeriodSeconds: 60   # > preStop sleep + shutdown timeout
  containers:
    - name: app
      lifecycle:
        preStop:
          exec:
            command: ["sh", "-c", "sleep 10"]
      readinessProbe:
        httpGet:
          path: /actuator/health/readiness
          port: 8080
        initialDelaySeconds: 10
        periodSeconds: 5
      livenessProbe:
        httpGet:
          path: /actuator/health/liveness
          port: 8080
        initialDelaySeconds: 30
        periodSeconds: 10
对齐公式:
terminationGracePeriodSeconds > preStop 秒数 + timeout-per-shutdown-phase
例如 sleep 10s + 优雅停机 30s → 宽限期至少 60s。宽限期过短,优雅停机会被 SIGKILL「腰斩」。
验证建议:滚动期间对业务接口(不要只打 /actuator/health)连续 curl,期望全程 200;若夹杂 502/503,优先加大 preStop 或复查宽限期与探针路径。
六、比「两行 YAML」更深一层:就绪、定时任务与消息
1. 业务就绪 ≠ 端口监听
Tomcat 已监听、Actuator 已 UP,不代表连接池预热、本地缓存、JPA 元数据都就绪。可在自定义 HealthIndicator 里用「初始化完成」开关,只有 ApplicationRunner 预热成功才返回 UP,避免「半成品实例」被灌流量。
2. 主动「报假」摘流
静态 Nginx upstream 不会因 health 变 DOWN 自动摘节点,仍需 down 或主动健康检查模块。注册中心 / K8s Readiness 场景下,停机前把自定义 ready 标志打 false,能加速摘流。
3. 定时任务与 MQ
优雅停机默认覆盖 Web 请求;@Scheduled 与消息消费者要另做边界:
- 定时任务:分布式锁,或
SmartLifecycle在 Web 排空后再停调度,避免双实例重叠跑批; - Kafka / Rabbit:停拉取、排空当前批次、消费端幂等;Kafka 可配
spring.kafka.listener.shutdown-timeout,且小于整体timeout-per-shutdown-phase。
七、排坑速查表
| 现象 | 可能原因 | 处理 |
|---|---|---|
| 配了 graceful 仍秒退 | 版本 <2.3 / 配置写在错误节点 / 信号未达 Java | 升级;确认 server.shutdown;ENTRYPOINT 用 exec 数组 |
| 进程被强制杀 | terminationGracePeriodSeconds 过短 |
与 preStop + 停机超时对齐调大 |
| 摘流后仍有流量 | keepalive / 上游重试 | 等连接老化;缩短下游超时与重试 |
| 新实例一切流就超时 | health 过早 UP、资源未预热 | 业务就绪探针 + 延迟注册 |
| 发版期定时任务翻倍 | 多实例同时调度 | 分布式锁或停机顺序控制 |
| 消息重复消费 | 消费者未停、未 ack | 停拉取 + 幂等 |
八、落地建议:先半自动,再全自动
第一版就追求「改 Nginx、切流量、杀进程」全自动,很容易在健康检查未通过时把流量切上去。更稳的节奏是:
1. 脚本只做重复劳动(传包、起临时端口、打健康检查);
2. 切流与杀旧进程保留人工确认(看 QPS、错误率、实时日志);
3. 跑顺几十次后再把切换动作交给流水线。
发布前固定检查清单:QPS/错误率基线 → 逐节点「临时端口启动 → 验证 → 摘流 → 日志归零 → SIGTERM」→ 保留上一版回滚包 → 清理临时端口与旧 Jar。
零停机不是一个开关,而是一套配合良好的工程习惯:Spring Boot 负责把在途请求做完,Nginx/K8s 负责让流量别再打过来,观测负责告诉你「现在可以动手」。把这三块对齐,发版窗口才能真正从「赌流量低谷」变成「工作时间可重复的常规操作」。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





