

对象图怎么查怎么存?Jimmer 把 GraphQL 式控制带回 Java ORM
国内 Java 持久层几乎被 MyBatis / MyBatis-Plus 与 Spring Data JPA 两极占满:一边是 XML/注解 SQL 的灵活与样板,一边是实体级联与懒加载的便利与陷阱。开源项目 Jimmer(babyfish-ct/jimmer)换了一条路——实体不是 POJO,而是动态 + 不可变的万能数据对象,专为「任意形状对象树」的整体读写设计。本文按工程选型视角拆清它和 JPA、MyBatis 差在哪、怎么接、以及 APT/KSP 与 DTO 语言要注意什么。
微信源文把 Jimmer 推销成「最先进的 ORM」;官方英文 README 也用 The most advanced ORM of JVM 自居。营销口号可以打折听,但底下几件事确实值得认真对标:Fetcher 细粒度控图、Save Command 残缺对象整图保存、编译期 DTO、无 N+1 的批量关联查询、以及可选的微服务远程关联。下面不复读口号,只谈落地。
一、为什么「二选一」总觉得别扭:POJO 把表达力锁死了
多数团队的选型对话会停在这两句:
- 「复杂报表/动态条件多 → 上 MyBatis」
- 「CRUD 多、领域模型清晰 → 上 JPA」
真实项目里却常常两边都痛:JPA 把 insertable/updatable/cascade/fetch 写死在映射层后,业务接口一旦要换「形状」(只要书名+作者列表,不要出版社;或只要更新价格,不要整行覆盖),不是加新 EntityGraph,就是退化成手写 DTO + 手工拼装。MyBatis 则把「形状」完全交给 SQL 与 ResultMap,灵活是真灵活,但关联树一深就出现 N+1、分页 count 难写、XML 与接口漂移。
Jimmer 官方把根因指向 JVM 生态的默认假设:把 POJO/结构体当数据模型核心。POJO 每个属性要么有值要么是 null,很难干净表达「这个属性本次业务根本没加载/没提交」;关联形状又很难随接口变化。于是三种常见路线(静态 ORM、动态语言 ActiveRecord、SQL Mapper)都无法同时兼顾便捷、灵活与类型安全。
| 路线 | 代表 | 强项 | 常见代价 |
|---|---|---|---|
| 静态 ORM | JPA / Hibernate | 对象导航、事务集成 | 级联与懒加载心智负担,DTO 易退化成无关联 OM |
| SQL Mapper | MyBatis | SQL 可控、易调优 | 样板多、对象树组装靠人工 |
| 动态 ORM | ActiveRecord 类方案 | 灵活 | 静态语言里难原样移植,类型安全弱 |
| 任意形状 ORM | Jimmer | 读写任意图、编译期 DTO | 学习曲线、依赖 APT/KSP |
选型提醒:Jimmer 不是 JPA 实现。它复用部分注解语义,但没有脏检查那套会话魔法;事务通常交给 Spring(或自行管 JDBC 连接)。别用「会不会 Hibernate」的经验直接硬套。
二、核心理念:把「任意形状的数据结构」当成一等公民
Jimmer 的口号可以浓缩成一句:读的时候由框架按你指定的形状造树给你;写的时候你造一棵残缺树交给框架保存。 实体接口由 APT(Java)或 KSP(Kotlin)生成实现,具备两个关键特征:
1. 动态性:属性可以「缺失」(unknown)——这和「值为 null」是两回事。缺失属性在 Jackson 序列化时会被忽略;业务代码若强行访问缺失属性会抛异常(类似懒加载未初始化,但是显式、可预期)。
2. 不可变性:对象树无循环引用,可直接序列化成普通 JSON,前后端/多语言客户端都好消化。深拷贝修改走类似 JS immer 的 draft 作用域,这也是项目名 Jimmer 的由来。
官方对照表(精简)能帮你快速建立心智模型:
| 对比对象 | Jimmer 差异点 |
|---|---|
| GraphQL | 无需 HTTP 服务即可在进程内「按形状取数」;且支持写入任意形状,不只是查询 |
| JPA | 保存形状不必事先用 cascade/insertable 固化;可直接保存残缺对象;DTO 可带嵌套关联 |
| MongoDB 文档 | 不必事先约定文档孤岛形状;每次业务可临时规划读写视图 |
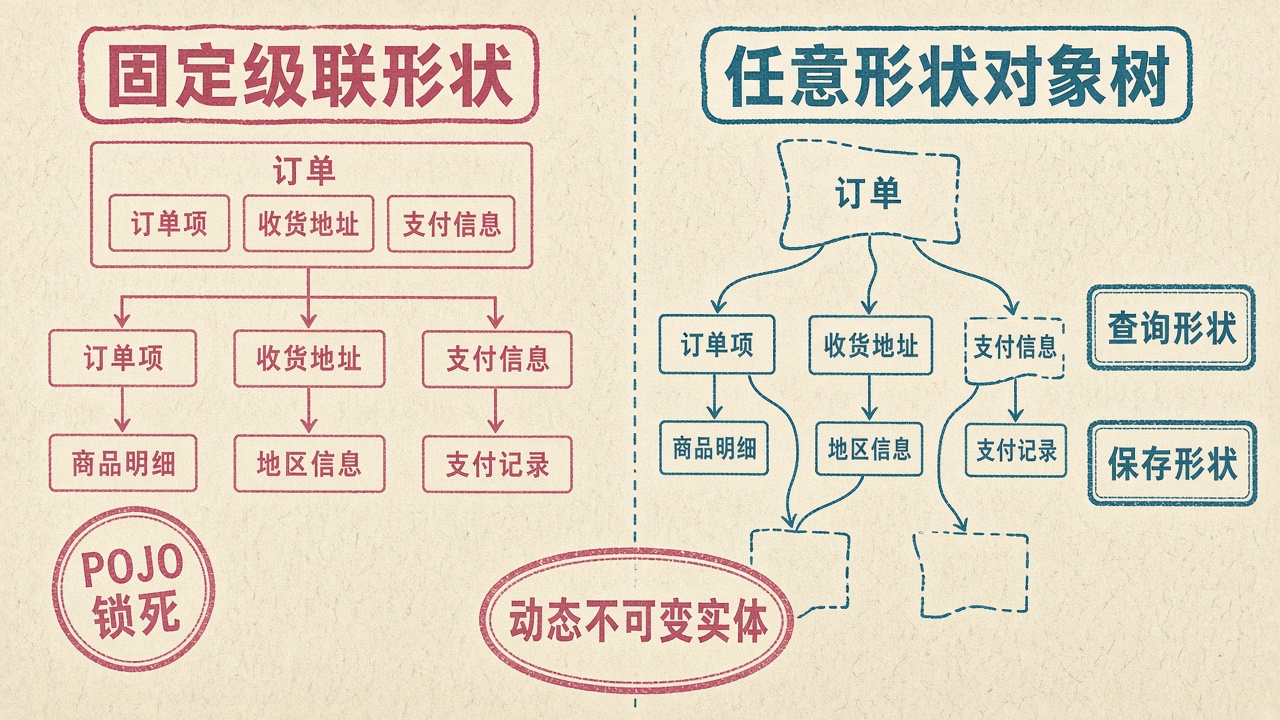
对业务方来说,这意味着:实体模型保持稳定(高价值),接口 DTO 用廉价方式生成(低价值),抗需求变更的能力主要来自「形状可临时规划」,而不是再堆一套映射胶水。
三、实体怎么写:接口 + 注解,长得像 JPA,骨子里不是 POJO
官方示例(书籍领域)里,实体是 interface 而不是 class:
@Entity
@KeyUniqueConstraint
public interface Book {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    long id();

    @Key
    String name();

    @Key
    int edition();

    BigDecimal price();

    @Nullable
    @ManyToOne
    @OnDissociate(DissociateAction.SET_NULL)
    BookStore store();

    @ManyToMany(orderedProps = {
            @OrderedProp("firstName"),
            @OrderedProp("lastName")
    })
    @JoinTable(
            name = "BOOK_AUTHOR_MAPPING",
            joinColumnName = "BOOK_ID",
            inverseJoinColumnName = "AUTHOR_ID"
    )
    List<Author> authors();
}
几个落地细节:
@Key可组合业务唯一约束(如name + edition),和代理主键id分开建模。- 关联注解看起来像 JPA,但不要指望配置一堆
cascade=ALL就定死保存行为——保存形状主要由调用点的数据结构决定。 @OnDissociate等语义用于解关联策略,比「全靠数据库外键碰运气」清晰。
编译注意:第一次打开工程若 APT/KSP 未跑,IDE 会报「找不到生成类」。按官方建议:命令行先
mvn install/gradle build,或直接 Run 主类触发注解处理;只改.dto文件时可能需要 Rebuild 或配套 DTO 插件。
四、查询侧:Fetcher 像 GraphQL,但没有 N+1
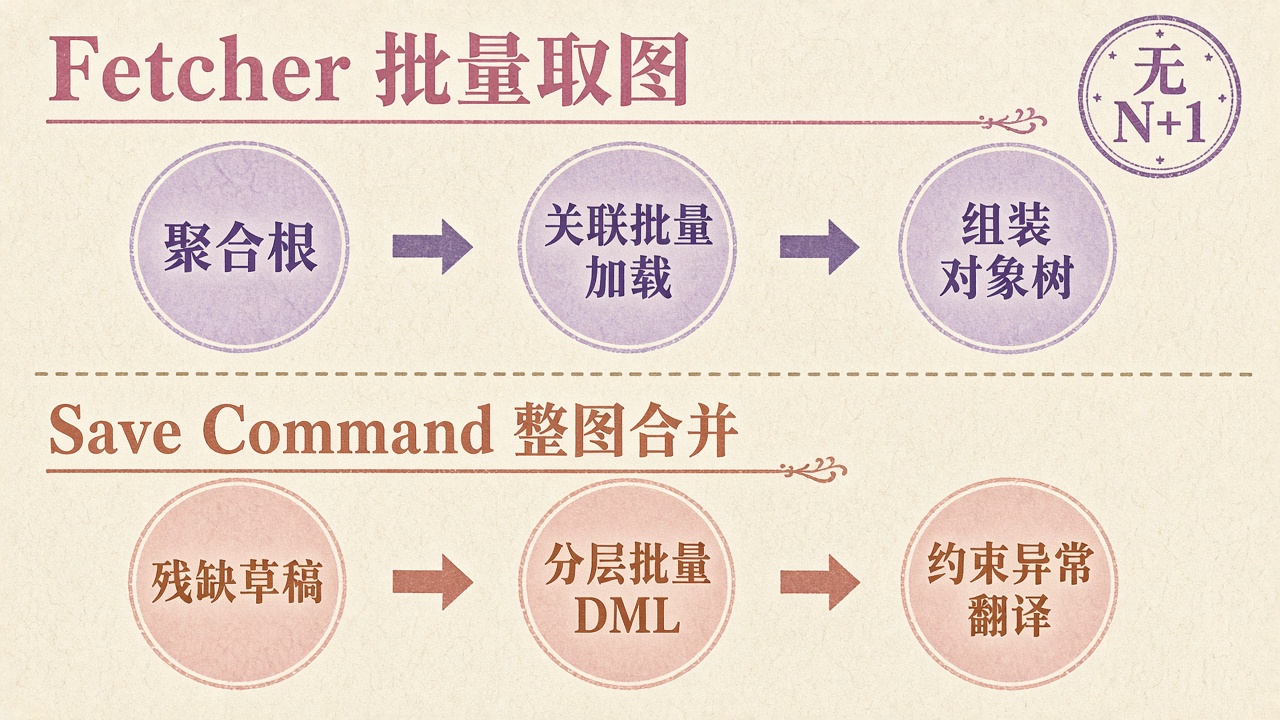
Fetcher 是 Jimmer 三大基础能力之一(另两个是 Save Command 与 SQL DSL)。你可以在调用点声明「这本书要不要带 store、authors 要不要只取姓名」——深度、广度由业务决定,框架用广度优先 + 批量 SQL 组装,避免经典 N+1。
典型用法心智(示意):
// 只取标量:残缺对象,信息量甚至小于「孤单完整实体」
Book book = sqlClient.findById(
    BookFetcher.$.allScalarFields(),
    id
);

// 带关联:像 GraphQL 字段选择
List<Book> books = sqlClient
    .createQuery(BookTable.$)
    .where(table.name().ilike(name))
    .select(
        table.fetch(
            BookFetcher.$
                .allScalarFields()
                .store(BookStoreFetcher.$.name())
                .authors(AuthorFetcher.$.firstName().lastName())
        )
    )
    .execute();
自关联场景还能递归查询(官方强调:这是当前 GraphQL 规格里并不直接提供的能力)。分页时,框架可基于数据查询自动生成并优化 count 查询;动态多表 join 会做无用连接消除、逻辑等价 join/子查询合并等优化——这和「单表 QueryWrapper 拼 where」不是一个量级。
若服务端自己要消费查询结果并追求 100% 静态安全,推荐走 DTO 语言:在 src/main/dto 写极简 .dto 文件,编译期生成带嵌套关联的 Output/Input/Specification DTO。这正是 Jimmer 相对「手工 MapStruct + 扁平 DTO」的卖点——嵌套投影仍然是 ORM,而不是退化成 OM。
五、写入侧:Save Command 整图 merge,残缺也能存
JPA 更新常常演变成「先查出完整实体 → 改几个字段 → save 整行」;级联保存则依赖事先配置。Jimmer 允许你构造一棵任意残缺的对象树(或 Input DTO),交给 Save Command:
- 尽量使用数据库原生 upsert / 批量 DML;
- 每一层多个对象走 JDBC batch;
- 常见约束冲突会被翻译成更可读的业务异常,而不是扔一团 SQLState。
示意(伪代码,突出形状而非完整 API):
Book input = BookDraft.$.produce(draft -> {
    draft.setName("Learning GraphQL");
    draft.setEdition(1);
    draft.setPrice(new BigDecimal("49.90"));
    draft.applyStore(store -> store.setId(storeId)); // 只挂 id,不必加载整棵出版社
    draft.addIntoAuthors(author -> {
        author.setFirstName("Eve");
        author.setLastName("Procello");
    });
});

sqlClient.getEntities().save(input); // 形状由 draft 决定:可深可浅
这对「订单头 + 明细局部变更」「目录树局部搬迁」一类接口非常友好:调用点决定形状,映射层不必为每个接口再开一套 cascade 配置。
六、与 MyBatis / JPA 的对照清单(选型用)
把社区常见对比压成一张表,方便评审会贴幻灯片:
| 能力 | MyBatis / Plus | JPA / Hibernate | Jimmer |
|---|---|---|---|
| 实体形态 | POJO + Mapper | POJO Entity | 动态不可变接口实体 |
| 任意形状查询 | 手写 SQL/ResultMap | EntityGraph / 多 DTO | Fetcher / Output DTO |
| 任意形状保存 | 多条 SQL 手写 | cascade 预配置 | Save Command + 残缺树 |
| 动态多表查询 | XML <if> 为主 |
Criteria 难写 | 类型安全 DSL,面向多表 |
| N+1 | 易踩,靠自觉 | 懒加载易踩 | 设计上批量组装 |
| DTO 成本 | 手工为主 | 易扁平化 | 编译期 DTO 语言 |
| GraphQL | 另接框架 | 另接框架 | 可快速基于同一模型起服务 |
| 微服务关联 | 自行拼装 | 自行拼装 | 远程实体关联(示例工程可用) |
| 学习成本 | 低~中 | 中 | 中~高(APT/新心智) |
官方示例仓 jimmer-examples 里还有 GraphQL、Save Command、Cloud 远程关联等专项工程;书籍领域的 H2 示例可本地零环境跑通 OpenAPI。Spring Boot 接入核心依赖形如:
<dependency>
  <groupId>org.babyfish.jimmer</groupId>
  <artifactId>jimmer-spring-boot-starter</artifactId>
  <version>0.12.1</version><!-- 以 Maven Central / 官方示例为准 -->
</dependency>
Java 17+、Spring Boot 3.x 是当前示例主线;Kotlin 走 KSP。版本号请以 Maven Central 与 官方文档 为准滚动升级。
七、排坑指南:别把「先进」当成零成本迁移
1. 心智迁移成本真实存在
团队若深度依赖 MyBatis XML 调优文化,或 JPA 二级缓存/脏检查习惯,需要专门做 PoC:选一个「多级关联 + 局部更新」的接口,分别用三种方案实现,比拼代码量、SQL 条数与可维护性。
2. APT/KSP 是一等公民
CI 必须保证注解处理跑通;只改 DTO 文件时记得全量编译或装 DTO 插件,否则会出现「本地能跑、流水线缺生成类」。
3. 缺失属性 ≠ null
前端/网关若把「没传的字段」和「显式传 null」混为一谈,保存语义会错。约定好 JSON 省略字段 vs null 的业务含义。
4. 不是银弹
极致定制的报表 SQL、存储过程、数据库特有优化仍可能要混入原生 SQL 表达式——Jimmer DSL 支持混入,但复杂分析场景仍可能保留 MyBatis/jOOQ 旁路。
5. 许可证与社区
以 GitHub babyfish-ct/jimmer 仓库声明为准;中文社区活跃(文档中文站、B 站系列视频、QQ 群),英文材料有 Baeldung 入门文。上生产前核对当前版本的已知限制(官方文档对 1.0 路线图有未完成项说明,例如部分子查询作基表、实体继承多态等)。
八、什么时候值得认真评估 Jimmer
适合优先 PoC 的信号:
- 接口形状变化频繁,DTO 爆炸或 JPA 级联配置已失控;
- 需要「一次查出对象树」且讨厌 N+1,又不想单独维护一套 GraphQL 服务;
- 写入也是树状(主从表、图结构),希望调用点决定深度;
- 准备用同一套实体模型同时服务 REST(甚至 GraphQL)与强类型客户端契约(OpenAPI / TypeScript 生成)。
更稳妥继续用现栈的信号:
- 团队全员 MyBatis,且 90% 是单表 CRUD + 少量固定 SQL;
- 强依赖 JPA 生态周边(特定 Hibernate 扩展、已有巨型映射元数据);
- 短期内无法接受编译期代码生成与新实体模型培训。
参考与延伸
| 资源 | 说明 |
|---|---|
| GitHub: babyfish-ct/jimmer | 源码与 README(中英) |
| 官方中文文档 | 项目介绍、Fetcher、Save、DTO |
| jimmer-examples | simple / GraphQL / cloud 等可运行示例 |
| Baeldung: Jimmer ORM Intro | 英文入门 |
微信源文触发环境验证未能完整抓取正文,本文以官方文档、README、示例工程与公开技术评述为事实来源做深度改写与选型补充。若你正在做持久层换代评审,建议直接 clone jimmer-simple,用自己的 3~5 张核心表复刻一遍「Fetcher 查询 + Save 保存」,用真实 SQL 日志说话,比任何「最先进」标题都管用。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





