

拒绝死记硬背架构八股:拆解开源系统设计笔记与高频核心场景选型权衡
在各大技术面试与架构研讨中,系统设计(System Design)往往是检验工程师工程底蕴与全局视野的分水岭。然而在实际交流中,我们经常能看到这样的场景:
很多同学能够脱口而出各种高大上的名词——“一致性哈希”、“双写一致性”、“分库分表”、“CAP 定理”,但当面试官抛出一个真实的业务演进场景(例如:“如果系统在凌晨遭遇跨机房 NTP 漂移,你的雪花算法发号器会发生什么?”),或者追问一句“为什么这里选令牌桶而不是漏桶”时,回答往往漏洞百出。
造成这种现象的根源在于:很多人把系统设计当成了死记硬背的“架构八股”,却忽略了系统设计本质上是一门“权衡与取舍(Trade-offs)”的艺术。
最近,GitHub 上一个名为 liquidslr/system-design-notes 的开源笔记仓库持续走红。该项目将经典著作《System Design Interview》两卷本中 28 个核心工业场景的精髓抽丝剥茧,整理成了一套可落地、重权衡的工程决策脉络。本文将结合这套精简体系,带你拆解系统设计的破局框架与高频核心组件的技术权衡。
一、为什么死记硬背在系统设计中注定会崩?
系统设计没有唯一的“标准答案”。在真实的生产环境和高级技术面试中,面试官考察的从来不是你能不能默写出一个完整的架构框图,而是你的工程推演逻辑与约束管理能力。
1. 约束决定架构,而非技术决定架构
一个日活 10 万的内部管理系统,与一个日活 5 亿的短视频推荐 Feed 流系统,其架构设计是完全两个物种。脱离了吞吐量(QPS/TPS)、读写比、数据保留期与SLA 延迟指标,空谈“必须上 Kafka”或“必须引入分库分表”毫无意义。
2. 每个技术选型都背负着“代价”
工程世界里没有免费的午餐: - 引入 Redis 缓存提升了读取吞吐,代价是带来了缓存击穿、雪崩与双写一致性的复杂度; - 引入数据库 Sharding 突破了单机容量瓶颈,代价是牺牲了跨分区 JOIN、分布式事务与二次扩容迁移的高昂成本; - 引入异步消息队列实现了削峰填谷,代价是系统从强一致性倒退为最终一致性,并必须处理消息重复与乱序问题。
架构设计的本质,是在特定的业务阶段、有限的资源与严苛的物理限制之间,找到一个当下最合理的 Trade-off。
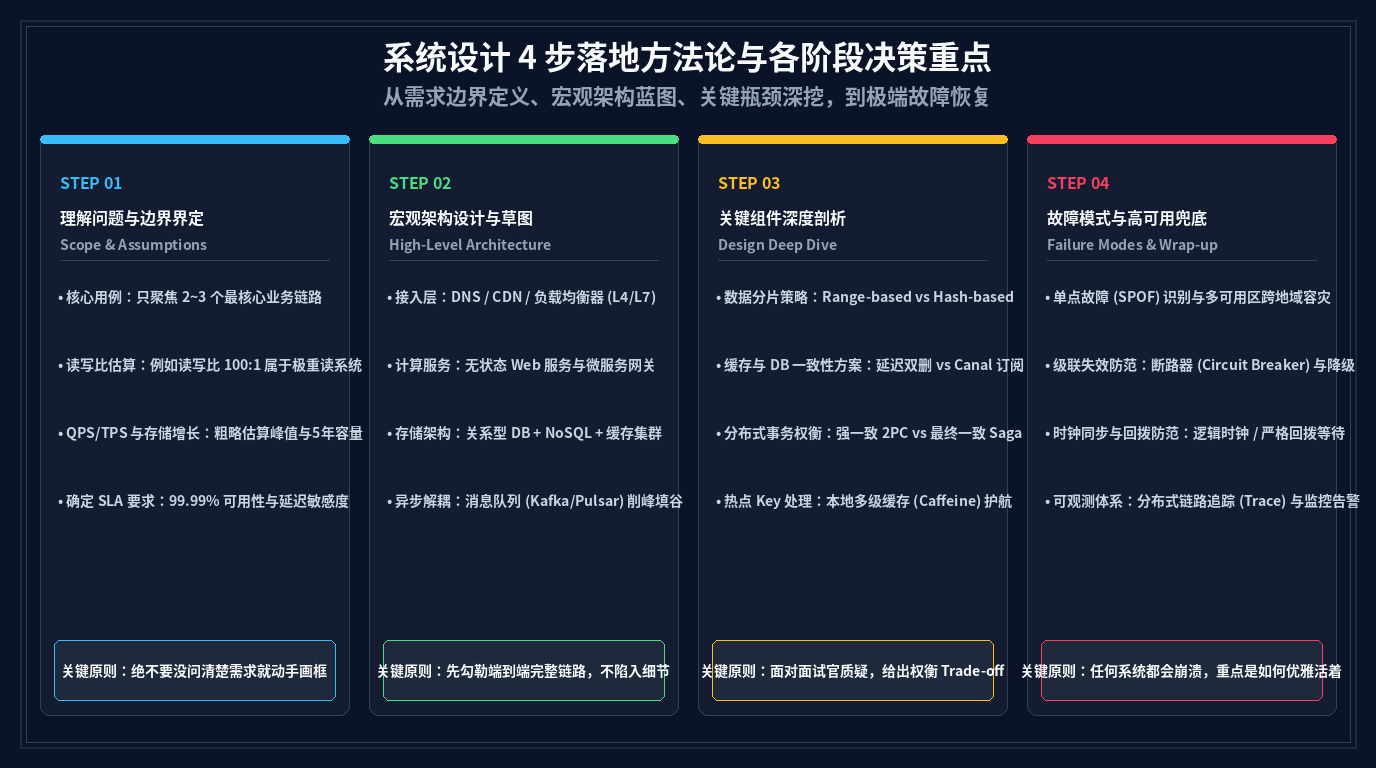
二、系统设计破局的“四步推演法”
无论面对设计短链系统(URL Shortener)、分布式爬虫、实时排行榜,还是设计秒杀支付链路,切忌一上来就画复杂的微服务架构图。开源笔记提炼出了一套经过工业界检验的四步闭环推演法:
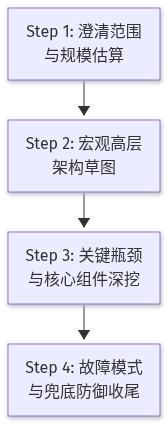
Step 1:澄清业务范围与容量估算(Scope & Estimation)
- 核心用例:明确系统的 2~3 个核心功能(P0 链路),非核心诉求(如用户积分、通知)显式排除;
- 读写比估算:读密集型(如推特/微博读写比 100:1)与写密集型(如物联网遥测、日志写入)的选型截然不同;
- 数据量估算:每日新增数据量、5 年存储容量(PB 级还是 TB 级),决定了存储选型是单机 RDS、分库分表还是对象存储。
Step 2:勾勒宏观高层架构(High-Level Architecture)
画出清晰的端到端数据流向图:
客户端 -> CDN / DNS -> 负载均衡网关 (L4/L7) -> 无状态 Web 服务 -> 缓存/持久化数据库。
在宏观阶段保持组件清晰,不陷入具体的算法细节。
Step 3:关键瓶颈深挖与选型权衡(Design Deep Dive)
这一阶段针对系统最大的性能瓶颈或业务难点做穿刺。例如: - 在实时聊天系统中,深挖长连接网关与消息路由表的设计; - 在全局唯一 ID 生成器中,深挖时钟回拨处理与高吞吐保证; - 在高并发商品详情页中,深挖热点 Key 的本地缓存击穿防线。
Step 4:故障模式分析与防御(Failure Modes & Wrap-up)
没有任何分布式系统可以永远不宕机。主动交代系统的薄弱环节与容灾方案: - 单点故障(SPOF)的消除; - 网络分区(Network Partition)下的降级行为; - 缓存雪崩与下游限流排队机制。
三、四大高频核心组件的技术权衡矩阵
结合 system-design-notes 中的典型章节,我们对最容易被死记硬背的四大核心原语进行横向解剖。
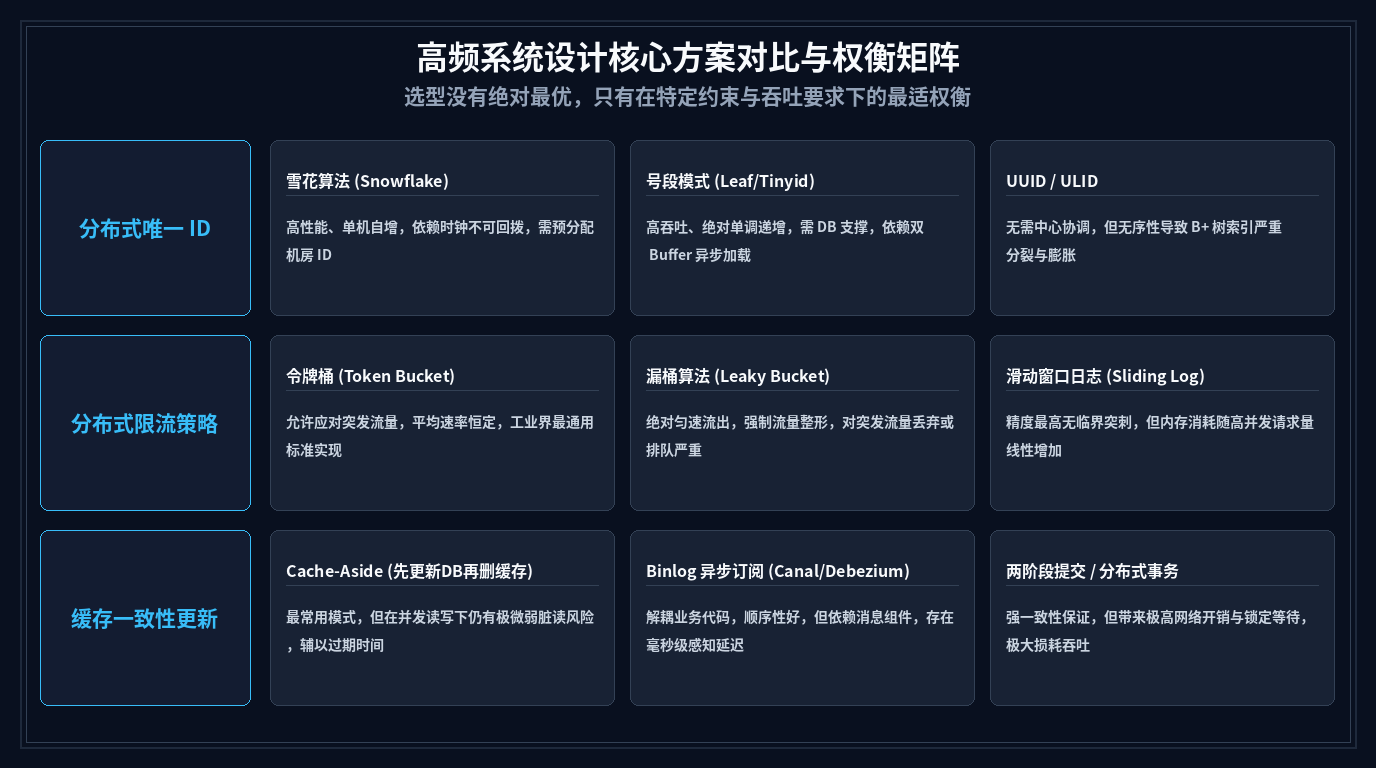
1. 分布式唯一 ID:雪花算法 vs 号段模式
| 方案 | 核心优势 | 潜在缺陷 | 适用业务场景 |
|---|---|---|---|
| Snowflake(雪花算法) | 本地内存自增生成,高性能(单机百万 QPS),无中心数据库依赖 | 高度依赖机器本地时钟,一旦遭遇 NTP 时钟回拨极易引发 ID 重复或系统拒签 | 纯分布式、超高并发写入,时钟同步受控的私有集群环境 |
| 号段模式(Leaf/Tinyid) | 依赖 DB 批量分配号段,严格单调递增,天然免疫时钟回拨 | 强依赖关系型数据库,需实现双 Buffer 异步拉取避免换号段阻塞 | 金融订单、账单流水、严格要求递增防业务倾斜的场景 |
| UUID / ULID | 无需任何中心协调,开箱即用 | 空间占用大(128位),且完全无序导致 MySQL B+ 树频繁页分裂与索引膨胀 | 离线任务、临时跟踪 TraceId,对索引顺序性要求低的场景 |
2. 分布式限流策略:令牌桶 vs 漏桶 vs 滑动窗口
在面对突发秒杀流量或防止恶意爬虫时,限流是系统的第一道护城河: - 令牌桶算法(Token Bucket):以恒定速率向桶内发放令牌,桶满则溢出。允许应对瞬时的突发脉冲(只要桶里有令牌即可瞬时消耗)。这是 Nginx、Guava 及云原生网关最普遍的默认实现。 - 漏桶算法(Leaky Bucket):水无论如何注入,都以恒定速率漏出。主要用于流量整形(Traffic Shaping),强制抹平所有毛刺,适合保护后方脆弱且处理能力固定的遗留系统。 - 滑动窗口日志(Sliding Window Log):记录每次请求的时间戳,动态统计窗口内总数。精度最高,完全消除了固定时间窗口(如每分钟整点)的“双倍流量尖刺”,但代价是在高流量下内存消耗极大。
3. 数据分片(Sharding Key)的选型陷阱
当数据规模超过千万乃至数亿行,分库分表是必经之路,但 Sharding Key 的选取直接决定了架构成败:
- 按 User ID 哈希分片:用户维度的所有读写被精准分流到单一分区,事务与聚合非常容易;但一旦遇到“大 V 账号”(超高粉丝与互动),极易产生严重的数据倾斜和热点分片。
- 按时间范围(Range-based)分片:方便按时间做冷热数据迁移(归档 1 年前的历史数据);但致命缺点是所有的写入流量全都会打在当前最新时间分片上,失去横向水平分担写入负载的能力。
- 工业界推荐模式:复合分片键(如 Entity_Type + Hash(ID))或引入分布式原生数据库(如 TiDB / OceanBase),由底层存储引擎自动处理基于 Region 的热点裂变与负载均衡。
四、动手实战:编写工业级防回拨雪花发号器与高精度滑动窗口
为了让理论落地,我们在 practice/snowflake_limiter.py 中实现了两个标准的工业级核心原语,包含了对时钟漂移的平滑处理与滑动窗口限流:
import time
import threading
from collections import deque

class RobustSnowflake:
    """
    64 位雪花算法:
    - 41 bit 毫秒时间戳 + 10 bit WorkerID + 12 bit 序列号
    - 工业级容错:微小时钟漂移自旋平滑等待,严重回拨显式熔断拒绝
    """
    EPOCH = 1704067200000  # 2024-01-01 00:00:00 UTC
    WORKER_ID_BITS = 10
    SEQUENCE_BITS = 12
    MAX_SEQUENCE = (1 << SEQUENCE_BITS) - 1
    MAX_BACKWARD_MS = 10  # 容忍的最大回拨时延

    def __init__(self, worker_id: int):
        self.worker_id = worker_id
        self.sequence = 0
        self.last_timestamp = -1
        self.lock = threading.Lock()

    def next_id(self) -> int:
        with self.lock:
            now = int(time.time() * 1000)
            if now < self.last_timestamp:
                offset = self.last_timestamp - now
                if offset <= self.MAX_BACKWARD_MS:
                    time.sleep(offset / 1000.0)
                    now = int(time.time() * 1000)
                else:
                    raise RuntimeError(f"NTP Clock backwards {offset}ms! Aborting.")

            if now == self.last_timestamp:
                self.sequence = (self.sequence + 1) & self.MAX_SEQUENCE
                if self.sequence == 0:
                    while now <= self.last_timestamp:
                        time.sleep(0.0001)
                        now = int(time.time() * 1000)
            else:
                self.sequence = 0

            self.last_timestamp = now
            return ((now - self.EPOCH) << 22) | (self.worker_id << 12) | self.sequence
在本地单核单线程测试下,该轻量发生器能够达到每秒超过 137 万次 的无冲突 ID 产生速率;配合 SlidingWindowLimiter,可以精确拦截毫秒窗口内的越界流量。
五、写在最后:从“八股背诵者”到“架构决策者”
阅读系统设计资料,最危险的做法是将其当成“百科全书”去死记每一种方案的细节。正如 liquidslr/system-design-notes 项目带给我们的启发:
真正优秀的架构师,在脑海中建立的不是静态的概念清单,而是一棵动态的决策树。面对不确定性,首先澄清边界,接着梳理主干,随后在瓶颈点权衡取舍,并在最关键的脆弱路径构筑高可用防御。
下次面对面试官或项目评审时,不妨先深吸一口气,抛开套路,从业务的真实约束与 Trade-off 开始说起。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





