关掉终端记忆就丢?Letta 用分层记忆把 Agent 做成可自改常驻服务
源微信页触发了验证码拦截,正文以 letta-ai/letta(Apache-2.0,约 2.5 万 Star,前身 MemGPT)、letta-ai/letta-code(当前主开发仓)、Letta 官方文档 与 Docker 部署说明为准,不沿用源标题的星标口号,也不臆造未公开能力。
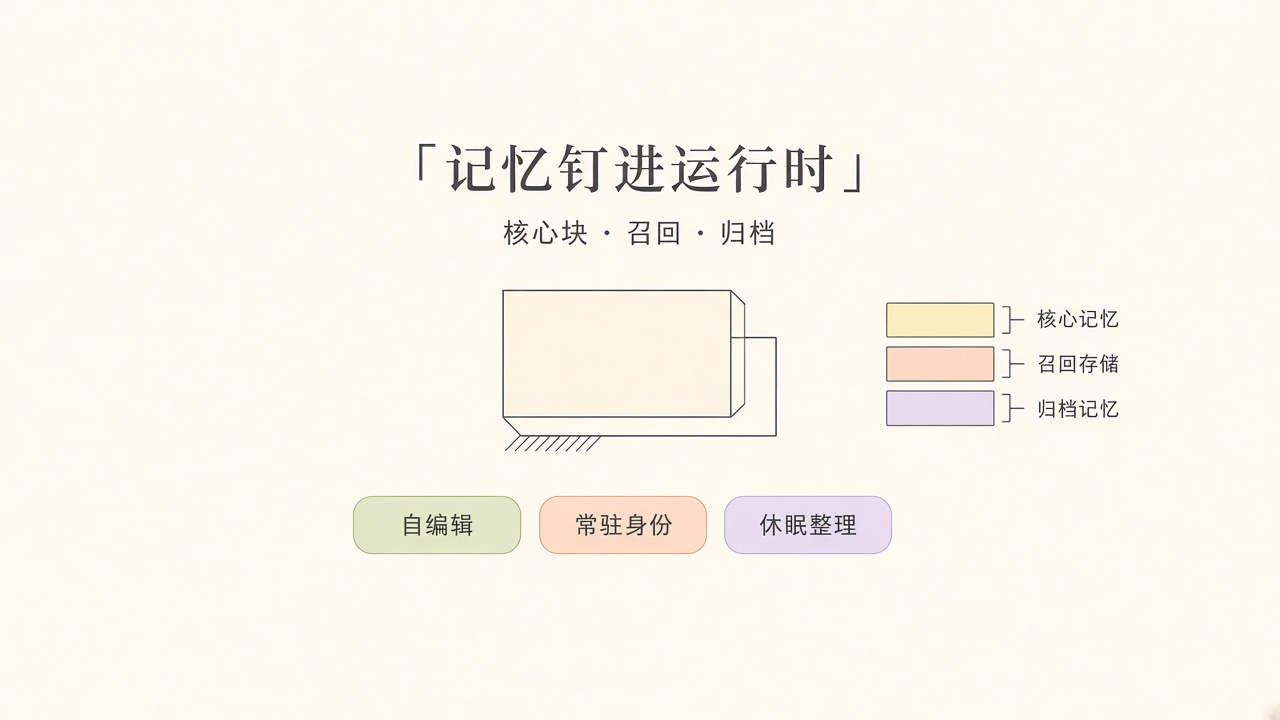
多数 Agent 框架把「一次对话」当一次函数调用:消息数组塞进 Prompt,进程一停,身份就没了。Letta 反过来:Agent 才是持久对象,会话、模型、机器都可以换,核心记忆块、召回历史和归档向量仍钉在数据库里。模型通过工具自己改记忆,而不是等你下次手工把摘要贴回系统提示。
一、无状态循环解决不了「隔夜失忆」
用原生 SDK 写一个 Agent 循环,本质是:拼 messages → 调模型 → 解析 tool_calls → 把结果塞回去。这套循环在单次任务里足够用。痛点出在第二天、下一个进程、另一台机器:你要么把整段历史再次塞进上下文,要么自己维护一份摘要。前者很快撞窗口,后者变成另一套半残的 RAG。
CrewAI、AutoGen 擅长的是编排:谁当研究员、谁当写手、消息怎么转。LangGraph 擅长的是图状态:节点怎么跳、checkpoint 怎么存。它们都可以「带一点记忆」,但记忆通常是你在图外面自己读写的。忘了写,就等于没记住。Letta 的立场相反:记忆是运行时的一等公民,Agent 默认住在服务里,状态默认落库。官方把它说成 stateful agent:学到的行为、环境事实、过往交互都要能跨会话保持。
Letta agents learn from experience and improve with use. The Letta agent harness is fully open source and builds on our lab’s latest research in AI memory and continual learning.
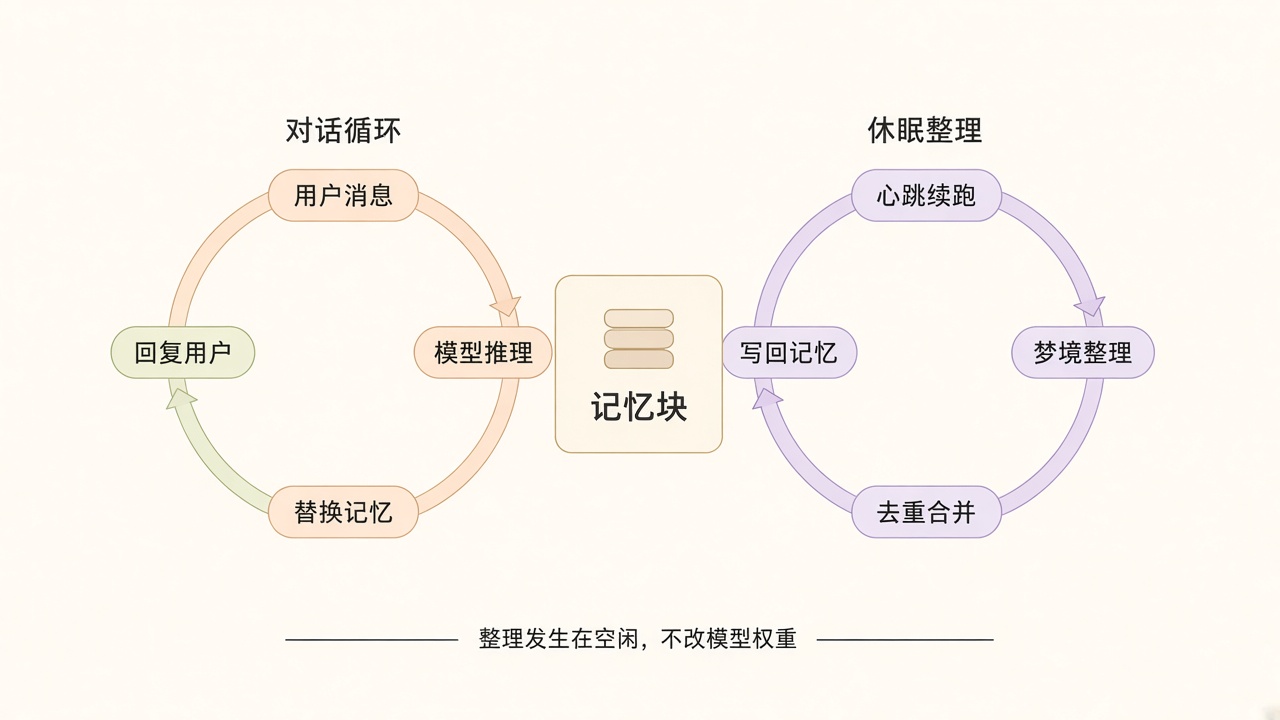
这句「越用越好」容易被听成模型参数被微调了。工程上不是。底层 LLM 没变,变的是上下文装配:核心记忆块每轮都钉在系统提示里;过期消息被驱逐后仍可按工具检索;归档条目走向量检索。所谓自改进,是 Agent 用 memory_replace / archival_memory_insert 改自己的工作记忆,外加空闲时的 sleep-time(文档现称 dreaming)做整理,而不是再训一遍权重。
源文标题爱用夸张星标。写到选型时请以仓库页面为准:letta-ai/letta 是遗留 API 服务仓,活跃开发已迁到 letta-code。把「口号星标」当技术指标,会把 Letta 和 LangChain、AutoGPT 这类十万星项目混成一类,后面对比表就没法看了。
二、LLM-OS:把上下文窗口当成 RAM,而不是全文档案馆
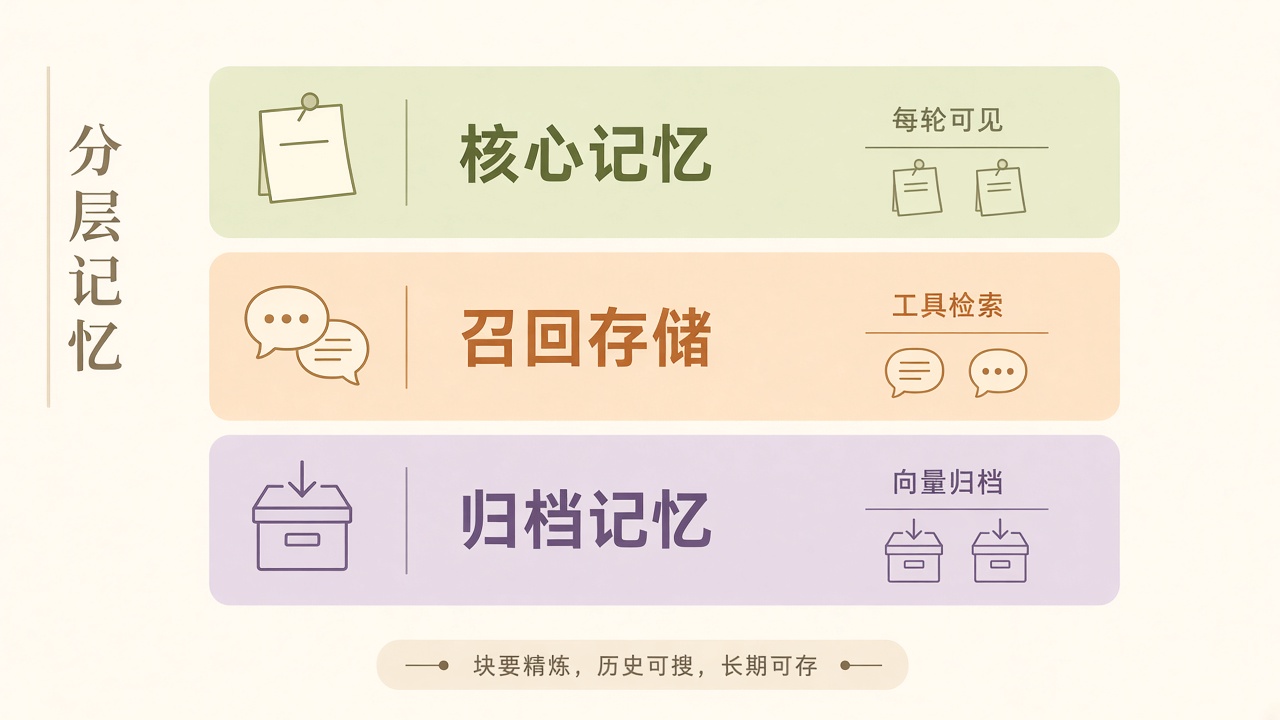
MemGPT 论文的核心类比是操作系统:上下文窗口是 RAM,消息历史是 SSD,长期知识是磁盘。模型像 CPU 一样发「系统调用」——不是被动等检索器把 chunk 糊到 Prompt 前面,而是自己决定哪条事实值得常驻、哪条可以归档、哪段旧对话值得搜回来。Letta 把这套类比做成了可部署的运行时。
三层分工可以写成一张对照表:
| 层级 | 类比 | 存什么 | 读写代价 | 容量 |
|---|---|---|---|---|
| 核心记忆(Memory Blocks) | RAM | persona、human、自定义块,每轮都进 Prompt |
几乎免费(已在上下文) | 严格受限,逼你精炼 |
| 召回存储(Recall) | SSD | 完整对话日志,可 conversation_search |
一次工具调用 | 远大于窗口 |
| 归档记忆(Archival) | 磁盘 | Agent 主动插入的长期条目,向量检索 | 查询 + 往返延迟最高 | 近似无限 |
核心记忆适合「每轮都要用」的事实:用户怎么被称呼、当前仓库用 pnpm 还是 npm、Agent 自己的说话方式。召回适合「刚才那次排障我们改过哪份配置」。归档适合「三个月前那次上线事故的结论」,不该每轮都占 Token。文件/知识库是第四条支路:中等体量文档用 open / grep / semantic_search;海量语料继续走外部 RAG 或 MCP,而不是硬塞进块。
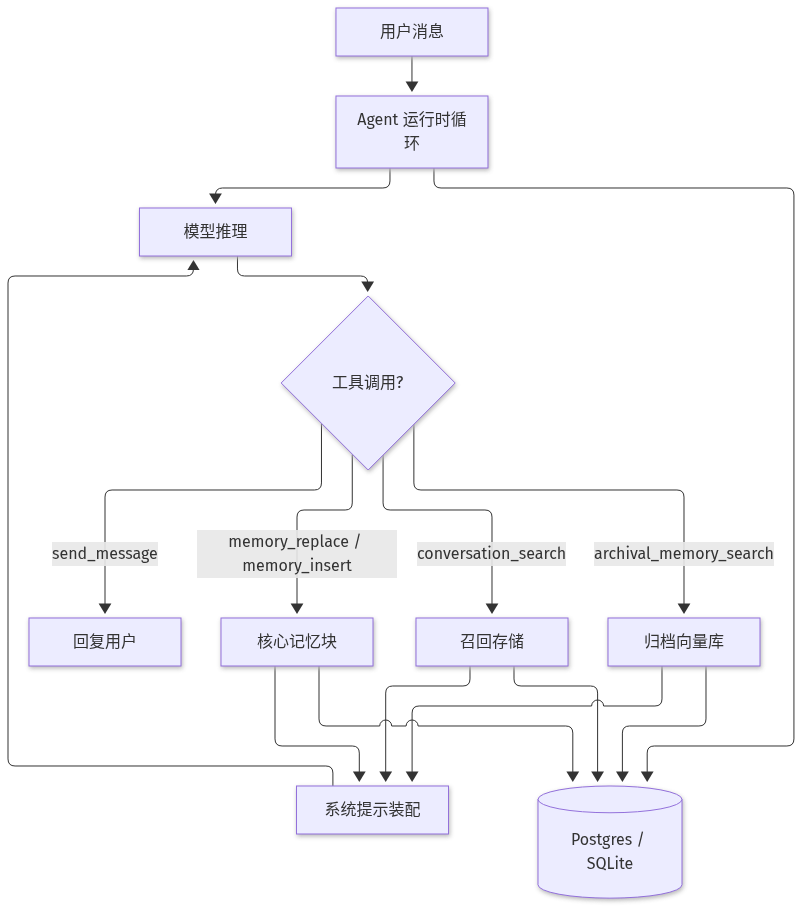
2026 年文档又加了一层 MemFS:记忆以 git 仓库的形式存在,Agent 可以检查、打补丁、提交。CLI 里 /init 给当前项目引导记忆,/doctor 审计重复与系统提示 Token,/sleeptime 配置后台整理。这和早期「只有两个块」的 MemGPT Demo 不是同一代产品,但三层延迟模型没变:热数据进块,温数据进召回,冷数据进归档。
三、记忆块是一等公民,模型用工具自己改
一块记忆不是「一段 Prompt 注释」,而是带标签、描述、容量上限的持久字符串。常规两块是 persona(Agent 是谁、说话边界)和 human(用户是谁、偏好与约束)。生产里几乎总会加自定义块:current_project 钉仓库和分支,findings 钉调研结论,多 Agent 场景还可以把同一块挂到多个 Agent 上,做成共享状态。
块的威力在于失败模式跟 RAG 相反:它每轮都可见,没有「检索没命中」这回事;代价是 Token。所以块必须有上限——官方经验是重要事实放块(通常远小于 50K 字符、块数量也不该膨胀到几十个),几页规范可以放文件,更碎的观察进归档(单条插入大约几百 Token 量级)。Agent 默认工具包括:
memory_insert/memory_replace/memory_rethink:改核心块conversation_search:搜旧对话archival_memory_insert/archival_memory_search:写/读长期库send_message:对用户发言- 可选:
web_search、run_code、跨 Agent 的send_message_to_agent_async
一次典型自编辑发生在对话中间。用户说「我叫 Alice,别再叫 Bob」,模型不是把这句话留在聊天记录里碰运气,而是调用 memory_replace 改 human 块。下次进程起来,系统提示里已经是 Alice。这才是「常驻身份」的最小闭环。
Sleep-time / dreaming 把整理从主对话里拆出去。主 Agent 负责回话和业务工具;后台 Agent 共享记忆,在步数阈值或上下文压缩时做去重、合并、改写。官方提醒:打开「Agent 先审再落盘」会多耗 Token,且不会再弹窗问你。把它理解成「夜间整理磁盘」,不要理解成「模型在你睡觉时偷偷微调」。
系统提示必须把记忆协议写死,否则会出现两种对称故障:一块空白——模型从不调用记忆工具;一块日记——每句观察都 append,把窗口挤爆。可用的最小协议是:只写稳定事实、事实变化就 replace 而不是追加矛盾句、塞不下的才进归档、回答历史问题前先 search。
四、三条安装路径:CLI、Docker 服务、Agent SDK
Letta 现在不是「一个 pip 包打天下」。按你要的形态选入口,混用最容易踩文档代差。
路径 A:个人/编码助手。 桌面应用覆盖 macOS / Windows / Linux;CLI 要求 Node.js 22.19+:
npm install -g @letta-ai/letta-code
letta
首次交互会自动创建 Tutor。/connect 接 API Key 或本地推理;进仓库后 /init 引导记忆;/remember always use pnpm in this repo 把约束写成耐久记忆;/model 换模型,/search 搜旧消息。letta -p "commit the changes and push" 是无头模式。官方强调 Letta Code 对开源权重很挑,先用 Claude Opus / GPT 一类前沿模型建立体感,再试 GLM、MiniMax。Mods 用 letta install npm:@letta-ai/plan-mode 往运行时加能力,装完 /reload。
路径 B:自建 API 服务(遗留 Docker 镜像)。 文档写明:letta/letta 镜像不再是积极维护的产品面。本地模型请改用 App / CLI 的 local mode;要在应用里嵌 Agent,用 App Server。若你仍要跑旧镜像做实验:
docker run \
  -v ~/.letta/.persist/pgdata:/var/lib/postgresql/data \
  -p 8283:8283 \
  -e OPENAI_API_KEY="sk-your-api-key-here" \
  -e ANTHROPIC_API_KEY="sk-your-api-key-here" \
  letta/letta:latest
服务默认 http://localhost:8283/v1。生产必须加 SECURE=true 和 LETTA_SERVER_PASSWORD,请求走 Authorization: Bearer。自定义工具要沙箱时再配 E2B。Docker 创建 Agent 必须显式指定 embedding(例如 openai/text-embedding-3-small),云 API 上这项才是可选。自带 Postgres 需要 pgvector:CREATE EXTENSION IF NOT EXISTS vector;。MemFS 要额外 LETTA_MEMFS_SERVICE_URL=local;local 只覆盖块级 API,Letta Code 那种 clone/push 的 git HTTP 在 local 模式会 501。
路径 C:把 Agent 嵌进 TypeScript 应用。 新项目用 Letta Agent SDK,而不是旧的 V1 letta-client:
import { LettaAgentClient } from "@letta-ai/letta-agent-sdk";

const client = new LettaAgentClient({ backend: "cloud" });
const agentId = await client.createAgent({
  persona: "You are Nora, a research analyst who tracks our competitors.",
});
await using session = client.resumeSession(agentId);
await session.send("What changed since last week?");
同一套 SDK 可以打到 Cloud、本机子进程或自建 App Server。Python 侧旧客户端连 Docker 时仍是「先 agents.create,再 agents.messages.create」——注意 base_url="http://localhost:8283",密钥占位符不要写进仓库。
ADE(Agent Development Environment)只能连 https 远程,唯一例外是部分浏览器的 localhost。自建要用 Caddy / Traefik / nginx,或 SSH 把 8283 转到本机。Safari 和新版 Chrome 连明文 localhost 也可能被拦。
五、选型对照:Letta 不是 CrewAI 的替身
把 Letta 理解成「又一个多智能体编排库」会买错。官方自己的对比口径是:Letta 更像带持久状态的 Agent 运行时;CrewAI / AutoGen 更像 任务/对话编排器。LangGraph 则把状态机交给你自己设计。
| 维度 | Letta | CrewAI | Microsoft AutoGen | LangGraph |
|---|---|---|---|---|
| 主问题 | 跨会话身份与自编辑记忆 | 角色团队怎么分工 | 多 Agent 对话与工具 | 图编排与 checkpoint |
| 记忆 | 内置块 + 召回 + 归档 | 基础/外挂 | 会话级,需自管 | 你自己设计 schema |
| 部署形态 | 服务 + DB,Agent 可寻址 | 库/流程,偏进程内 | 库 + Studio | 库 + LangSmith |
| 编码助手 | Letta Code / 桌面 / 频道 | 无官方对等物 | Magentic 等上层产品 | 无官方 IDE Agent |
| 模型 | 无关,推荐前沿模型 | 无关 | 无关 | 无关 |
| 最适合 | 长寿命助手、多会话产品 | 短任务流水线 | 研究型多 Agent 对话 | 复杂分支工作流 |
| 最不适合 | 单轮翻译/摘要 | 要跨月记住用户 | 只要持久人设 | 只想继承现成记忆协议 |
组合关系比「谁取代谁」更有用。Letta Agent 可以当 LangGraph 里的一个节点:外图层管路由和人工审批,内层 Letta 管「这个人是谁、这个项目上次怎么约定」。CrewAI 的角色定义可以映射成 Letta 的 persona 块,但你不会在 Letta 里重新发明一套 Task/Crew YAML 去跑一次性调研。AutoGen 的对话模式适合实验;一旦要「同一个客服 Agent 服务一万个用户且互不串记忆」,你需要的是每用户一个 Agent 实例 + 数据库级隔离,这正是 Letta 服务模型的本意。
成本也要算进选型。块每轮都进 Prompt,sleep-time 会在你没说话时烧 Token,工具调用让单轮变多步。换来的是:进程重启后不必重建人设,也不必把三个月聊天记录再次塞进窗口。单轮工具(翻译、摘要、一次性 SQL)用这套,纯属浪费。
六、排坑:空块、膨胀块、串用户、以及文档代差
空的 human 块。 跑了两周,块里还是初始化文案。原因几乎都是系统提示没把「何时写」写成可执行规则。修法:给正反例——「用户改了包管理器」要写,「这句语气有点急」不要写。再用 /remember 人工补第一条,观察 Agent 会不会跟着学。
膨胀的 human 块。 模型把记忆工具当成「我有在干活」的证明,每轮 append。窗口被自己的日记挤掉。修法:稳定事实才写;变化用 replace;定期 /doctor 或 sleep-time 合并。块超限时优先删微观观察,不要删身份与约束。
归档变成垃圾抽屉。 只 insert 不 consolidate,搜索命中全是近义重复。修法:空闲轮专门读最近条目、合并、删重复。插入时同时存「原句 + 一句转述」,降低「换种问法就搜不到」的概率。
跨用户污染。 一个 Agent 实例服务所有人,A 的偏好出现在 B 的块里。这不是模型幻觉,是存储作用域错了。修法:每用户(或每租户)独立 Agent;共享块只放真正要共享的组织知识;集成测试必须覆盖「A 写、B 读不到」。
Docker 代差。 镜像文档仍能跑通 8283,但官方已把它标成非主路径。Linux 连宿主机 Ollama 不要用 host.docker.internal,改 --network host。创建 Agent 漏了 embedding 会在归档检索时报错。ADE 连不上时先查是不是明文 HTTP 被浏览器拦。SQLite 方便 pip 安装,但官方迁移脚本主要维护 Postgres——要跟版本升级,别把生产放在 SQLite 上。
安全。 开启 SECURE 不等于工具安全。自定义工具默认有进程权限;生产要 E2B 或等价沙箱。MCP 工具在 MCP 服务端执行,不走 Letta 沙箱。密钥只进环境变量,示例一律 sk-your-api-key-here。
七、该上 Letta 的场景,以及明确不该上的场景
该上:同一个用户会跨周回来;产品承诺「我们记得上次的约定」;Agent 需要根据观察改自己的工作方式;你想让模型决定「什么值得记住」,而不是在应用层再写一套策展流水线。桌面/CLI 适合个人编码与助理;SDK + Cloud / App Server 适合把「可恢复的 Agent」嵌进现有 TypeScript 服务。
不该上:单轮工具;语料基本静态、只要 RAG 预pend;还在验证「记忆到底有没有用」的原型(先用一块 scratchpad,痛了再升级);应用已经有完整用户画像和会话库,再叠一层 Letta 只会双写。源文那种「框架用得越久模型就越聪明」的口播,落地时请翻译成:记忆卫生做得好,身份才稳;记忆卫生做差,窗口先被自己写爆。
配套脚本在本页的 practice/:一份标注了遗留镜像风险的 docker-compose.yml,以及连本地 8283 创建带 human/persona 块的 Python 示例。先把 Key 放进环境变量,再决定走 CLI 还是走服务。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: