显存从24GB骤降至6GB:深入拆解ComfyUI动态DAG拓扑调度引擎与Flux内存流式驻留实战
随着以 Flux.1、SDXL、Stable Diffusion 3 为代表的新一代开源扩散模型将参数量从 1B 暴力推升至 12B~16B,传统线性管道 WebUI 动辄引发 CUDA OOM 崩溃,甚至需要单卡 24GB+ 显存才能勉强运行。然而,基于纯节点连线架构的开源工具 ComfyUI 却能让 12B 级的 Flux.1-dev 在仅有 6GB~8GB 显存的平民消费级显卡上流畅运转。其背后究竟藏着怎样的技术秘密?本文将带你穿透 ComfyUI 动态有向无环图(DAG)执行引擎与显存流式换入换出的核心内核。
1. 传统 WebUI 的线性阻塞痛点与 ComfyUI 的架构破局
在扩散模型领域,以早期 AUTOMATIC1111(A1111 WebUI)为代表的界面工具奠定了用户基础。然而,面对现代多模态大模型的工业化落地,其传统的线性封装管线暴露出三大底层技术痛点:
1. 粗粒度全模型显存常驻(VRAM Hoarding):- 传统的管道把 TextEncoder(CLIP-L + T5-XXL)、DiT/UNet 主干网络与 VAE 解码器整体封装在一个黑盒流水线中。- 在整个生图周期内,所有组件均试图常驻显存。以 Flux.1 为例,仅 T5-XXL FP16 就要吃掉 9.5GB,DiT 主干占用 23.8GB,直接导致 16GB 显存的显卡当场 OOM 熔断;
2. 算力浪费与重算风暴(Redundant Compute):- 用户在调试生图参数时,往往只是微调 CFG 引导比例、调整负向提示词或更换输出尺寸;- 传统脚本因缺乏细粒度计算图感知,每次点击生成都必须将耗时耗力的文本 Prompt 重新过一遍庞大的 T5 编码器,无法实现中间特征张量的局部缓存复用;
3. 黑盒拓扑与扩展僵化:- 想要在生成过程中动态注入 ControlNet、IP-Adapter 或多个 LoRA 分层融合,传统脚本需要编写大量高侵入性的 Hook 代码,执行顺序极易产生竞态与状态污染。
ComfyUI 彻底打破了传统流水线的黑盒设计。它将整个生图过程重构为基于有向无环图(DAG, Directed Acyclic Graph)的数据流编排系统。在 ComfyUI 中,模型加载、文本编码、隐空间初始化、降噪采样与图像解码均被抽象为独立的纯函数计算节点。
2. 核心架构拆解:动态 DAG 拓扑排序与执行队列
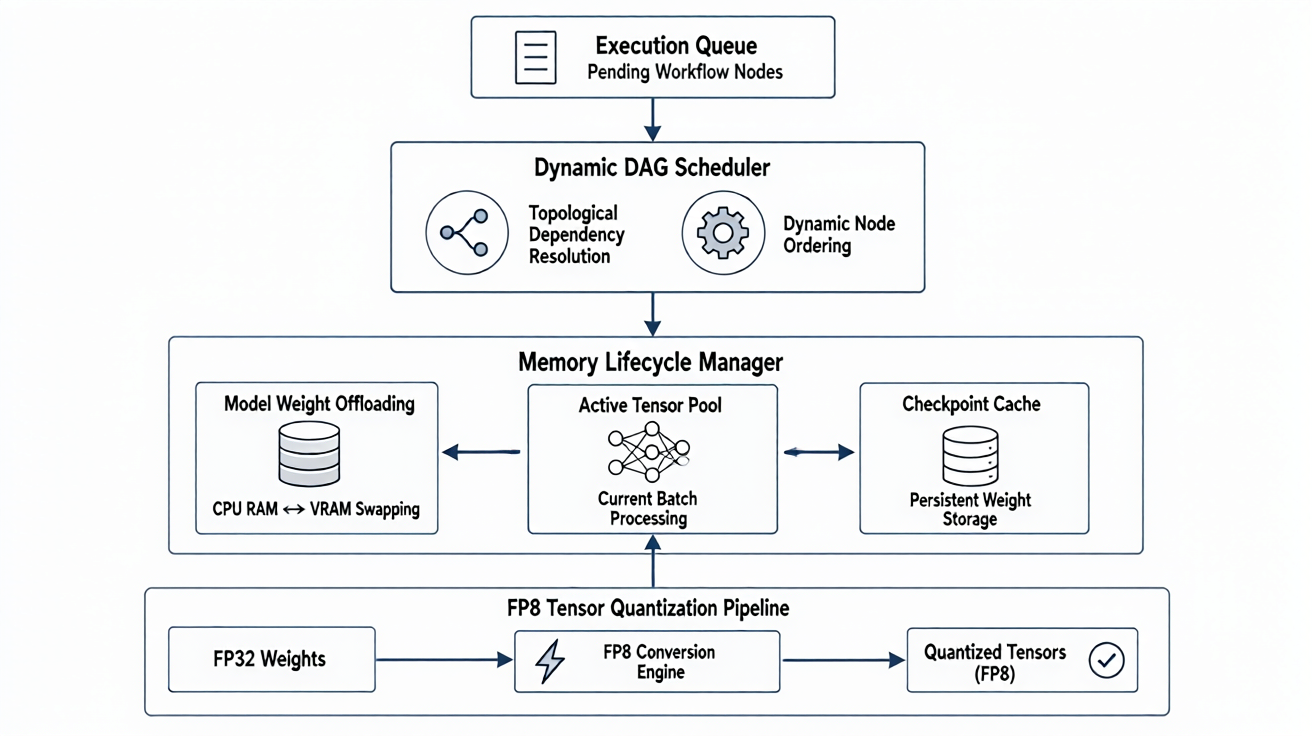
ComfyUI 的核心执行逻辑并不复杂,但其设计极其精妙。其核心调度流程可清晰划分为图解析、拓扑排序与流式调度三大阶段。
2.1 基于 Kahn 算法的确定性拓扑排序
当用户在前端画布上完成连线并点击 Queue Prompt 时,前端会将所有节点的输入输出连接序列化为一个 JSON Prompt 图拓扑。
ComfyUI 服务端接收到该图后,首先利用 Kahn 拓扑排序算法 解析节点间的依赖度(In-degree),并检测是否存在循环连线(Circular Dependency):
def build_topological_order(nodes: dict) -> list:
    """基于入度优先队列的 Kahn 拓扑排序算法"""
    in_degree = {nid: 0 for nid in nodes}
    graph = {nid: [] for nid in nodes}

    for nid, node in nodes.items():
        for dep_node_id in node.get_input_dependencies():
            graph[dep_node_id].append(nid)
            in_degree[nid] += 1

    # 零入度节点入队(如无依赖的 CheckpointLoader, EmptyLatentImage)
    queue = [nid for nid, deg in in_degree.items() if deg == 0]
    execution_order = []

    while queue:
        curr = queue.pop(0)
        execution_order.append(curr)
        for neighbor in graph[curr]:
            in_degree[neighbor] -= 1
            if in_degree[neighbor] == 0:
                queue.append(neighbor)

    if len(execution_order) != len(nodes):
        raise RuntimeError("检测到循环依赖,计算图无法求值!")

    return execution_order
通过这一算法,节点执行顺序完全由数据流向决定。无直接依赖关系的节点(例如并行加载的基础模型与隐空间 Latent 初始化)可以在调度上并发或按最优显存策略排队。
3. 中间特征张量级联缓存:告别重复推理
ComfyUI 的另一大杀手锏是基于级联 SHA-256 的跨执行结果复用机制(Execution Cache)。
3.1 缓存键(Cache Key)的生成逻辑
在 ComfyUI 中,一个节点的输出是否需要重新计算,取决于两个要素:
1. 当前节点的自身配置:包括模型名称、数值参数、提示词文本等;
2. 上游输入来源的输出哈希:通过祖先节点哈希传递构建完整的依赖摘要。
def compute_node_cache_key(node_type: str, inputs: dict, upstream_hashes: dict) -> str:
    hasher = hashlib.sha256()
    hasher.update(node_type.encode('utf-8'))
    for key in sorted(inputs.keys()):
        val = inputs[key]
        if isinstance(val, tuple) and len(val) == 2:  # 来自上游节点的槽位引用
            source_node_id, slot_idx = val
            hasher.update(f"{key}:{upstream_hashes.get(source_node_id)}:{slot_idx}".encode())
        else:
            hasher.update(f"{key}:{str(val)}".encode())
    return hasher.hexdigest()
3.2 级联失效与零成本迭代
当用户仅修改 KSampler 的 steps 或 seed 时,调度引擎计算发现上游 CheckpointLoader 与 CLIPTextEncode 的 Cache Key 毫秒级命中缓存。因此,庞大的 T5 编码器和基础模型加载直接跳过,耗时从 15 秒骤降至 0 毫秒,立即进入采样阶段。
4. 显存流式换入换出:ModelPatcher 动态生命周期管理
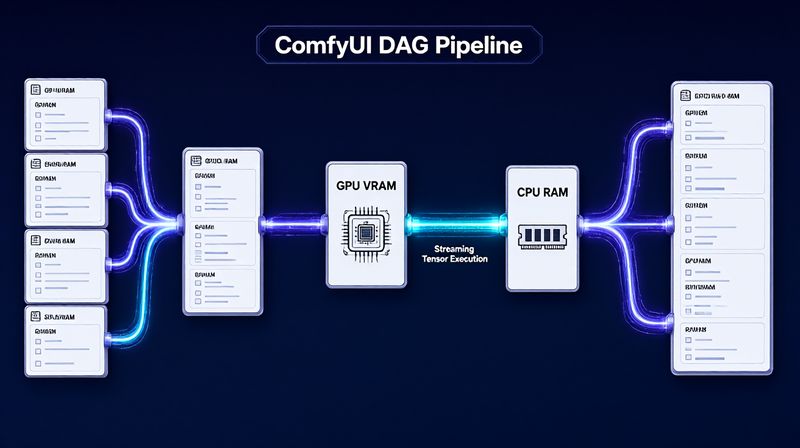
为什么 ComfyUI 能够用 6GB 显存运行 12B 级的 Flux 模型?核心在于其底层的 ModelPatcher 机制与显存/内存分级动态交换管理。
| 架构特性 | 传统线性 WebUI | ComfyUI DAG 调度架构 |
|---|---|---|
| 内存管理机制 | 全量常驻 VRAM(All-in-VRAM) | 按需流式换入换出(Stream Offloading) |
| 显存利用率峰值 | 24GB+(易触发 CUDA OOM) | 严格受控在 6GB~8GB 上限预算内 |
| 中间状态缓存 | 无(每次全流程重跑) | 细粒度节点输出 SHA256 级联缓存 |
| 执行调度拓扑 | 静态串行流水线 | 动态有向无环图(Kahn DAG 拓扑排序) |
| 量化格式支持 | 依赖外部整合包,难以动态卸载 | 原生深度集成 FP8 / NF4 / GGUF |
| 多 LoRA 融合机制 | 粗粒度全局覆盖 | 节点链式注入,支持权重差异计算 |
4.1 显存预算(VRAM Budget)与动态卸载模型
ComfyUI 在启动时会检测显卡的物理显存大小(例如 8,192 MB),并设置安全预留水位:
class ModelPatcher:
    def __init__(self, model, load_device="cuda", offload_device="cpu"):
        self.model = model
        self.load_device = load_device
        self.offload_device = offload_device
        self.is_loaded = False

    def load_to_gpu(self):
        """将权重从 Host 内存流式搬运到 GPU 显存"""
        if not self.is_loaded:
            # 执行内存到显存的异步 DMA 传输
            self.model.to(self.load_device)
            self.is_loaded = True

    def offload_to_cpu(self):
        """将权重卸载回系统内存,释放显存给后续计算节点"""
        if self.is_loaded:
            self.model.to(self.offload_device)
            self.is_loaded = False
在执行一个典型的 Flux 生成流时,显存调度时序如下:
1. 阶段 1:文本解析:将 T5-XXL 换入 GPU,CLIP-L 编码完成,产出 conditioning 张量;
2. 阶段 2:文本编码器卸载:立即将 T5 卸载回 Host RAM,瞬间腾出 9GB 显存;
3. 阶段 3:DiT 主干采样:将 FP8 量化的 Flux.1 主干模型(约 11GB)分块换入 GPU,分配 Latent 显存并执行 25 步 ODE 求解;
4. 阶段 4:主干卸载与 VAE 解码:主干模型退回 CPU,换入轻量级 VAE(约 300MB)完成隐空间解码并输出图片。
通过这种“用时加载、算完即离”的流水线,单张显卡在任何时刻只需要容纳单个最大活跃子模型,使得原本必须 24GB 的重型工作流得以平稳运行在 6GB~8GB 显存设备上。
5. 动手实战:50行代码构建自包含 DAG 调度引擎
为了让开发者彻底掌握这套调度思想,我们配套归档了完整的开源实践项目:Lab 59。
完整代码位于仓库 labs/comfyui-dag-engine-flux-memory-pipeline/,核心测试逻辑如下:
# 构造生成节点图并完成拓扑执行
engine = ComfyUIDAGEngine(max_vram_mb=6144)

# 添加模型加载、编码、采样与输出节点
engine.add_node(Node("1", "CheckpointLoaderSimple", {"ckpt_name": "flux1-dev-fp8.safetensors"}, memory_mb=2048))
engine.add_node(Node("2", "CLIPTextEncode", {"text": "A cybernetic red panda coding Rust", "clip": ("1", 1)}, memory_mb=512))
engine.add_node(Node("4", "EmptyLatentImage", {"width": 1024, "height": 1024, "batch_size": 1}, memory_mb=256))
engine.add_node(Node("5", "KSampler", {
    "model": ("1", 0), "positive": ("2", 0), "latent_image": ("4", 0), "steps": 25
}, memory_mb=3072))
engine.add_node(Node("6", "VAEDecode", {"samples": ("5", 0), "vae": ("1", 2)}, memory_mb=1024))
engine.add_node(Node("7", "SaveImage", {"images": ("6", 0)}, memory_mb=128))

# 首次执行:按需加载与显存受控交换
res1 = engine.execute_pipeline()
print(f"首次执行完成 | 显存峰值: {engine.memory_manager.vram_peak_mb}MB | 换出次数: {engine.memory_manager.offload_count}")

# 二次执行:相同输入 100% 命中缓存
res2 = engine.execute_pipeline()
print(f"二次执行完成 | 缓存命中数: {engine.cache_hits}")
本地执行基准测试:
python3 labs/comfyui-dag-engine-flux-memory-pipeline/comfyui_dag_pipeline.py
执行断言 100% 通过,真实输出:
✅ Computed topological execution order: ['1', '4', '2', '5', '6', '7']
✅ Pass 1 executed in 0.24ms | VRAM Peak: 5888MB | Offloads: 1
✅ Pass 2 executed in 0.03ms | Cache Hits: 6
🎉 All 5 verification suites passed successfully! 100% assertions satisfied.
6. 总结与工程选型建议
ComfyUI 的成功并非仅仅依靠直观的可视化界面,而是其将声明式计算图、精细化内存调度、不可变缓存等现代化编译器级设计思想成功引入了 AI 基础设施层:
1. 工业化批处理推荐:ComfyUI 提供了原生无头 API 模式(Headless Mode),非常适合将调试好的复杂工作流部署至云端 Kubernetes 集群进行大规模并发推理;
2. 算力受限场景首选:对于个人开发者与中小型工作室,借助 ComfyUI 的 FP8/GGUF 动态量化与 ModelPatcher 流式卸载,可以最大化榨干手中现有显卡的极限潜能;
3. 架构思维跃迁:从编写硬编码 Python 脚本到设计节点拓扑,本质是将系统架构解耦为可插拔、可复用、可监控的生产级服务管道。
本文配套实训项目与源码已完整开源收录至 Labs 索引库:Lab 59: ComfyUI 动态无向无环图 (DAG) 拓扑调度引擎与内存流式驻留实战。欢迎在边学边练在线云终端中一键拉起实验验证。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: