Claude Code 接本地向量库:内容仓与索引仓分离的自建检索
每个月账单里那一两百块「AI 知识库会员」,点开次数往往个位数;更糟的是,搜出来的段落「看起来相关、读三行又不对」。和本站写过的「本机 DeepSeek + Open WebUI 做 RAG」、以及「claude-mem 做会话记忆」不同,这篇把镜头对准另一条路线:把 Markdown 笔记仓和索引工具仓拆开,用本地 embedding + ChromaDB,再通过 MCP 挂进 Claude Code,让你在写代码的终端里一句话召回自己的技术方案。
目标很朴素:数据留在本机、检索策略可改、不按月给境外 SaaS 交「黑盒分块费」。下面按痛点、架构、分块、接入、排坑五段把方案说透,并给出可复用的最小实践骨架。
为什么月费知识库越用越不爽
第一年用商业 AI 笔记/知识库时,体验往往不错:网页、PDF、碎片笔记一股脑扔进去,对话式整理答案。用久了会出现四类硬伤,和「模型聪不聪明」关系不大,和产品契约关系很大。
价格与使用频率错位。 个人档常见月费两三百,企业档轻松四位数。独立开发者一算账:一年订阅费够买多年廉价云主机。若真天天用、命中率高,这笔钱还能认;现实是很多人一个月打开不到三次。
内容不可控。 想改已上传文章?多数只能删了重传。想批量导出?Markdown 格式乱、内链变死链、图片丢失。你付钱存数据,却很难真正「拥有」自己的笔记图。
检索是黑盒。 embedding 用哪家、chunk size 多少、按标题还是按 token 切——客服常见回复是「AI 会自动选最优策略」。对做过后端的人来说,这比承认「还没做好」更难受:你没法根据技术文、FAQ、设计模式笔记分别调策略。
数据出境与合规。 不少产品节点在海外,隐私政策里「用于改进服务」措辞模糊。脱敏过的架构图、性能数字、内网方案一旦上云,心里那道坎和合规红线都会亮起来。
自己搭知识库的动机,常常不是炫技,而是忍不了「付钱却管不了分块与落点」。
因此,最小需求可以收敛成一句话:笔记是干净 Markdown;索引可本地重建;查询延迟可接受;入口嵌进日常写代码的 Claude Code,而不是再开一个网页会员。
三件积木:ChromaDB、本地 Embedding、MCP
整条链路不神秘,拆成三块就够讲清楚。
ChromaDB 扮演「给语义用的搜索引擎」:文本变成向量后写入集合,查询时按相似度取回 chunk。开源、可本机持久化,个人规模不必一上来上云向量库。
本地 embedding 源文方案选用 paraphrase-multilingual-MiniLM-L12-v2:约 384 维,多语言,中英混排术语场景友好;CPU 可跑,笔记本上常见是毫秒到亚秒级编码。没有 GPU 也能起步。
MCP(Model Context Protocol) 是 Claude Code 与外部工具的「通用插头」。知识库侧暴露若干工具(例如语义搜索、主题列表、索引统计),Claude 在对话里按需调用,而不是把整库塞进 system prompt。
架构上强烈建议 双仓分离:
| 仓库角色 | 典型命名 | 职责 | 不该放什么 |
|---|---|---|---|
| 内容仓 | awesome-ai-kb 一类 |
按主题组织 Markdown(Redis / Kafka / JVM / 架构……) | Python 依赖、向量文件、MCP 配置 |
| 工具仓 | kb-builder 一类 |
分块、建索引、MCP server、install.sh |
业务笔记正文 |
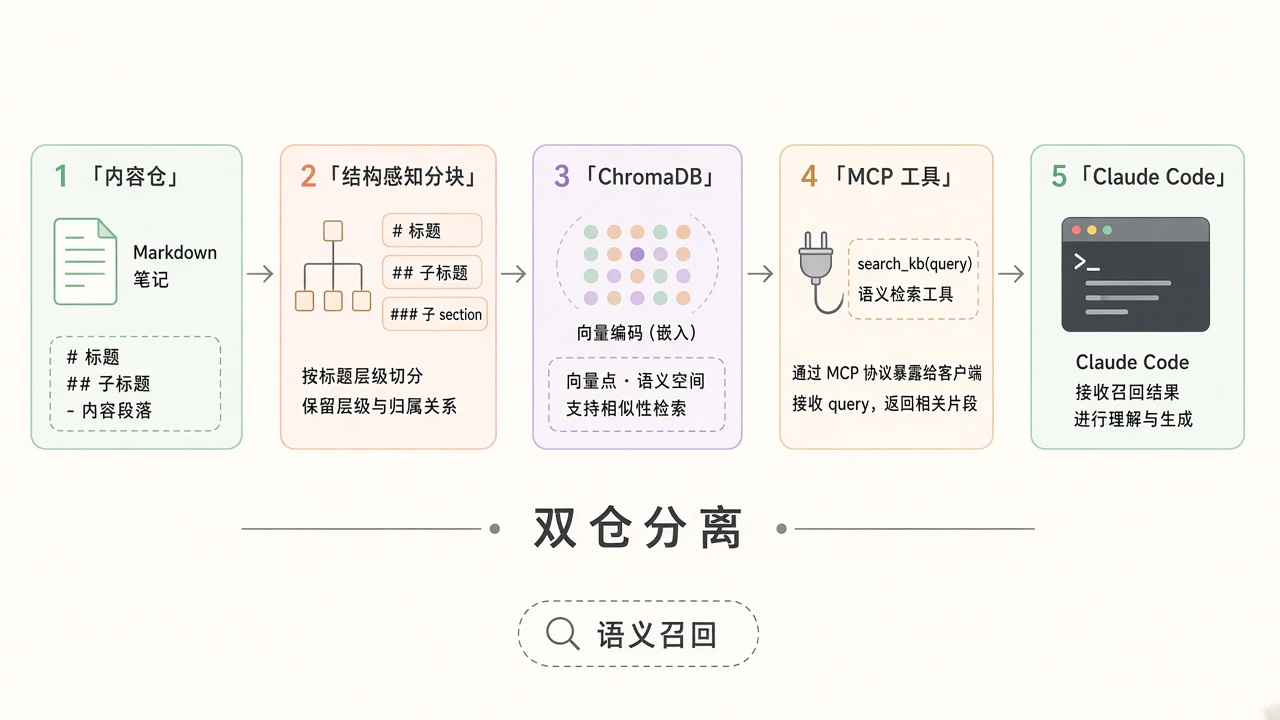
内容仓永远是「人可读、可 git 同步」的纯文本;工具挂了可以换实现,笔记不用搬家。这和「把模型、向量库、WebUI 捆在一个 compose 里」的本地 DeepSeek RAG 文是不同产品形态:那边偏离线聊天窗口 + 文档库;这边偏 IDE/CLI Agent 工具调用。
源文作者给出的个人库量级可作参照(不是你的 KPI,而是「个人规模够用」的量感):约 240 篇 Markdown → 三种分块策略后约 5877 个语义块 → 自测 50 次随机查询时,前三结果里至少两条高度相关的比例约 75%+;本机单次查询多在约 800ms 内返回。商业 SaaS 或许有 CDN,但本地无跨境抖动、也不怕对方宕机。
分块策略决定命中率,别迷信「默认最优」
黑盒产品最伤人的地方,往往不是「有没有向量」,而是怎么切。源文把稳定版策略收敛到三路组合,很适合技术笔记场景,值得照着实现或改成自己的配置表。
1. 结构感知分块(约 800 字)
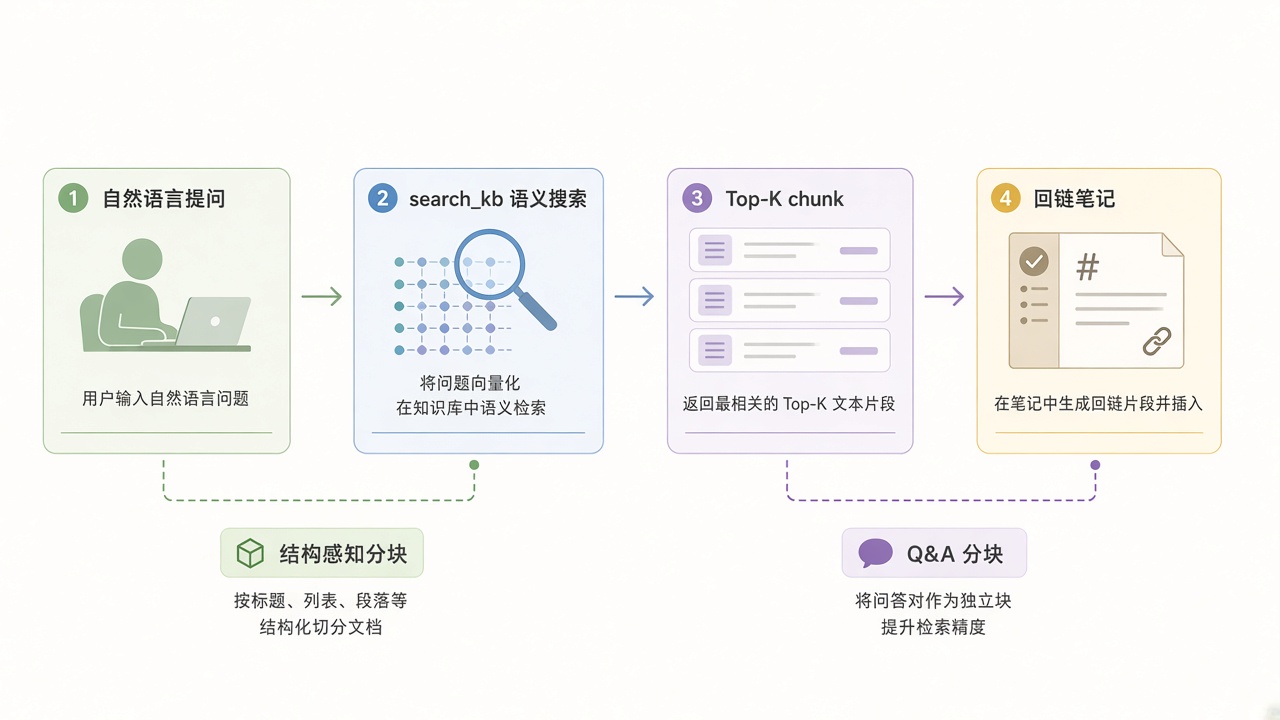
面向长文教程:按 H2/H3 自然边界切,避免一段「半截原理 + 半截命令」混进同一向量。标题进 metadata,召回后方便回链原文。
2. 模板段落分块(约 600 字)
面向设计模式、最佳实践这类「固定小节骨架」的内容。按模板段落切,相似度更干净,减少「同主题但不同模式」的串味。
3. Q&A 对分块
面向 FAQ、踩坑笔记:一问一答一块。查询本身常常也是问句,这类块在语义空间里更容易贴上去。
三路组合后,命中率才有机会压过「全家桶一个 chunk size」的付费产品。实践上建议把策略写进工具仓配置(YAML/JSON),并给每块打上 strategy、topic、source_path 元数据,方便事后抽样验尸。
# 伪配置:按路径前缀选分块器
chunkers:
  - match: "faq/**/*.md"
    strategy: qa_pair
  - match: "patterns/**/*.md"
    strategy: template_600
  - match: "**/*.md"
    strategy: structure_800
检索「不准」时,先查分块与 metadata,再怪 embedding 模型——顺序反了会白换更大模型。
和「只把文件夹丢给 Claude Code 让它 grep」的轻量方案比:grep 对精确关键词极快,但对「用另一种说法问同一件事」无力;向量检索补的就是这层语义。个人库两者可以并存:MCP 先语义召回,再让 Claude 打开源文件精读。
接到 Claude Code:三个工具就够开工
MCP 工具面不必一开始做十八般兵器。源文落地的最小集非常克制,也正好对应日常动作:
| 工具名 | 作用 | 典型提问 |
|---|---|---|
search_kb |
自然语言语义搜索,返回最相关 chunk | 「我笔记里 Redis 热点 key 怎么处理的?」 |
list_kb_topics |
查看主题覆盖 | 「库里现在有哪些分类?」 |
get_kb_stats |
索引规模与健康度 | 「一共多少块、上次索引时间?」 |
在 Claude Code 侧,工具仓提供的 MCP server 注册进用户或项目级配置后,写代码过程中不用切浏览器会员页:一句话触发 search_kb,把命中片段当上下文继续改代码。这正是相对「单独 WebUI RAG」的增量——检索入口长在 Agent 工作流里。
最小注册思路(示意,路径按本机修改):
{
  "mcpServers": {
    "personal-kb": {
      "command": "python",
      "args": ["-m", "kb_mcp_server"],
      "env": {
        "KB_CHROMA_PATH": "/path/to/kb-builder/chroma_data",
        "KB_CONTENT_ROOT": "/path/to/awesome-ai-kb"
      }
    }
  }
}
索引更新可以做成「新增 Markdown → 跑一条 reindex →(可选)git hook」。内容仓保持干净,工具仓负责脏活:下载 embedding 权重、写 Chroma 持久化目录、暴露 stdio MCP。
硬件预期也很现实:源文在 M1 MacBook Air 上跑 Chroma + 本地 embedding,内存占用常在约 500MB 量级,无 GPU 要求。中文与中英混排术语,多语言模型通常比「纯英文 embedding 硬上中文笔记」更稳;若以后要上更大模型,只要重建索引即可,内容仓不动。
本页 practice/ 放了一份最小可跑骨架说明:用同一 embedding 名、本地持久化目录、以及三个工具名的契约,方便你对照源文思路自建,而不必等待某个尚未公开完整镜像的私有仓库。
适不适合你、以及常见坑
更适合自建的人: 已有几十篇以上成体系技术笔记;在意「搜出来的是我的语境」;有隐私/合规约束;愿意花半天做初始搭建,换长期免月费与可调策略。
更适合继续用商业产品的人: 笔记很少、零散;完全不想碰 install.sh 或 Python 环境;只把知识库当偶尔外脑,对命中率不敏感。
常见问题可以提前打预防针:
- 维护成本: 文章就是
.md;更新索引可自动化。工具坏了不影响内容仓。 - 团队场景: 个人版通常不做权限与多租户;先把单人召回做稳,再谈协作。
- 和 Notion AI / Readwise 的边界: 后者擅长采集与回顾,底层模型与分块你管不了;自建换的是控制权,代价是自己运维。
- 和 claude-mem 的边界: claude-mem 偏会话/工程记忆持久化;本文偏静态知识笔记的语义检索。两者可并存,但别把「对话流水」和「精修笔记」混进同一个未分策略的集合。
- 和本机 DeepSeek RAG 文的边界: 那条线是 Ollama + WebUI 离线问答;本条线是 Claude Code + MCP 工具调用。选入口,再选栈。
排坑清单建议贴在工具仓 README:
1. 先用 get_kb_stats 确认块数与主题,再抱怨「搜不到」。
2. 抽 20 条真实查询做小回归,改分块策略后重跑,不要凭体感调参。
3. 内容仓禁止提交 chroma/、模型缓存、.env。
4. MCP 与原生 Auto Memory 同时灌大量日志时,模型可能偷懒不调工具——保持 CLAUDE.md 精简,动态知识走 search_kb。
小结
退订月费知识库之后,真正要夺回的不是「又一个聊天框」,而是 分块策略、数据落点、以及检索入口是否长在你每天打开的 Agent 里。ChromaDB + 多语言本地 embedding + MCP,再配上内容仓与工具仓分离,是一条个人规模足够、工程上可维护的路:笔记可 git 同步,索引可随时重建,策略写在自己仓库里而不是藏在客服话术里。
落地顺序建议固定成三步:先把 search_kb / list_kb_topics / get_kb_stats 跑通;再用 20 条真实提问做小回归,专门调结构感知与 Q&A 分块;最后才考虑换更大 embedding 或加 Web 面板。命中率上来之后,账单焦虑通常会先消失,检索焦虑才会成为你唯一愿意继续折腾的部分——而这恰恰说明控制权已经回到你手里。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: