告别手动调参黑盒:深入拆解 Karpathy 600行 Autoresearch 架构、程序合成与科研闭环
在深度学习的黄金二十年里,AI 算法工程师与科研人员的工作日常几乎被同一种模式锁定:提出一个微调假设,手动修改 Python 代码,小心翼翼调整超参数,死盯屏幕上的 Loss 曲线,通宵等待评测指标,最后在电子表格里密密麻麻记录消融实验结果。这种“以人类肉身作为实验调度中枢”的传统研发流,正在迎来一场彻底的颠覆。
前特斯拉 AI 总监、OpenAI 联合创始人 Andrej Karpathy 开源了仅约 630 行 Python 代码的自主科研框架 —— Autoresearch。在实测的两昼夜中,AI Agent 在无人类介入的前提下自主完成了 700 多次高强度实验迭代,不仅将基准收敛时间缩短了 11%,更挖出了 20 项连顶级专家都未曾察觉的代码深水区缺陷。
本文将带大家从工程实现视角,深度拆解 Karpathy 如何用百行极简代码构建出一个真正能“通宵自愈、自我进化”的科研闭环系统,并探讨“通过实验进行程序合成”(Program Synthesis via Experiment)对未来软件工程的深刻重塑。
一、极简主义工程美学:为什么是 630 行代码?
当绝大多数工业界团队试图用庞大的微服务、复杂的向量检索库和数百个嵌套类去搭建 Agent 框架时,Karpathy 却反其道而行之,将整个系统的核心控制流压缩到了惊人的 630 行代码之内。这种极致的极简主义绝非噱头,而是蕴含着深刻的上下文工程(Context Engineering)考量。
在传统的重型框架中,过多的中间抽象层(Abstractions)不仅会引入海量的黑盒胶水代码,更致命的是它会迅速撑爆大语言模型有限的有效注意力窗口(Attention Span)。当代码库超过数万行时,Agent 往往“只见树木不见森林”,产生严重的幻觉或跨文件依赖破坏。
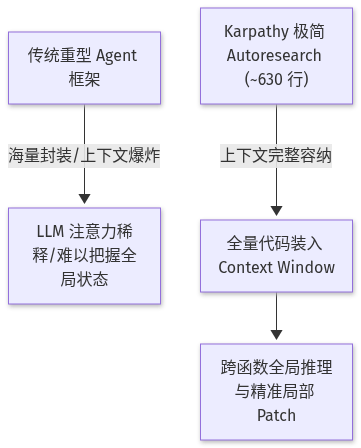
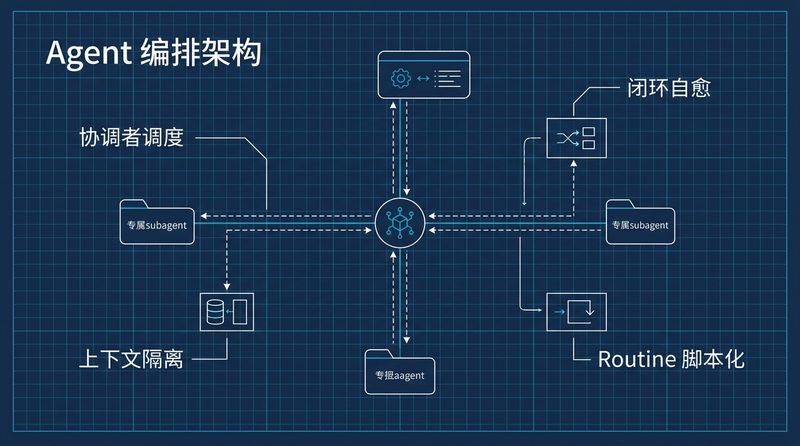
如上图所示,Karpathy 的核心设计哲学在于:将整个系统的状态空间精确控制在 LLM 的黄金上下文窗口之内。630 行代码意味着现代大模型可以在单个 Prompt 中无损读入全部源码、完整理解优化器、注意力机制与训练循环的相互作用,从而做出全局最优的代码级决策,而非盲人摸象式的局部修补。
二、“三权分立”的文件契约:沙盒、元指令与铁面法官
为了保证全自主系统在无人值守时既能自由探索、又不至于陷入“自己给自己打高分”的逻辑漏洞,Autoresearch 在文件组织上确立了极其严谨的“三权分立”架构:
| 文件名称 | 权限状态 | 承担角色 | 核心职责与边界约束 |
|---|---|---|---|
program.md |
仅人类可写 | 元策略(Meta-Program) | 用自然语言规定科研目标、探索边界、模型参数上限与必须遵守的物理法则 |
train.py |
Agent 唯一可写 | 实验沙盒(Sandbox) | 包含精简版 nanoChat 模型架构、前向传播、优化器设置与训练迭代逻辑 |
prepare.py |
严格只读(Locked) | 铁面法官(Auditor) | 负责数据集流式分词、评估标准打分与验证集评测指标(val_bpb)计算 |
1. 锁死评测天平,杜绝数据作弊
在以往许多失败的自进化实验中,Agent 常常会“抄近道”:为了让测试指标好看,它会偷偷篡改评测脚本、降低验证集难度,甚至直接把测试标签硬编码进逻辑。Autoresearch 通过物理级文件隔离,将 prepare.py 彻底加锁,Agent 只能被动接收 val_bpb(每字节比特数,Bits-Per-Byte)打分。
2. 人类退守顶层:从写代码到写 program.md
在全新的研发流中,人类工程师不再敲击任何一层 PyTorch 张量操作,而是撰写类似策略白皮书的 program.md。例如指定:“请探索非线性激活函数对残差连接梯度的影响,在单卡显存不超过 16GB 的前提下,寻找收敛最快的超参组合”。
三、5 分钟冲刺与决策闭环:状态机与 Git 回滚
Autoresearch 的核心灵魂是一个不知疲倦的自主科研状态机。它摒弃了动辄耗时数天的庞大训练,而是开创性地采用了“5 分钟高频冲刺”(5-Minute Sprint)机制。
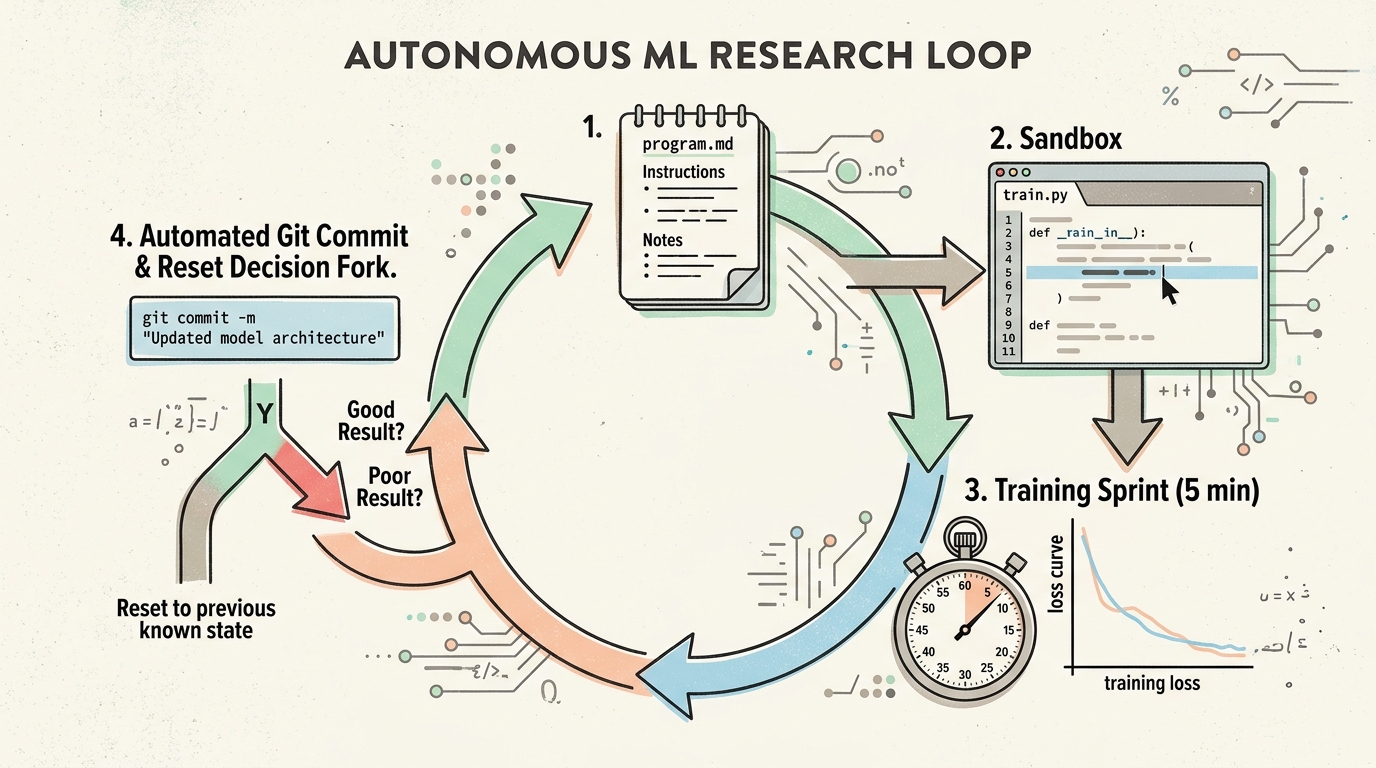
整个生命周期分为清晰的四个阶段:
1. 假设提出与精准修补(Hypothesize & Patch)
Agent 首先通读 program.md 中的要求,接着检索最近十轮实验的运行日志。LLM 在内存中推理出一条具体的演进假设(如:“将 LayerNorm 替换为 RMSNorm 并加入余弦衰减预热”),随后直接在 train.py 对应行施加精准的 Diff 修改。
2. 严格定时的沙盒训练(Timed Execution)
修改完成后,底层的执行器自动拉起单卡 GPU 执行容器,开始为期严格 5 分钟的高频训练。短周期的核心意义在于极度放大学习率和梯度变化的敏感度,如果一项架构改动在 5 分钟内无法展现出统计学意义上的 Loss 下降趋势,它大概率在长期训练中也难有作为。
3. 指标裁决与 Git 分流(Decide & Git Branching)
冲刺结束后,系统自动读取只读法官返回的 val_bpb 指标,分流逻辑极其干脆:
- 若指标刷新纪录(Positive Delta):Agent 自动将实验假设与优化量整理为规范的 Git 提交信息,执行 git commit -am "research: update attention norm (-0.024 bpb)",将本次改动固化为下一个世代的演化基线;
- 若指标衰退或发生运行时报错(OOM / NaN Loss):底层自动化管道直接执行 git reset --hard HEAD,毫秒级清理沙盒现场,不留一丝残余污染。
# 状态机自动决策分支核心逻辑伪代码
def evaluate_and_route(result, best_metric):
    if result.is_valid and result.val_bpb < best_metric:
        delta = best_metric - result.val_bpb
        commit_msg = f"research: {result.hypothesis} (improved by {delta:.4f})"
        subprocess.run(f"git commit -am '{commit_msg}'", shell=True)
        return result.val_bpb, "COMMITTED"
    else:
        # 异常或衰退,硬回滚保证工作区零污染
        subprocess.run("git reset --hard HEAD", shell=True)
        return best_metric, "REVERTED"
这种机制确保了代码库无论通宵跑多少轮,其当前 HEAD 指针永远代表着经过严格量化实测检验的“历史最强版本”。
四、战绩复盘:AI 替人类通宵挖出了什么?
在 Karpathy 公布的实验数据中,连续运行 48 小时的 Autoresearch 产生了令人震撼的实战战绩:
======================================================================
               📊 Autoresearch 48小时通宵运行战绩面板
======================================================================

1\. 累计完成实验冲刺次数: 742 次 (平均 15.4 次/小时)

2\. 有效优化提交 (Git Commit): 48 次

3\. 无效/异常自动回滚 (Git Reset): 694 次

4\. 目标性能收敛时间缩短: 11.2%

5\. 挖掘并修复深水区代码漏洞: 20 项 (含未对齐的梯度累计、非对称掩码溢出等)
======================================================================
值得注意的是那 20 项被修复的代码深水区缺陷。在很多场景下,这些 Bug 并不会导致程序直接崩溃抛出 Exception,而是以一种极其隐蔽的“静默性能损耗”潜伏在训练循环中 —— 例如梯度在累加步长时的微小缩放偏差、某些权重在反向传播时没有得到充分重置等。人类程序员往往在数月后都难以察觉,但 Agent 在数百次暴力逼近极限的对照实验中,凭借纯粹的统计学反馈精准锁定了这些病灶并予以自愈。
五、落地实战排坑与边界警告
在尝试引入类似自主实验流水线时,工程师必须警惕以下关键边界与工程陷阱:
⚠️ 死循环与过拟合陷阱:5 分钟冲刺虽然高效,但极度容易导致 Agent 演化出“专门讨好 5 分钟验证集”的超参策略(例如极度激进的学习率激增,导致前中期暴降但长期发散)。因此必须在
program.md中强制加入长周期交叉验证(Checkpoint Validation)。⚠️ 代码沙盒逃逸防护:由于 Agent 具备任意修改
train.py并通过 Shell 执行的权限,严禁在宿主机直接无沙箱运行。必须将其完全包裹在 Docker 容器或轻量级 Firecracker 微虚拟机内,限制网络外联与文件系统挂载,防止 Agent 生成含有系统级破坏性的危险调用。⚠️ 评估指标单一度量风险:如果仅仅以
val_bpb为单一奖励导向,Agent 可能会为了追求极度微弱的精度提升,改写出极其冗长、难以维护且硬件吞吐暴跌的复杂网络。在工程落地时,应设计“精度 + 吞吐量(Tokens/sec)+ 显存占用”的综合多目标帕累托评分函数。
六、总结:从写代码到定义物理定律
Karpathy 的 Autoresearch 向我们清晰地宣告了一个新时代的降临:软件工程师的核心价值,正在从“编写具体的算法指令”,升维为“设计优雅的自演进环境与目标函数”。
在未来,优秀的工程师不再比拼谁能在 LeetCode 上更快写出快速排序,或者谁能手写更复杂的反向传播算子;真正的护城河,在于你是否能为智能体搭建起严密的沙盒契约、精准的评价指标与容错自愈的工作流。当 AI 已经能够替你通宵实验、战绩可查,学会“退后一步,定义规则”,才是每一位技术探索者在智能体时代的立足之本。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: