

拒绝将隐私对话喂给云端:深入拆解开源 ChatLab 本地优先架构、流式 SQL 引擎与社交 Agent 落地实战
在移动互联网深耕十余年后,微信、QQ、WhatsApp 等即时通讯工具早已演进为你我数字人生的核心中枢。每天产生的工作沟通、技术探讨、朋友闲聊,无一不沉淀着高密度的社交记忆与隐性价值。
然而,每当你萌生出“想复盘过去一年谁在技术群里发言最多”、“挖掘某个群聊被疯狂 +1 的高频金句”或“用大模型审问自己历史对话细节”的想法时,摆在面前的往往是一堵巨大的技术与安全高墙:
1. 隐私泄露的巨大阴影:绝大多数宣称具备 AI 分析能力的第三方商业服务,都需要将全量聊天记录上传至其远程云端进行清洗与 Embedding。个人行踪、敏感代码、财务流水直接暴露在不可控的网络传输与第三方存储下;
2. 异构协议的格式泥潭:微信采用专有的 SQLite 加密库(如 WCDB)、QQ 使用独有加密数据文件、WhatsApp 则是特定导出的 Text/ZIP 包,数据结构碎片化严重;
3. 海量记录的性能崩溃:动辄数十万甚至数百万条的聊天记录,一旦直接塞进常规前端界面或未优化的内存数据库,瞬间引发严重的内存泄漏(OOM)与界面冻结卡顿。
今天我们要深度拆解的开源项目 —— ChatLab(GitHub 仓库:hellodigua/ChatLab,由知名开发者 hellodigua/地瓜 倾力打造,其亦是高赞工具 code996 的作者),正是为了终结这一痛点而生。它坚持纯正的 Local-First(本地优先) 架构设计,在你的本地主机上搭建起流式 SQL 数据计算管道与具备 10+ 动态 Function Calling 能力的社交 AI Agent。
一、为什么本地优先(Local-First)是社交数据分析的唯一正解?
在深入代码与工程架构之前,我们首先需要从安全与系统架构两个维度明确:为什么聊天记录分析工具必须恪守 Local-First 原则?
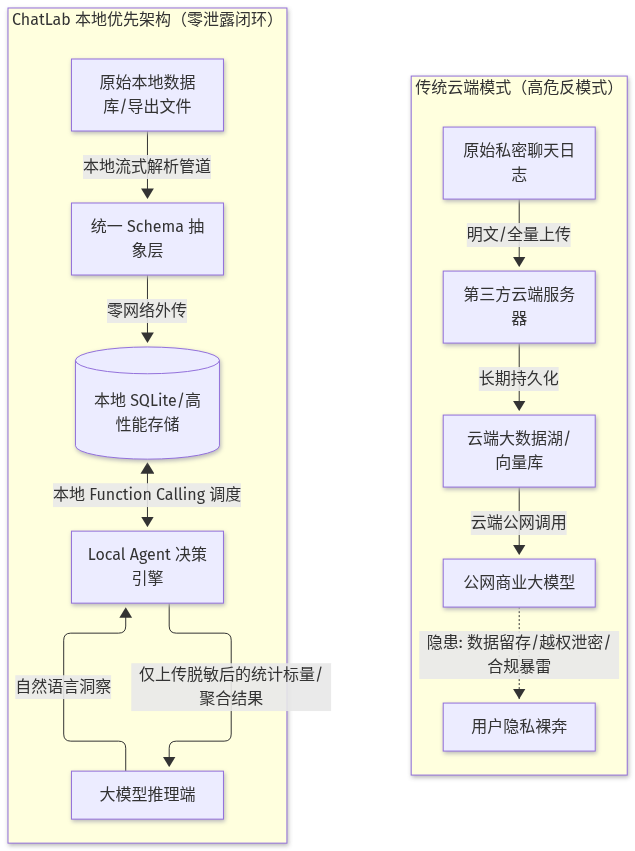
如上图所示,在 ChatLab 的本地优先哲学中,数据流转被划分为两个截然不同的物理边界:
- 数据面(Data Plane)100% 固化在本地:聊天记录的解密、流式规整、分批落库、建立索引以及核心的 SQL 过滤运算,全部在用户单机环境中闭环运行;
- 控制面(Control Plane)最小化透传:当且仅当用户开启 AI Agent 对话洞察时,大模型接收到的仅是数据库表结构 Schema、当前用户自然语言意图以及本地工具函数执行返回的脱敏聚合标量(例如 {"count": 42, "user": "张三"}),对话明细与隐私全文绝对不离开本地物理设备。
二、本地流式计算引擎与异构数据抽象层
面对微信、QQ、WhatsApp 等不同平台的碎片化数据结构,ChatLab 没有采用为每个平台硬编码一套独立视图的愚钝做法,而是构筑了清晰的分层数据抽象:
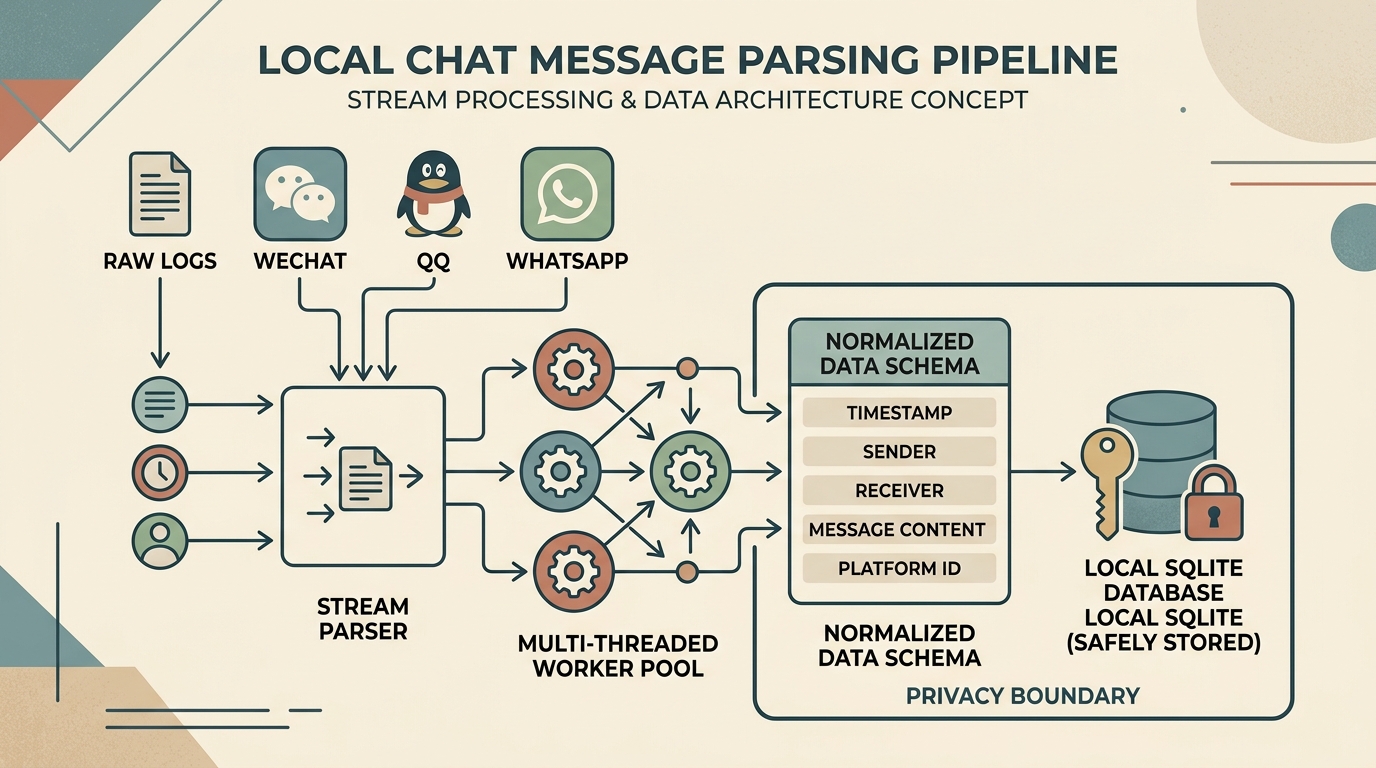
2.1 跨平台统一消息模型(Unified Normalized Schema)
无论是配合解密工具(如 EchoTrace)导出的微信数据库,还是 WhatsApp 的文本包,进入引擎的第一步均被规整为规范的标准化数据结构:
| 规范字段 | 数据类型 | 业务语义与索引设计 | 微信字段映射 | WhatsApp 字段映射 |
|---|---|---|---|---|
msg_id |
VARCHAR(64) |
消息全局唯一标识(主键) | MsgSvrID / localId |
消息行号哈希 |
platform |
VARCHAR(16) |
来源平台标识(建立复合索引) | 固定为 wechat |
固定为 whatsapp |
sender_id |
VARCHAR(64) |
发送者账号/脱敏 UID | StrTalker / Des |
电话号码/用户昵称 |
sender_name |
VARCHAR(128) |
发送者显示昵称 | NickName / 备注名 |
Contact Name |
content |
TEXT |
消息纯文本/富媒体元数据 JSON | 正文字符串 | 纯文本行 |
msg_type |
VARCHAR(16) |
消息分类(text/img/file等) |
Type 状态码映射 |
媒体标识判定 |
timestamp |
BIGINT |
Unix 毫秒时间戳(时序索引) | CreateTime 转换为秒/毫秒 |
解析本地化时间字符串 |
is_group |
BOOLEAN |
是否群聊(0/1) |
判断 talker 是否含 @chatroom |
判断群组 JID 标识 |
group_id |
VARCHAR(64) |
所属群聊唯一 ID(分区核心键) | chatroom_name |
Group ID |
2.2 百万级消息的高性能流式批处理
许多 Electron 应用被诟病内存占用巨大,根本原因在于一次性将整个数十万行的 JSON/CSV 加载进 V8 内存堆。
ChatLab 底层采用了基于 Node.js Stream / C++ Worker 线程池的流式解析架构:
1. 分块流式读取(Chunked Stream Reading):以固定 Buffer 大小(如 64KB)逐行分块读取原始文件,内存开销恒定在 50MB 以内;
2. 多线程工作池(Worker Pool):利用独立工作线程进行正则拆解、时间戳归一化和表情包转义,充分利用多核 CPU;
3. 批量事务入库(Batch Transaction Insert):采用 SQLite 的 BEGIN TRANSACTION 与预编译参数批量提交(每批次 5,000~10,000 条),避免单条插入引发磁盘 I/O 剧烈抖动,使得百万级消息在普通笔记本上可在数秒内完成初始化索引。
三、社交智能体:10+ Function Calling 工具链与动态 SQL 调度
如果仅仅是一个本地 SQLite 浏览器,ChatLab 充其量算是一个优秀的客户端。其真正让人耳目一新的地方,在于将 AI Agent 与本地数据库引擎的深度融合。
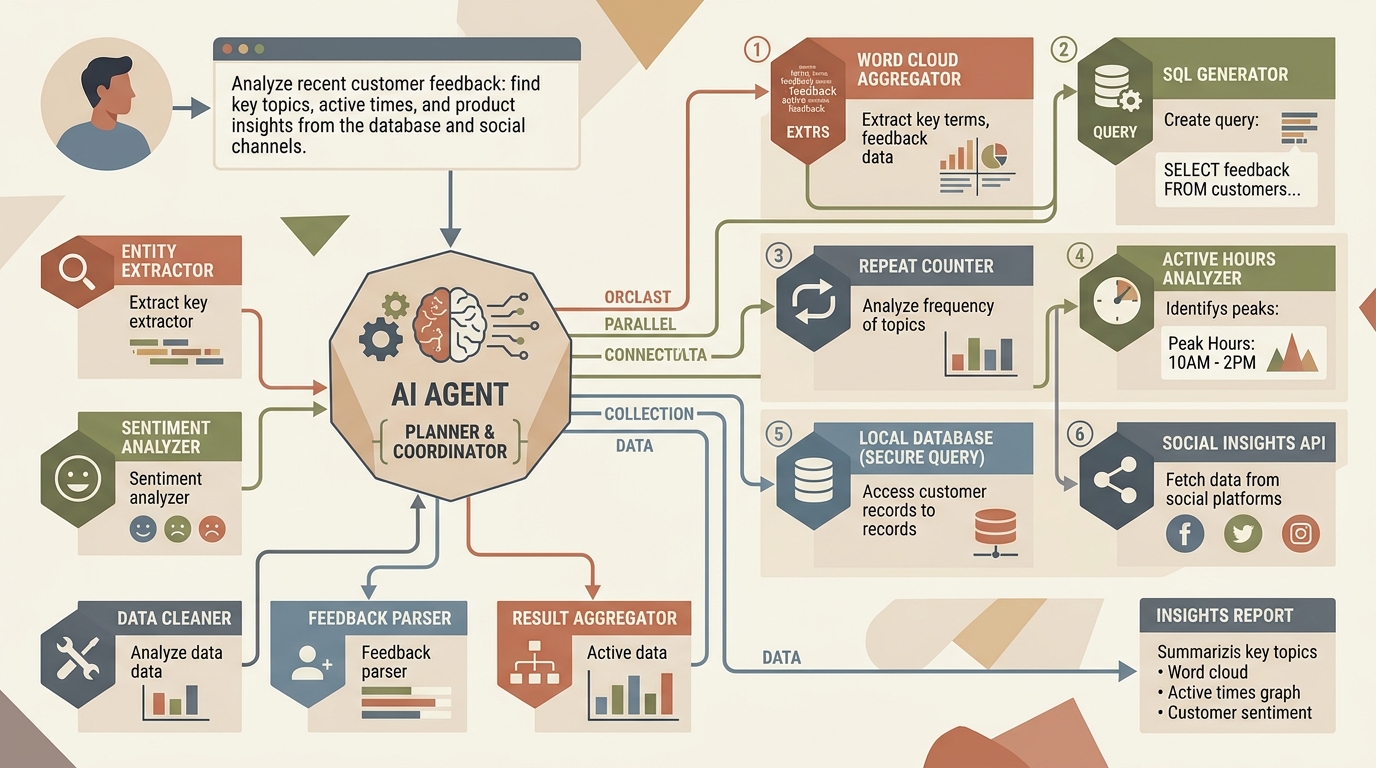
3.1 从自然语言到安全受控的 SQL 查询
传统 Text-to-SQL 方案在端侧应用中存在致命短板:大模型经常捏造非预期字段(Hallucination),甚至可能生成危险的修改删除语句(如 DROP TABLE、UPDATE)。
ChatLab 在本地 Agent 层设计了一套受限的动态工具调用沙箱(Function Calling Orchestration)。Agent 并非直接对原生数据库肆意妄为,而是通过 10+ 组经过严格工程封装的强类型工具进行调度:
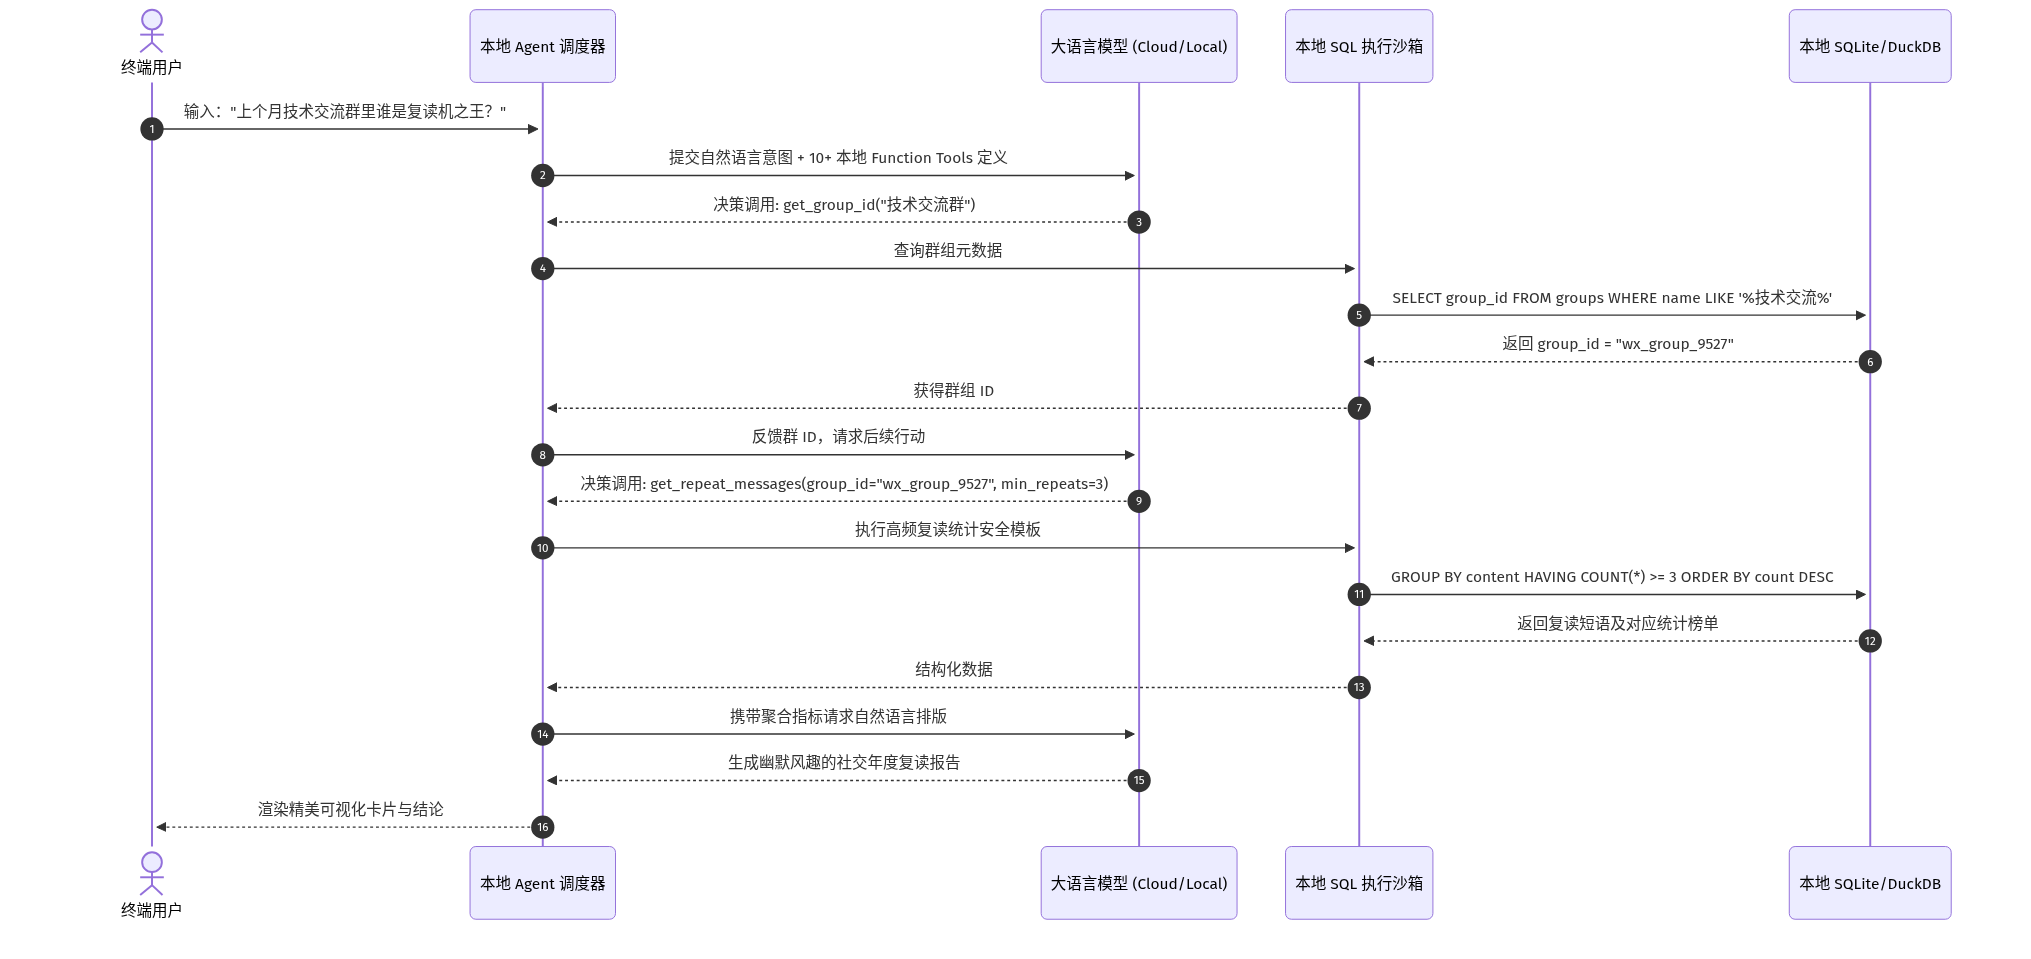
3.2 核心分析工具函数揭秘
在 ChatLab 内置的工具链中,以下几类高频分析工具最受用户欢迎:
1. get_most_active_users(话痨排行榜):支持按指定日期范围、按周/月滑动窗口,统计指定群聊中发言次数、发消息总字符数排名前 N 的群友;
2. get_repeat_messages(复读机检测算法):通过过滤字数较短(如不超过 30 字符)的纯文本消息,对内容进行哈希或完全匹配聚合,揪出群内被大家疯狂 "+1"、"确实"、"妙啊" 的经典社交梗;
3. get_active_hours_distribution(夜猫子时段分布):提取消息时间戳的小时特征(0~23 时),通过按小时分桶聚合计算群聊活跃峰值,识别谁总是在凌晨 3 点参与技术激烈讨论;
4. extract_topic_keywords(高频词拓扑聚类):结合本地结巴分词(Jieba)或分词 Worker,剔除通用停用词后抽取群聊高频名词,快速勾勒出该群组近期的核心关注焦点(如“K8s”、“DeepSeek”、“重构”)。
四、工业级实战:端侧数据模型与本地 Agent 工具模拟
为了让大家清晰地理解 ChatLab 底层的数据规整与 Agent 工具调用实现,我们编写了一套精简但具备完整闭环逻辑的实战代码(可直接使用 Python 3 原生运行,无外部重依赖):
#!/usr/bin/env python3
"""
ChatLab 核心架构模拟实验:

1\. 异构聊天记录向统一 NormalizedMessage Schema 映射

2\. SQLite 本地流式分批写入与高性能索引构建

3\. 本地 Function Calling Agent 工具集与受控执行沙箱
"""

import sqlite3
import json
import time
from typing import List, Dict, Any
from dataclasses import dataclass, asdict

@dataclass
class NormalizedMessage:
    msg_id: str
    platform: str          # wechat | qq | whatsapp
    sender_id: str
    sender_name: str
    content: str
    msg_type: str          # text | image | file | emoji
    timestamp: int         # unix timestamp in seconds
    is_group: bool
    group_id: str = ""
    group_name: str = ""

def init_local_database(db_path: str = ":memory:") -> sqlite3.Connection:
    conn = sqlite3.connect(db_path)
    cur = conn.cursor()
    # 建立高性能聊天明细表与多维时序复合索引
    cur.execute("""
    CREATE TABLE IF NOT EXISTS chat_messages (
        msg_id TEXT PRIMARY KEY,
        platform TEXT NOT NULL,
        sender_id TEXT NOT NULL,
        sender_name TEXT NOT NULL,
        content TEXT NOT NULL,
        msg_type TEXT NOT NULL,
        timestamp INTEGER NOT NULL,
        is_group INTEGER NOT NULL,
        group_id TEXT,
        group_name TEXT
    )
    """)
    cur.execute("CREATE INDEX IF NOT EXISTS idx_group_time ON chat_messages(group_id, timestamp)")
    cur.execute("CREATE INDEX IF NOT EXISTS idx_sender_time ON chat_messages(sender_id, timestamp)")
    conn.commit()
    return conn

def stream_batch_insert(conn: sqlite3.Connection, messages: List[NormalizedMessage]):
    """流式批量插入,大幅降低磁盘 I/O 锁开销"""
    cur = conn.cursor()
    sql = """
    INSERT OR REPLACE INTO chat_messages
    VALUES (:msg_id, :platform, :sender_id, :sender_name, :content, :msg_type, :timestamp, :is_group, :group_id, :group_name)
    """
    cur.executemany(sql, [asdict(m) for m in messages])
    conn.commit()

class SocialAgentTools:
    """本地社交分析 Agent 暴露给 LLM 的受限安全工具库"""

    def __init__(self, conn: sqlite3.Connection):
        self.conn = conn

    def get_most_active_users(self, group_id: str, limit: int = 5) -> List[Dict[str, Any]]:
        """工具1:统计群聊中最活跃的发消息话痨榜"""
        cur = self.conn.cursor()
        query = """
        SELECT sender_name, COUNT(*) as msg_count
        FROM chat_messages
        WHERE group_id = ?
        GROUP BY sender_id
        ORDER BY msg_count DESC
        LIMIT ?
        """
        cur.execute(query, (group_id, limit))
        return [{"sender_name": r[0], "msg_count": r[1]} for r in cur.fetchall()]

    def get_repeat_messages(self, group_id: str, min_repeats: int = 2) -> List[Dict[str, Any]]:
        """工具2:挖掘群内高频复读机(同一短语连续或多次出现)"""
        cur = self.conn.cursor()
        query = """
        SELECT content, COUNT(*) as repeat_count
        FROM chat_messages
        WHERE group_id = ? AND msg_type = 'text' AND LENGTH(content) <= 30
        GROUP BY content
        HAVING repeat_count >= ?
        ORDER BY repeat_count DESC
        LIMIT 5
        """
        cur.execute(query, (group_id, min_repeats))
        return [{"content": r[0], "repeat_count": r[1]} for r in cur.fetchall()]

if __name__ == "__main__":
    db = init_local_database()
    now = int(time.time())
    # 模拟从解密源流式导入消息
    mock_messages = [
        NormalizedMessage("m1", "wechat", "u1", "张三", "收到,马上处理!", "text", now - 3600, True, "g_tech", "架构核心群"),
        NormalizedMessage("m2", "wechat", "u2", "李四", "+1", "text", now - 3500, True, "g_tech", "架构核心群"),
        NormalizedMessage("m3", "wechat", "u3", "王五", "+1", "text", now - 3400, True, "g_tech", "架构核心群"),
        NormalizedMessage("m4", "wechat", "u1", "张三", "PR 已合入,大家拉取验证下", "text", now - 3200, True, "g_tech", "架构核心群"),
        NormalizedMessage("m5", "wechat", "u2", "李四", "+1", "text", now - 3100, True, "g_tech", "架构核心群"),
    ]
    stream_batch_insert(db, mock_messages)

    tools = SocialAgentTools(db)
    print("=== [ChatLab 社交洞察] 活跃发言排行 ===")
    print(json.dumps(tools.get_most_active_users("g_tech"), ensure_ascii=False, indent=2))
    print("\n=== [ChatLab 社交洞察] 经典复读机排行 ===")
    print(json.dumps(tools.get_repeat_messages("g_tech"), ensure_ascii=False, indent=2))
运行输出:
=== [ChatLab 社交洞察] 活跃发言排行 ===
[
  { "sender_name": "李四", "msg_count": 2 },
  { "sender_name": "张三", "msg_count": 2 },
  { "sender_name": "王五", "msg_count": 1 }
]

=== [ChatLab 社交洞察] 经典复读机排行 ===
[
  { "content": "+1", "repeat_count": 3 }
]
通过这一受控架构,大模型只能通过结构化的工具获取聚合事实,既杜绝了恶意注入与 SQL 逃逸,又保证了万级、十万级甚至百万级聊天数据分析的极致响应效率。
五、技术落地与生产踩坑排查指南
在将 ChatLab 或类似本地聊天分析体系引入实际使用与二次开发过程中,开发者通常会面临以下技术挑战,建议在架构设计中提前防范:
1. 微信数据解密协同与版本兼容
- 现象:微信桌面客户端在升级版本后,其本地数据库加密格式或 Salt 生成规则可能发生微调,导致旧版解密工具失效;
- 对策:解密模块建议与 ChatLab 主分析器保持物理解耦。采用成熟的解密生态工具(如 EchoTrace)完成解密并导出为解密后的 SQLite 或 CSV 文件,ChatLab 仅负责读取解密后的产物,避免因微信反编译对抗导致分析主工程频繁崩溃。
2. 跨时区与本地时间戳漂移
- 现象:WhatsApp 与 Telegram 导出的文本通常为客户端所在系统的本地化格式(如
28/09/2026, 08:30 - Alice: Hello或[2026-09-28 08:30:15]),在跨国协作或跨时区群聊中极易发生时间错乱; - 对策:统一在 Worker 解析层将所有时间格式化为 UTC Unix 时间戳 存储。在前端呈现或根据“活跃时段”分析时,再根据用户当前浏览器环境的时区偏移量(
Intl.DateTimeFormat().resolvedOptions().timeZone)进行动态回算展示。
3. 多媒体、语音转文字与 OCR 成本平衡
- 现象:聊天记录中包含大量图片表情包、截图与语音文件。如果盲目对全量图片调用 VLM(如 GPT-4V)或音频 ASR 转换,不仅本地推理资源直接打满,还会产生高昂的 API 调用账单;
- 对策:实施分级懒加载与抽样策略。日常仅索引文本消息与文件元数据;仅当用户在自然语言中显式要求“分析某时间段截图中的错误码”时,Agent 才定向触发本地轻量级 OCR(如 Tesseract / PaddleOCR)对该条消息进行按需解析。
六、总结与展望
在当下大模型应用全面向云端集中的浪潮中,ChatLab 展现了一种弥足珍贵的架构清醒:并非所有数据都适合一股脑推向云端。越是与个人身份、日常社交深度绑定的高敏数据,越需要 Local-First 的本地架构来捍卫主权。
通过将高性能本地数据库、流式批处理管道与具备受限 Function Calling 的本地 Agent 编排紧密结合,ChatLab 为我们展示了端侧大模型落地的新范式。未来,随着小型化端侧语言模型(如 Qwen2.5-7B、Llama 3.2 等)在本地 NPU/GPU 上的普及,这套架构更将进一步进化为完全脱离公网网络的“100% 离线自主社交大脑”。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验:





