拒绝盲目堆架构:深入拆解 Milvus、Qdrant、Chroma 与 Pinecone 四大向量数据库的底层索引与选型边界
随着大语言模型(LLM)与企业知识库(RAG,检索增强生成)技术的全面铺开,高维向量检索已经从学术界的算法研究,跃升为每一个软件架构师必须正视的基础设施核心构件。
然而,在面对海量的文本分块、知识图谱以及多模态嵌入(Embeddings)时,很多研发团队往往陷入两种截然不同的极端误区:
1. 盲目迷信单机数据库的插件方案:认为直接给业务现有的 MySQL 增加全文索引,或者在 PostgreSQL 上挂一个 pgvector 扩展就能包治百病,结果在数据量突破百万级、并发检索并发上升时,CPU 瞬间被打到 100%,内存因为全表高维距离扫描频繁 OOM;
2. 过早引入重量级分布式组件:业务刚刚处于可行性验证(POC)阶段,总文档库不过几千篇,却立刻在 Kubernetes 集群上部署了一整套依赖 etcd、MinIO、Kafka/Pulsar 的分布式 Milvus 集群,导致集群维护成本与云资源账单甚至远超业务本身的商业价值。
到底什么是真正支撑高维向量检索的底层核心逻辑?在开源与商业化的浪潮中,Milvus、Qdrant、Chroma、Pinecone 这四大具有代表性的向量数据库各自的护城河是什么?面对具体的业务场景,架构师究竟该如何画出清晰的选型决策线?
本文将带你穿透概念炒作,从数学距离与索引拓扑的底层原理切入,全方位剖析各大向量数据库的技术精髓与生产落地边界。
一、高维空间的检索困境:为什么传统关系型数据库会失效?
在传统的数据库系统中,数据以标量(整数、浮点数、字符串、时间戳)形式存在。无论是 B+ Tree 还是 LSM Tree,其检索的核心逻辑都建立在全序关系(Total Order)的基础之上:即任意两个值之间都可以明确比出大小(>、<、=)。
通过二分查找,B+ Tree 可以在 $O(\log N)$ 的时间复杂度内完成毫秒级范围扫描或点查。
但一旦进入 AI 时代,Embedding 模型(如 OpenAI text-embedding-3-large、BGE-M3 等)将现实世界的非结构化语义映射为了 1536 维乃至 3072 维的密集浮点数向量。
在高维向量空间中,根本不存在一维的“大小排序”概念。我们要找的不再是“某个确定的值”,而是“在空间距离上最接近的 Top-K 个邻居”。
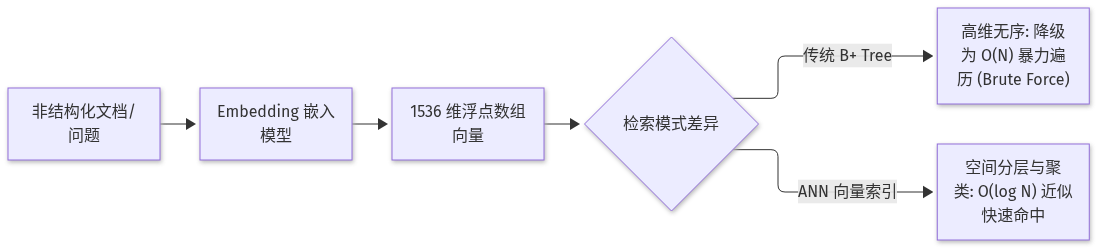
如果采用最原始的暴力扫描(KNN,K-Nearest Neighbors): - 每一次用户发起提问,系统必须将输入向量与库中存储的几百万个向量逐一计算点积或欧几里得距离; - 假设存储了 1000 万条 1536 维向量(以 float32 存储,单条约 6KB,仅原始向量数据就占 60GB 显存或内存),单次全表暴力比对将消耗数百亿次浮点运算(FLOPs),单次查询延迟将从毫秒级直接恶化到秒级乃至数十秒,并发吞吐量彻底崩盘。
因此,向量数据库的核心使命,就是引入 ANN(Approximate Nearest Neighbor,近似最近邻)算法,在允许牺牲 1%~5% 极微小召回率(Recall)的前提下,将检索吞吐提升数千倍,实现亚秒级甚至毫秒级的极速响应。
二、向量数据库的核心底座:ANN 索引机制与相似度度量原理
所有优秀的专用向量数据库,其灵魂都在于对高维空间几何关系的高效建模。
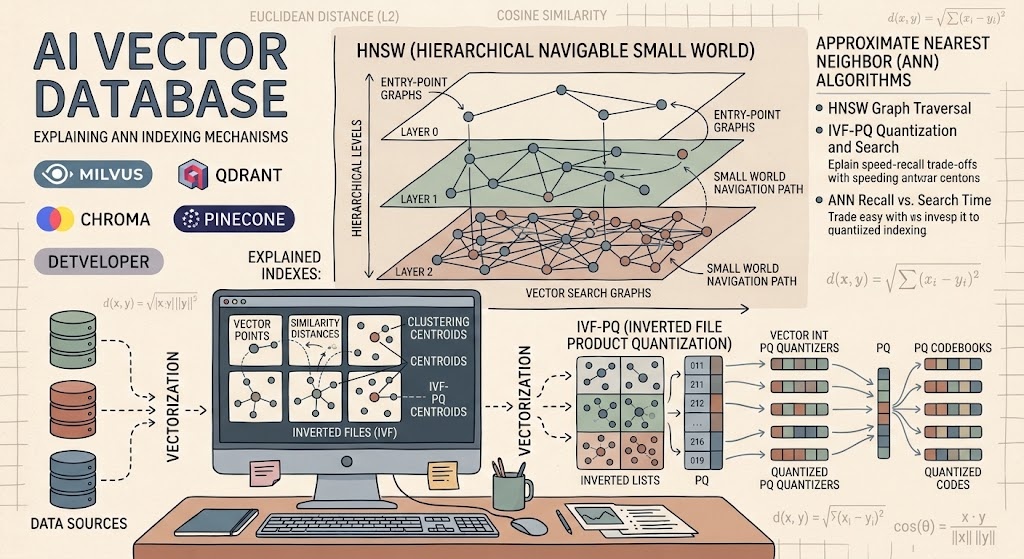
1. 相似度度量公式
在计算两个向量 $\vec{A}$ 与 $\vec{B}$ 的相似程度时,业界主要采用三种数学距离定义:
| 度量指标 | 数学表达式 | 特点与适用场景 |
|---|---|---|
| 余弦相似度 (Cosine) | $\cos(\theta) = \frac{\vec{A} \cdot \vec{B}}{|\vec{A}| |\vec{B}|}$ | 关注方向夹角,忽略向量绝对模长。是文本语义搜索、自然语言 RAG 的绝对主流 |
| 欧氏距离 (L2 Distance) | $D_{L2} = \sqrt{\sum_{i=1}^{n} (A_i - B_i)^2}$ | 绝对几何几何空间距离。常用于人脸识别、图像特征相似度匹配 |
| 点积内积 (Dot Product) | $\vec{A} \cdot \vec{B} = \sum_{i=1}^{n} A_i B_i$ | 计算速度最快。如果向量预先经过了 $L_2$ 归一化(模长为 1),点积等价于余弦相似度 |
2. 业界两大主流 ANN 索引核心机制
为了跳出暴力全表扫描的泥潭,现代向量数据库演化出了两大最具统治力的索引家族:
(1) HNSW(Hierarchical Navigable Small World,分层可导航小世界图)
- 核心思想:借鉴计算机网络跳表(Skip-List)的多层思想。最顶层(Layer 0)是稀疏的长距离高速导航节点,越往下层节点越密集;
- 寻路过程:查询时,先从顶层入口点进入,快速跨越大范围空间接近目标区域;然后逐层下沉至最底层局部小世界密集图,通过贪心算法快速锁定目标邻居;
- 优缺点:召回率极高(通常在 95%~99% 以上),查询延迟极低(通常数毫秒);但致命缺点是极度消耗内存,为了构建拓扑连接图,往往需要消耗原始数据 1.5~2.5 倍的额外内存开销。
(2) IVF-PQ(倒排量化索引:Inverted File with Product Quantization)
- 核心思想:由两部分组合而成。“IVF(倒排文件)”采用 K-Means 算法预先将空间划分为若干个聚类中心桶(Voronoi Cells),查询时只扫描距离最近的几个桶;“PQ(乘积量化)”则将高维向量切分为多个子向量,用简短的质心编码代替真实浮点数,实现高达 4x~16x 的内存大幅压缩;
- 优缺点:内存占用小、适合亿级以上的海量冷热混合数据存储;但在聚类边界处容易发生召回率抖动,建立索引消耗 CPU 计算资源较大。
三、四大主力向量数据库深度画像与内核解密
在当前的技术选型版图中,Milvus、Qdrant、Chroma 与 Pinecone 构成了覆盖不同场景维度的四大天王:
1. Milvus:云原生架构下的超大规模分布式巨无霸
由 Zilliz 开源的 Milvus 是目前整个向量搜索领域历史最悠久、架构最完备的企业级分布式系统。
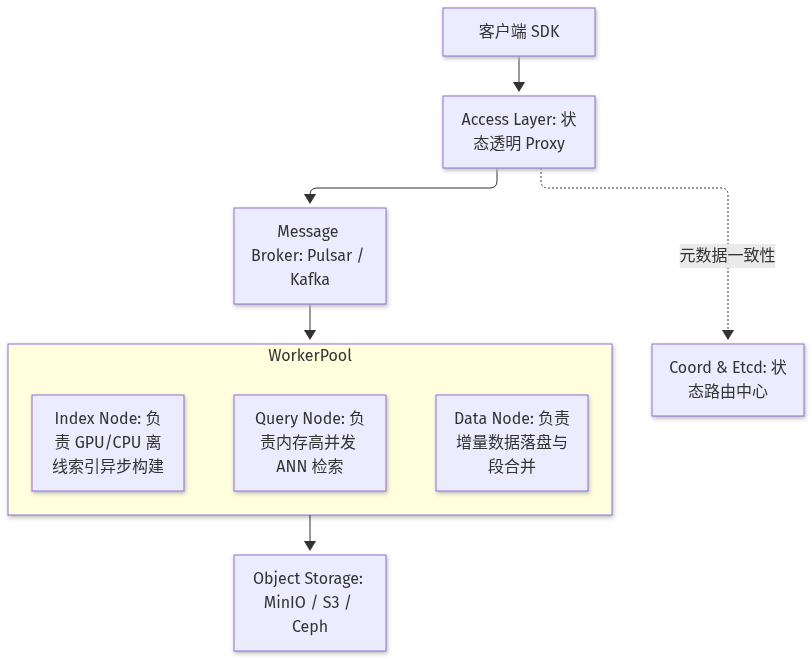
- 架构精髓:真正的微服务存算分离架构。将读取(Query Node)、写入(Data Node)、索引构建(Index Node)彻底解耦,通过 Kafka/Pulsar 进行日志流驱动。支持多副本高可用、分片(Sharding)、分段(Segment)合并与分布式调度;
- 硬件赋能:深度集成知名的 Knowhere 向量计算核心,原生支持 GPU 索引加速(RAFT、NV-Faiss)以及基于固态硬盘的 DiskANN 超大规模冷热分级检索;
- 适用边界:适合数据量在 千万到十亿、百亿级,拥有专业运维/DevOps 团队,对多租户隔离、金融级高可用有严格要求的超大型企业生产系统。
2. Qdrant:用 Rust 打造的极致性能与混合检索利器
Qdrant 是近年来在欧美技术圈声名鹊起的现象级开源项目。它使用 Rust 语言 从零构建,彻底摆脱了垃圾回收(GC)的停顿风险与多进程通信损耗。
- 标量预过滤(Payload Indexing)杀手锏:在真实的生产业务中,我们几乎不会做“纯向量搜索”,通常伴随着强烈的业务条件约束,例如:
向量相似度前10 并且 部门属于'研发部' 并且 创建时间在2026年之后。许多向量数据库做的是“先向量搜索 100 条,再过滤标量(Post-filtering)”,极易导致最终返回结果不足甚至为空。而 Qdrant 在底层实现了 自定义 Payload 索引与 HNSW 图的深度融合遍历(Pre-filtering),过滤精度与速度无与伦比; - 混合检索(Hybrid Search)原生支持:单实例原生同时支持密向量(Dense Vectors,表达深层语义)与稀疏向量(Sparse Vectors / BM25,表达精确关键字),内置 RRF(Reciprocal Rank Fusion)融合算法,极大简化了高质量知识库架构;
- 适用边界:追求单机/分布式的高性能、低内存开销,业务存在大量复杂权限/标签过滤的中大型 AI 智能体与商业级 RAG 系统。
3. Chroma:轻量级原型设计与开发者体验之王
Chroma 从诞生的第一天起,其设计哲学就是:让开发者在 3 分钟内把 RAG 跑起来。
# 极简示例:3 行代码构建一个就地向量知识库
import chromadb
client = chromadb.Client()  # 默认纯内存嵌入式运行
collection = client.create_collection("quickstart")
collection.add(
    documents=["SDKMAN is a tool for managing parallel versions of multiple Software Development Kits.", "Milvus is a distributed vector database."],
    ids=["doc1", "doc2"]
)
results = collection.query(query_texts=["How to manage JDK versions?"], n_results=1)
print(results['documents'])
- 轻量进程内驱动:底层基于 SQLite / DuckDB 存储元数据,基于轻量 C++ hnswlib 维护内存索引,支持完全的 In-Process 进程内运行,无需在后台单独部署数据库服务守护进程;
- 生态整合极致:与 LangChain、LlamaIndex、AutoGPT 等上层编排框架深度绑定,被全球无数黑客松与 AI 初创团队选为默认原型底座;
- 适用边界:概念验证(POC)、个人本地开发调试、客户端本地应用、桌面知识库以及数据量在 10 万以内 的轻量级 Agent 长期记忆体。
4. Pinecone:全托管 Serverless 范式的先驱
对于没有专职运维力量,或者希望快速将业务上线变现的硅谷团队而言,Pinecone 曾几乎是不二之选。
- 云原生全托管(Serverless):开发者不需要感知任何 Pod、节点、内存扩容或索引构建参数,只需要在 Web 控制台申请一个 API Key,调用 SDK 创建 Index,剩下的自动弹性伸缩、冷热存储调度均由后台透明承载;
- 开箱即用与 SLA 保障:支持毫秒级向量插入即读,提供高标准的生产级可用性 SLA;
- 适用边界与隐忧:极度依赖国外云服务,国内网络链路存在延迟;且其代码完全闭源,存在严重的 供应商锁定(Vendor Lock-in) 与数据合规顾虑;当向量规模膨胀到数千万级别时,每月产生的云托管费用远高于自建服务器成本。
四、四大向量数据库横向对比矩阵
为了让架构师在方案评审中能够一目了然,我们从技术维度对这四款代表性产品进行了全景比对:
| 评估维度 | Milvus | Qdrant | Chroma | Pinecone |
|---|---|---|---|---|
| 底层开发语言 | Go + C++ (Knowhere) | 纯 Rust | Python + C++ (hnswlib) | 闭源 (基于云原生架构) |
| 开源许可证 | Apache 2.0 | Apache 2.0 | Apache 2.0 | 商业闭源 SaaS |
| 部署复杂度 | 极高 (依赖 K8s/MinIO/Pulsar) | 中等 (单 Docker/集群极简) | 极低 (pip 安装即用) | 零 (纯云端 API) |
| 标量过滤能力 | 优秀 (支持复杂条件过滤) | 顶尖 (独创 Payload 图融合过滤) | 基础 (支持简单元数据过滤) | 良好 (支持元数据过滤) |
| 混合检索支持 | 支持 (2.4+ 丰富混合支持) | 原生原生支持 Dense+Sparse | 依赖外部扩展 | 支持混合检索 |
| 内存控制与优化 | 支持 DiskANN / 离线量化 | 内存管理出色,支持 mmap | 纯内存为主,大规模易膨胀 | 云端黑盒自动优化 |
| 单机并发吞吐 | 高 | 极高 (Rust 零成本抽象) | 中等 | 高 |
| 企业级数据规模 | 千万级 ~ 百亿级 | 百万级 ~ 数千万级 | 10 万 ~ 百万级 | 百万级 ~ 亿级 |
五、选型决策树:业务场景驱动的架构权衡指南
在技术选型中,没有最好的架构,只有最适合当前业务阶段与团队禀赋的架构。
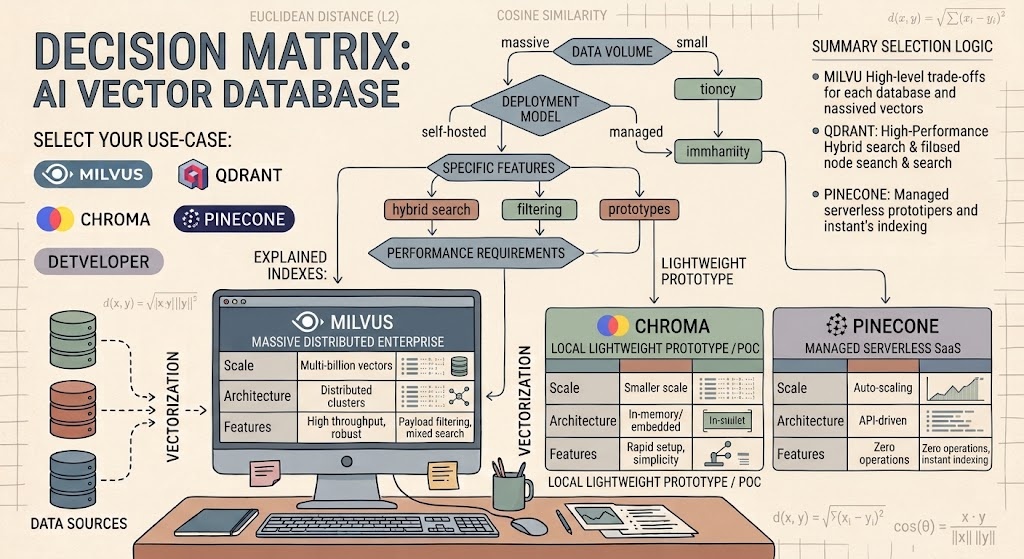
决策评估路径建议:
1. 第一层判断:我真的需要一个“独立的”专用向量数据库吗?- 如果团队已有成型的 PostgreSQL 基础设施,且总业务文档数在 50 万以下,并发检索 QPS < 50,请毫不犹豫优先选择 pgvector!- 收益:省去额外引入一套分布式中间件的运维灾难,无需处理业务关系库与向量库之间的双写一致性与分布式事务问题。
2. 第二层判断:处于技术调研还是生产落地阶段?- 如果只是跑 Demo、写论文、验证 Prompt 效果:选择 Chroma,零配置直接在脚本里运行;- 如果是出海业务、预算充沛、追求一周内快速交付上线:选择 Pinecone 或各开源产品的官方托管云(如 Zilliz Cloud、Qdrant Cloud)。
3. 第三层判断:生产环境自建与规模考量- 百万到千万级规模、需要高并发和复杂过滤:首选 Qdrant。单机启动一个 Docker 镜像即可支撑数百万数据,运维成本低、Rust 稳定性好,性价比与开发体验达到极佳平衡;- 千万以上、亿级分布式、跨多机房灾备的企业平台:选型成熟的 Milvus,通过专业基础设施团队做精细化运维与存储分层优化。
六、生产排坑与避坑铁律
在生产部署向量数据库时,以下三条硬性经验往往价值连城:
1. 严格评估内存消耗(Memory Sizing)
向量索引绝不能拍脑袋分配资源。以最为常用的 HNSW 索引为例,内存预估通用公式为:
$$\text{Memory} \approx N \times D \times 4\text{ bytes} \times 1.5 \sim 2.0$$
- 其中 $N$ 为向量总条数,$D$ 为向量维度(如 1536),单个 float32 占 4 个字节;
- 乘上 $1.5 \sim 2.0$ 的放大系数,用于容纳 HNSW 图拓扑边信息与运行时查询缓冲区;
- 警示:1000 万条 1536 维向量如果全内存跑 HNSW,至少需要准备 100GB~120GB 的物理内存!若预算受限,必须尽早开启 IVF-PQ 量化压缩或基于 NVMe 硬盘的 DiskANN/Mmap 机制。
2. 警惕“标量后过滤”导致的假性召回为空
在设计包含租户权限的系统时(如“只能检索张三可读的知识库”),务必确认底层数据库采用的是 Pre-filtering(预过滤)。如果是低效的 Post-filtering,当张三的文档在整体库中占比极低时,向量搜索返回的 Top-100 可能全被后续的业务权限校验过滤掉,最终向用户返回“未检索到相关内容”的误判。
3. 正确搭配混合检索(Hybrid Search)权重
纯向量语义检索擅长理解“意图”,但对特定专业名词、型号代码(如 iPhone 16 Pro Max 或型号 SKU-8902)的敏感度极低。在生产 RAG 场景中,建议采用“密集向量(0.7 权重)+ BM25 稀疏向量(0.3 权重)”的混合召回策略,才能兼顾泛化语义理解与精准参数过滤。
七、结语
向量数据库不是大模型时代的“银弹”,而是大模型与海量企业知识之间的“几何桥梁”。
从个人探索阶段的 Chroma,到性能平衡的 Qdrant,再到超大规模海量集群的 Milvus,理解它们的底层索引原理与架构取舍,才能让我们在构建 AI 系统时不盲从热点,写出既高效又经济的优雅架构。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: