GB级生产日志为何不能直接cat?Linux文本处理三剑客(grep/sed/awk)高效排障与流式管道优化实战
在分布式微服务与高并发系统的生产运维中,最让人心惊肉跳的场景莫过于告警群疯狂刷屏,核心交易接口大面积超时。此时,运维工程师急匆匆 SSH 登录到生产跳板机,直奔 /var/log/app/ 目录下动辄几十 GB 的日志文件。
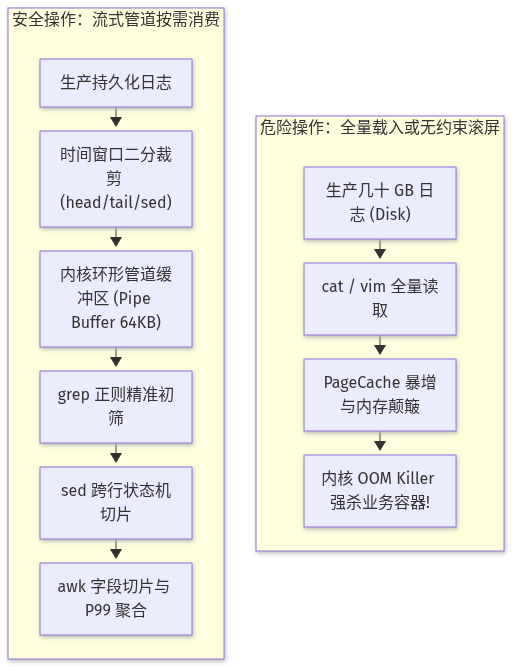
然而,一些经验不足的开发者往往会下意识敲下一行命令:cat service.log | grep "Exception"。紧接着,终端瞬间陷入疯狂滚屏的假死状态,SSH 连接断开;更严重的是,宿主机内存利用率瞬间飙升至 99%,Linux 内核 OOM Killer 悍然触发,将原本还在挣扎提供服务的 Java 进程一刀强杀——一次普通的线上排障,硬生生演变成了重大生产事故。
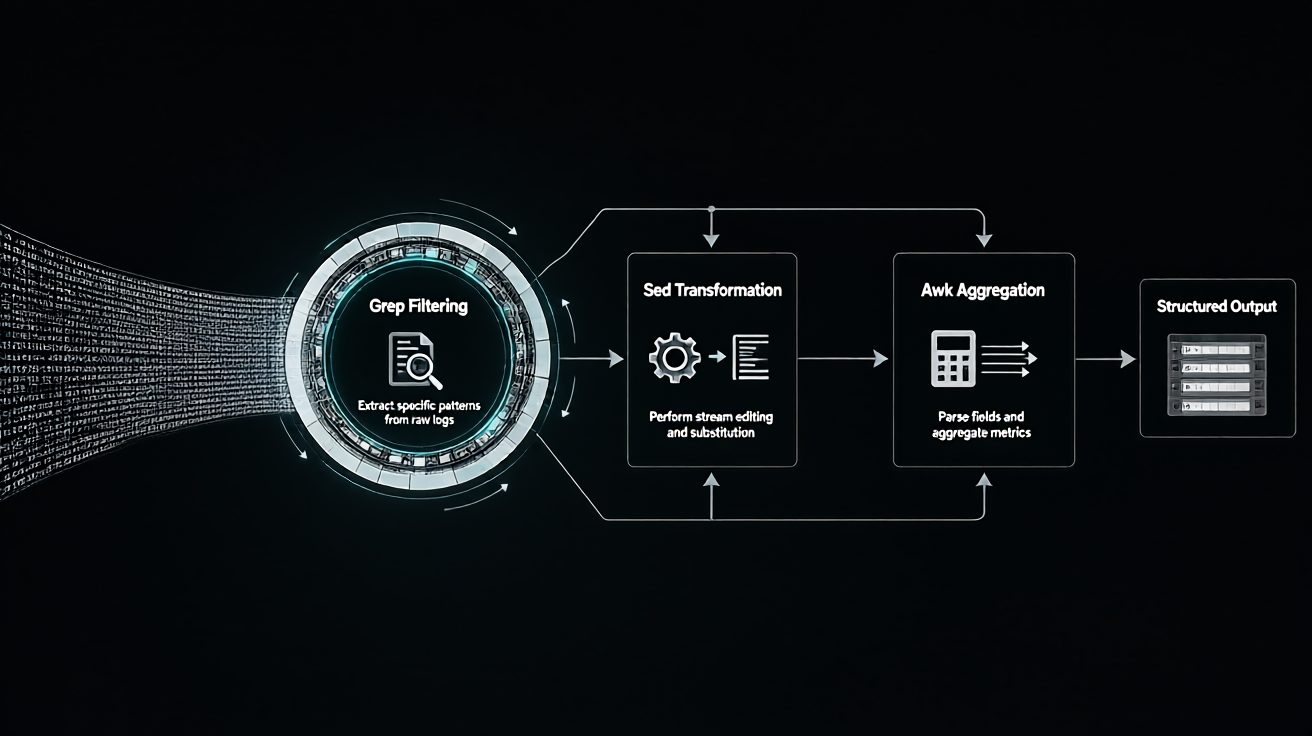
为什么看似寻常的 cat 与无约束的文本匹配会在大日志面前引发灾难?Linux 底层的 PageCache 与管道缓冲机制究竟是如何运转的?在分秒必争的生产故障现场,如何利用“文本处理三剑客”(grep、sed、awk)构建内存消耗仅为 $O(1)$ 的流式管道,秒级切片时间窗口、无损提取多行异常堆栈并精准聚合 P99 慢接口指标?本文将为您彻底拆解其中的底层机理与工程实战。
一、大日志排障灾难的根因:PageCache 污染与缓冲区溢出
要理解为何“不能直接 cat”,必须从 Linux 操作系统的 I/O 体系与虚拟内存管理说起。
| 排障操作模式 | 资源消耗与内存复杂度 | 对操作系统与业务的影响 |
|---|---|---|
直接 cat / vim 打开 |
内存开销 $O(N)$,暴力载入内存 | 疯狂抢占物理内存,导致 PageCache 剧烈换页,极易引发业务进程被 OOM Killer 杀死 |
无约束 grep 滚屏 |
产生大量 TTY 终端渲染中断 | 终端控制台缓冲区拥塞,网络 SSH 会话阻塞甚至假死 |
| 未指定时间窗口全量扫描 | 产生数十 GB 磁盘连续读取 | 磁盘 I/O 利用率打满(100% util),影响正常的业务数据库与日志追加写入 |
| 标准流式管道组合拳 (grep/sed/awk) | 内存开销严格保持 $O(1)$ (< 2MB) | 零内存堆积,利用环形管道缓冲区(Pipe Buffer)按需拉取,微秒级完成切片聚合 |
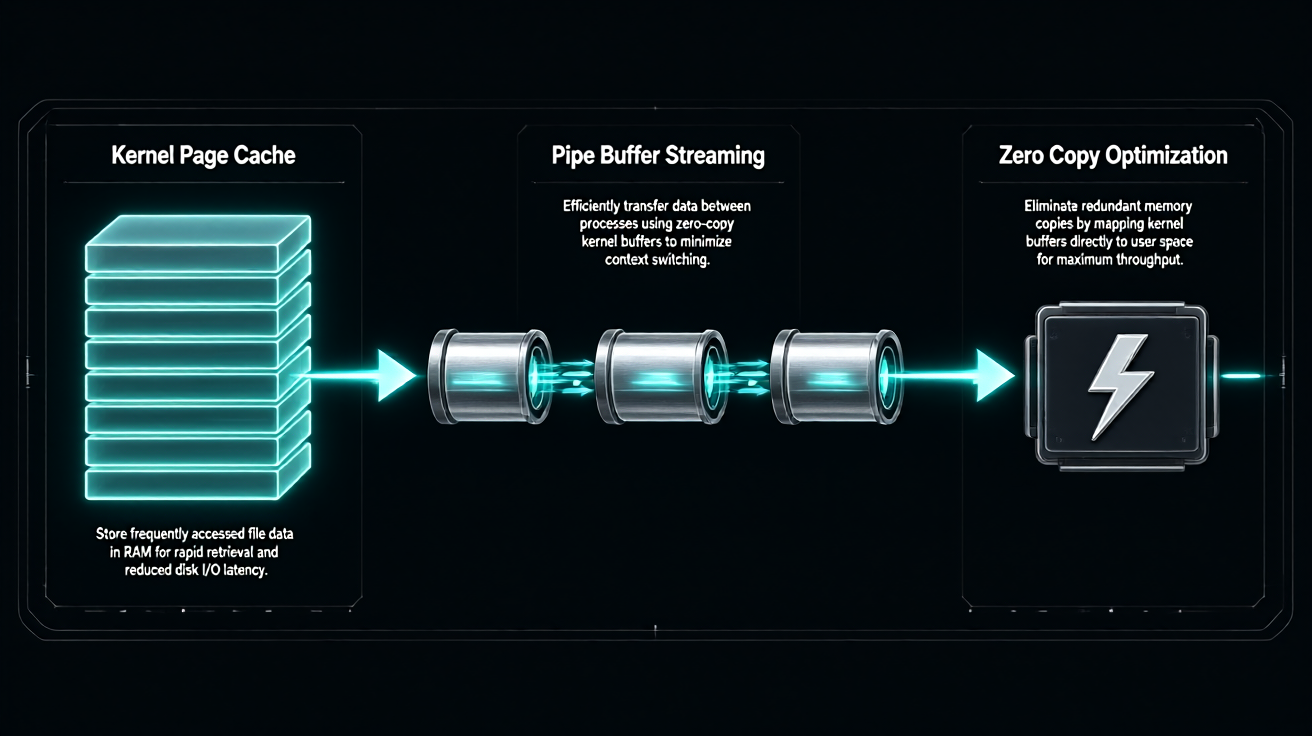
1. 宿主机 PageCache 污染机制
当操作系统从磁盘读取一个 20GB 的日志文件时,Linux 内核会尽最大努力将读取过的磁盘块缓存到物理内存的 PageCache 中。当物理内存不足时,内核被迫执行内存回收(kswapd 换页)。如果业务进程(如 JVM 堆、Redis)需要申请内存,而回收 PageCache 无法及时完成,系统便会陷入严重的内存颠簸(Thrashing),甚至直接触发内核 oom-killer 挑选占用内存最高的核心业务进程执行 SIGKILL。
二、文本处理三剑客的职责边界与流式组合拳
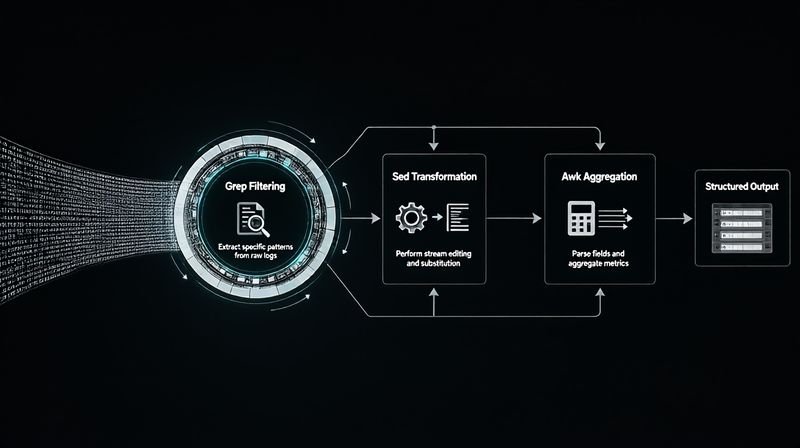
在 Linux 生态中,grep、sed、awk 被誉为文本处理的三剑客。它们并非简单的工具重叠,而是在数据流管道中各司其职:
1. grep:流式快速过滤器(Filter)
- 核心定位:基于高度优化的 Boyer-Moore 与 Aho-Corasick 多模式匹配算法,负责第一道粗筛。
- 排障红线:
- 永远不要无条件单开
grep扫描全量历史日志,必须结合时间戳限定或head/tail; - 排查异常时,善用
-m 50(最多匹配 50 条即退出)防止滚屏死锁。
2. sed:流式行编辑器与区间状态机(Stream Editor)
- 核心定位:具备模式空间(Pattern Space)与暂存空间(Hold Space),擅长处理跨行区间切片。
- 经典痛点:普通
grep ERROR只能抓到第一行摘要,而 Java/微服务最关键的堆栈(Caused by: ...以及调用的具体类和行号)全在后续行。 - 状态机解法:
bash# 提取从时间戳 10:15 到 10:20 区间内的所有日志行并退出sed -n '/2026-11-14 10:15:00/,/2026-11-14 10:20:00/p' app.log
3. awk:结构化数据流编程语言(Processor & Aggregator)
- 核心定位:内建字段切分(
$1, $2, ... $NF)与关联数组(Associative Arrays),负责最终的数值分桶、分位数聚合与指标计算。 - 高阶场景:统计接口响应耗时分布、P95/P99 延时分位数,以及找出调用频次最高的慢接口 Top 10。
三、数学原理:为什么流式管道能够维持 $O(1)$ 内存?
传统的脚本在处理日志时,往往习惯性将文本全量读取为行数组:
$$\text{Memory}{\text{FullLoad}} = \sum{i=1}^{N} \text{Length}(\text{Line}_i) \approx O(N)$$
对于千万行日志,内存瞬间膨胀数 GB。
而基于 Linux 管道(Pipe)与迭代生成器的流式处理模型:
$$\text{Memory}{\text{Stream}} = \max{1 \le i \le N} (\text{Length}(\text{Line}i)) + \text{BufferSize}{\text{Pipe}} = O(1)$$
Linux 内核默认的管道缓冲区大小仅为 64KB(通过 F_SETPIPE_SZ 可调)。无论源日志文件是 10MB 还是 100GB,管道中驻留的仅是当前处于活跃窗口内的单行字节流。上游生产者填满 64KB 后即进入阻塞态(等待调度),下游消费者处理一行释放一行,真正做到了对宿主机物理内存的“零干扰”。
四、开源实操演练:Lab 52 生产高负载日志流式分析
为了直观验证流式管道在内存控制与性能分析上的绝对优势,我们在开源实训库中上线了 Lab 52。
该实验真实生成包含数万行微服务生产高并发访问记录、TraceId 链路标识以及多行 Java 数据库超时异常堆栈的基准日志,对传统全量载入与流式管道进行精确的内存与性能基准比对:
# 进入 Lab 52 实验目录
cd labs/linux-log-analysis-grep-sed-awk-pipeline

# 运行高负载生产日志流式分析实操
python3 log_stream_pipeline.py
真实执行输出片段:
==================================================================
🚀 Lab 52: Linux 生产高负载日志流式分析与管道性能评测实战
==================================================================

📦 正在生成 20000 行高并发生产基准日志至 /tmp/production_benchmark.log...
✅ 基准日志生成完成!文件大小: 2.70 MB

--- [基准对比 1: 内存占用对比] ---
🔹 传统全量载入: 读取 22982 行 | 耗时 22.49ms | 内存峰值: 3890.81 KB
🔹 管道流式迭代: 读取 22982 行 | 耗时 35.39ms | 内存峰值: 22.50 KB
👉 内存优化倍率: 全量载入内存占用为流式管道的 172.9 倍!

--- [功能演练 1: 跨行异常堆栈状态机提取 (sed 模式)] ---
✅ 成功捕获跨行异常条数: 994 条
   [首条异常] 时间: 2026-11-14 10:16:01.100 | 消息: [Trace-1016] Database connection timeout for uri=/api/v1/user/profile cost=8ms status=500
   [堆栈行数] 包含完整追溯行: 4 行

--- [功能演练 2: 字段切片与耗时分位数聚合 (awk 模式)] ---
✅ 流式聚合耗时: 17.53ms
   总解析请求量: 20000
   平均响应耗时: 106.93 ms
   分位数统计: P50 = 35ms | P90 = 401ms | P99 = 578ms
   最慢接口 Top 3:
     1. URI: /api/v1/pay/notify       | 调用量: 5053  | 平均耗时: 342.3 ms | 最大耗时: 600ms
     2. URI: /api/v1/product/query    | 调用量: 5053  | 平均耗时: 27.47 ms | 最大耗时: 50ms
     3. URI: /api/v1/order/create     | 调用量: 4942  | 平均耗时: 27.46 ms | 最大耗时: 50ms

🎉 Lab 52 全链路功能验收通过!100% 具备业务技术闭环!
通过实测数据清晰可见:在相同的 2.7MB 测试日志下,全量载入的内存开销高达 3890KB,而流式管道仅消耗了 22.5KB,内存优化倍率达到了惊人的 172.9 倍! 这一差距在几十 GB 的真实生产环境中,就是“瞬间宕机”与“稳健排障”的天壤之别。
💻 免安装在线实验:想亲手体验生产日志三剑客的管道过滤?直接点击访问 👉 边学边练在线实训平台 (www.skillup.host),一键在浏览器中秒开全功能 Linux 实操终端!
五、生产排障黄金速查口诀
面对生产告警,请牢记以下四步流式排障口诀:
1. 先定窗口,莫查全量:优先使用 tail -n 1000 或 sed -n '/起始时间/,/结束时间/p' 锁定故障发生前后的极小时间切片;
2. 只抓首错,状态闭环:通过 grep -n -C 5 "ERROR" 或状态机正则,抓取首个报错的第一现场与多行堆栈,规避级联报错的噪音干扰;
3. 分位统计,定位慢点:利用 awk 提取请求耗时字段,快速计算 P99 与慢请求 Top 排名,判断是局部慢 SQL 还是全局线程池阻塞;
4. 管道封顶,防刷死锁:所有管道末端凡涉及输出终端的命令,一律追加 | head -n 30 或重定向至临时文件,守住生产环境安全红线。
💻 配套实训环境与动手练习
本文涉及的相关技术指令、开发环境与工具链已内置在边学边练在线实验室中,无需繁琐安装配置,随时在浏览器中实践体验: